 yuzheng
翻译与阅读笔记
CUDA 矩阵乘法优化:从朴素 Kernel 到接近 cuBLAS
沿 Simon Boehm 的工作日志,理解合并访存、共享内存、寄存器分块与线程束级优化。
一条可追踪的优化路径
矩阵乘法是观察 GPU 性能瓶颈的一个具体入口。同一个计算式,在访存顺序、数据复用和线程分工改变后,运行速度可能出现很大差异。本文依据 Simon Boehm 的 CUDA SGEMM 工作日志及已有译注,整理从朴素 Kernel 到线程束分块的优化过程。
下面的性能数字来自原文给定的测试环境,用于比较各次改动的效果,并不是跨 GPU、跨矩阵尺寸的性能承诺。阅读代码时,重点观察数据从全局内存到共享内存、再到寄存器的移动过程。
| Kernel 版本 | 核心优化策略 | 计算性能 (GFLOPs/s) | 相对 cuBLAS 比例 |
|---|---|---|---|
| 1: Naive | 朴素实现(单线程负责单输出) | 309.0 | 1.3% |
| 2: GMEM Coalescing | 全局内存合并访问 | 1,986.5 | 8.5% |
| 3: SMEM Caching | 共享内存分块缓存(Cache Blocking) | 2,980.3 | 12.8% |
| 4: 1D Blocktiling | 一维分块(单线程计算一列结果) | 8,474.7 | 36.5% |
| 5: 2D Blocktiling | 二维分块(寄存器外积,大幅提升算术强度) | 15,971.7 | 68.7% |
| 6: Vectorized Access | 向量化访存(float4 128 位宽存取与 As 转置) | 18,237.3 | 78.4% |
| 9: Autotuning | 超参数自动化调优 | 19,721.0 | 84.8% |
| 10: Warptiling | 线程束级分块(规避 Bank 冲突与寄存器缓存局部性) | 21,779.3 | 93.7% |
| 0: cuBLAS | NVIDIA 库基准 (FP32) | 23,249.6 | 100.0% |
注: 上述基准为标准 FP32 纯浮点运算。在实际场景中,若开启 TF32 或 BF16 精度,cuBLAS 将直接启用 Tensor Core(张量核心),算力将进一步提升 2.5 至 3.5 倍。
1. Kernel 1: 朴素实现
在 CUDA 编程模型中,计算组织为一个三级金字塔结构:
- 每次启动一个 CUDA Kernel,都会创建一个新的 网格(Grid) ;
- 每个 Grid 由多个 线程块(Block) 组成;
- 每个 Block 包含最多 1,024 个独立的 线程(Thread) 。同一 Block 内的线程可以访问同一块片上共享内存(SMEM)。
每个 Block 内的线程组织可通过 blockDim 向量(包含 x, y, z 三个维度)进行配置,如下图所示:
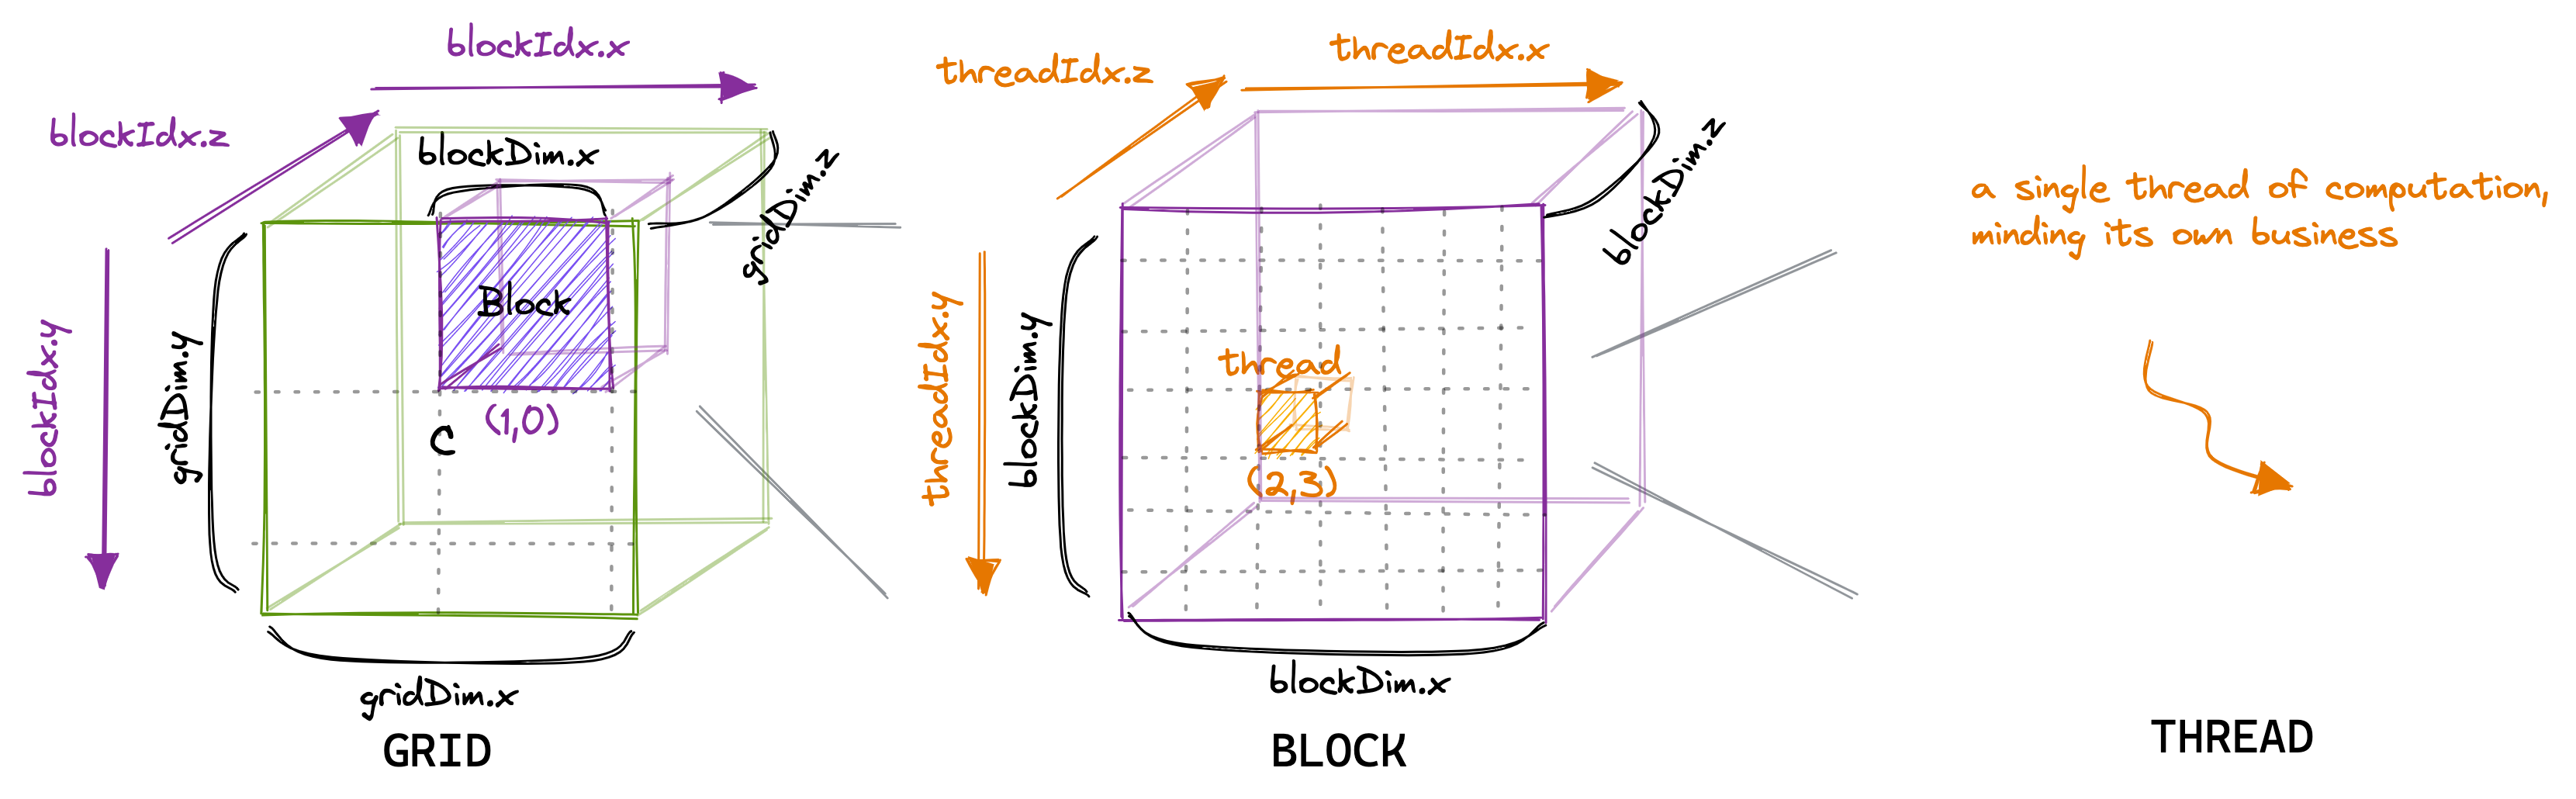
图 1 CUDA 线程层次结构:Grid、Block 与 Thread 的多维组织形式
在首个朴素实现中,我们建立最简单的一对一映射: 每个线程负责计算结果矩阵 C 中的唯一一个元素 。该线程提取矩阵 A 的对应行与矩阵 B 的对应列,执行点积累加,最后写入 C。由于每个 C 元素仅由一个线程独占写入,无需任何线程间同步操作。
启动配置如下:
// 1. 确定网格 (Grid) 尺寸:
// CEIL_DIV(x, y) = (x + y - 1) / y,向上取整确保覆盖整块矩阵
// 矩阵 C 大小为 M x N,每个 Block 覆盖 32x32 个元素,因此沿 M 轴分配 CEIL_DIV(M, 32) 个 Block,沿 N 轴分配 CEIL_DIV(N, 32) 个 Block
dim3 gridDim(CEIL_DIV(M, 32), CEIL_DIV(N, 32), 1);

// 2. 确定线程块 (Block) 尺寸:
// 32 * 32 = 1024 个线程,正好达到硬件单 Block 允许的最大线程数 (1024)
dim3 blockDim(32, 32, 1);

// 3. 异步启动 GPU 上的 Kernel:
// 该函数在 Host (CPU) 端调用后会立刻返回,GPU 驱动负责将计算任务分发到各个流式多处理器 (SM)
sgemm_naive<<<gridDim, blockDim>>>(M, N, K, alpha, A, B, beta, C);
Kernel 核心实现代码:
__global__ void sgemm_naive(int M, int N, int K, float alpha, const float *A,
                            const float *B, float beta, float *C) {
  // 1. 全局坐标计算:每个线程从内置变量中读取所属 Block 索引与线程内部索引
  // x 为当前线程负责的矩阵 C 的绝对行坐标 (0 ~ M-1)
  const uint x = blockIdx.x * blockDim.x + threadIdx.x;
  // y 为当前线程负责的矩阵 C 的绝对列坐标 (0 ~ N-1)
  const uint y = blockIdx.y * blockDim.y + threadIdx.y;

  // 2. 边界检查:若矩阵尺寸 M 或 N 不是 32 的整数倍,防止边缘线程越界访问非法显存
  if (x < M && y < N) {
    float tmp = 0.0f; // 私有标量寄存器,用于在局部累加点积中间结果

    // 3. 沿公共维度 K 执行向量点积:
    // 当前线程依次加载矩阵 A 的第 x 行元素,以及矩阵 B 的第 y 列元素
    for (int i = 0; i < K; ++i) {
      // A[x * K + i]:A 矩阵采用行主序连续存储,行偏移为 x*K,列偏移为 i
      // B[i * N + y]:B 矩阵同样为行主序,访问同一列不同行时产生高达 N 个浮点数的大跨步 (Stride)!
      tmp += A[x * K + i] * B[i * N + y];
    }

    // 4. 写回全局显存:完成公式 C = alpha * (A @ B) + beta * C 的更新
    C[x * N + y] = alpha * tmp + beta * C[x * N + y];
  }
}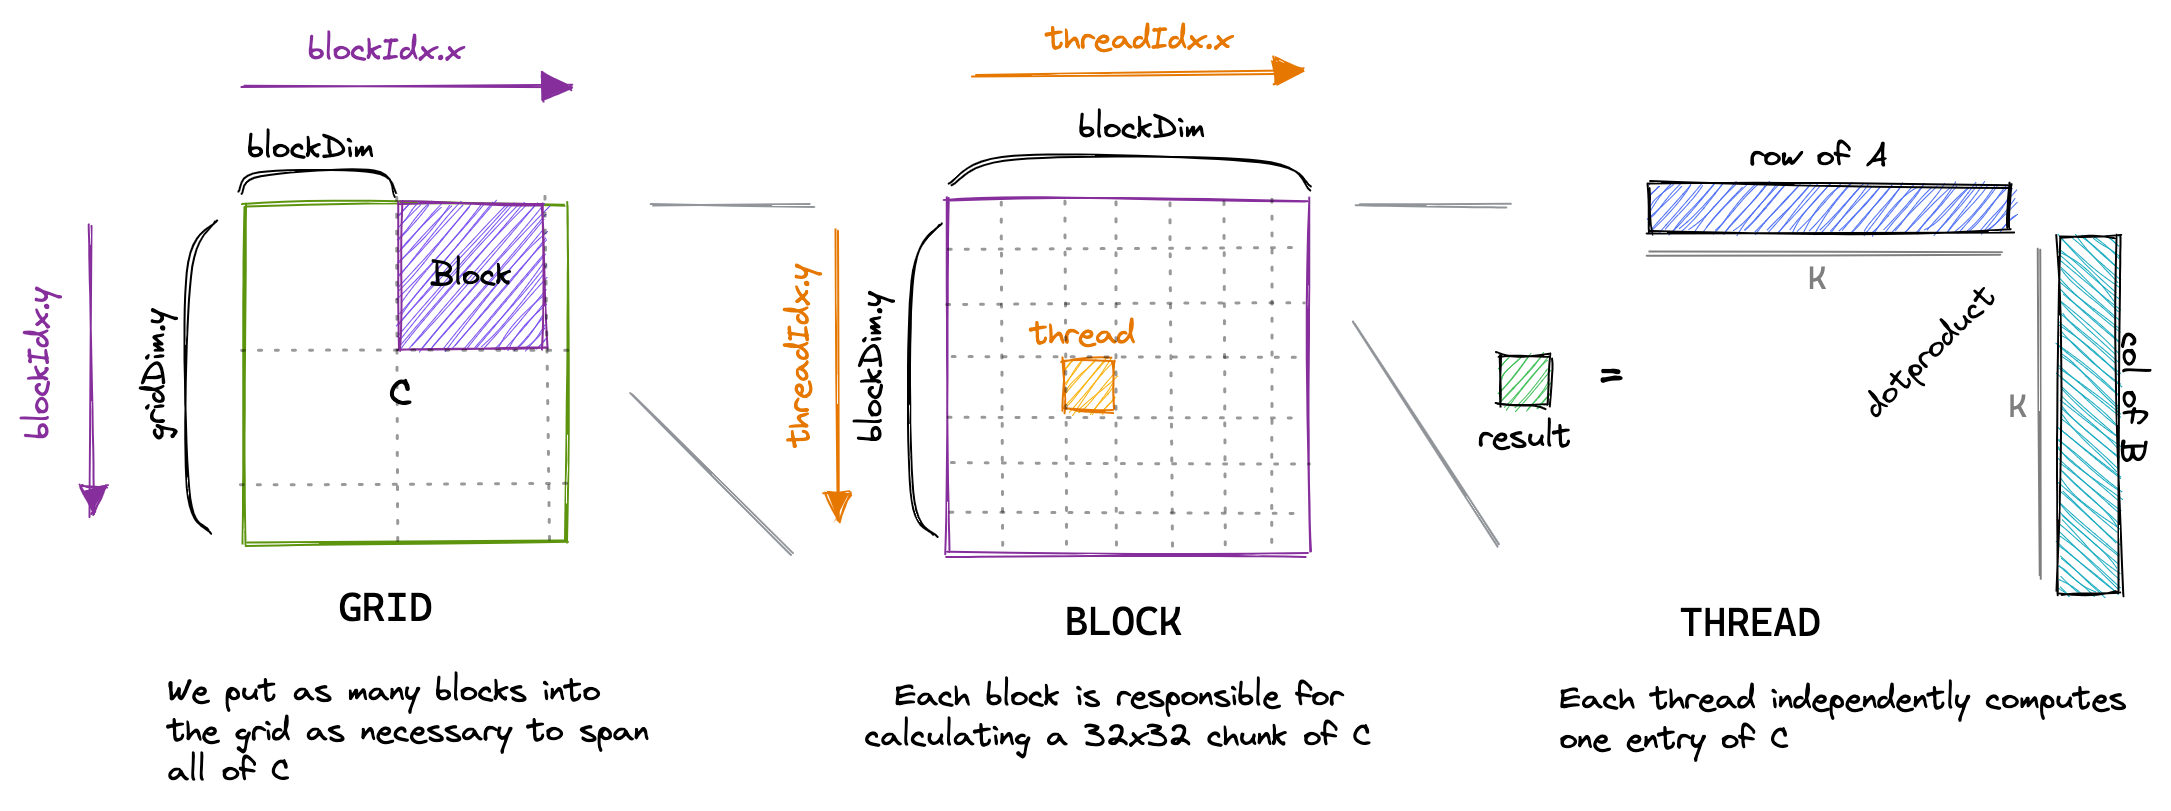
图 2 朴素 Kernel 映射:每个线程通过独立的行列点积计算 C 的单个元素
分块量化误差(Tile Quantization):
若矩阵尺寸不能被 Block 尺寸整除,必须启动额外的边缘 Block 来处理余数。此时边缘 Block 无法跑满全部 1,024 个线程,产生硬件利用率浪费。 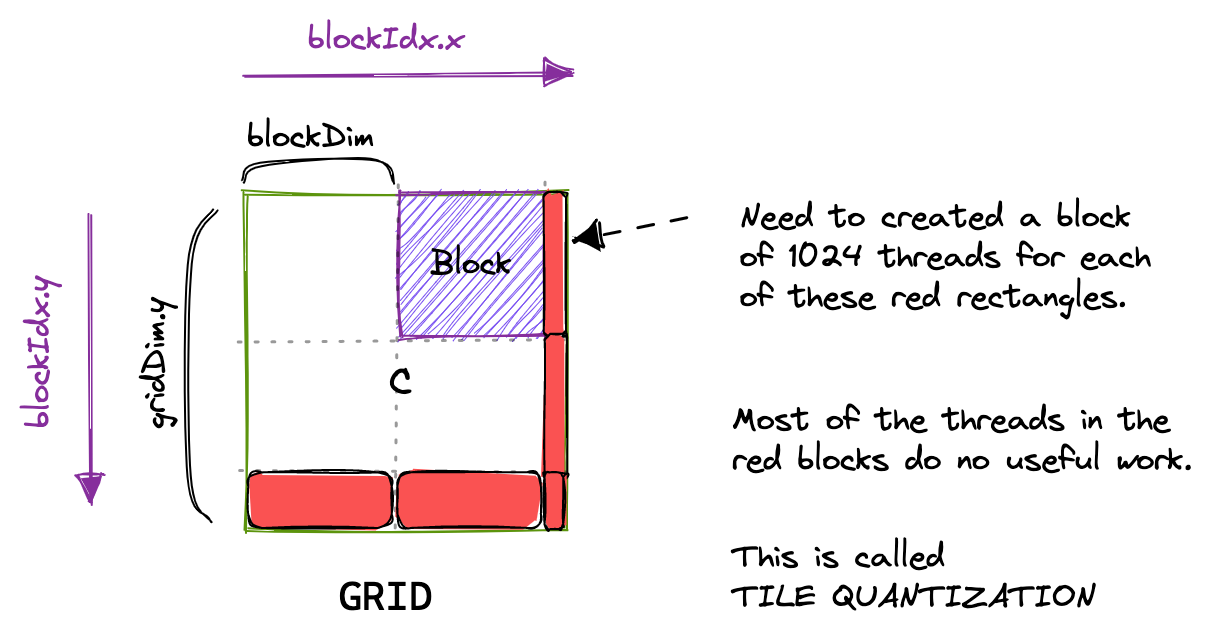
第一性原理:理论性能与最快运行时间下界估算
在 A6000 GPU 上计算两个 的单精度浮点矩阵相乘,单次 Naive Kernel 运行约耗时 0.5 秒 。我们先通过“草稿纸演算”推算硬件的物理极限:
- 总浮点计算量 (FLOPs) :每个 C 元素需要 4092 次乘加(FMA 算作 2 次浮点),总计算量为:
2 * 4092³ + 4092² = 137.4 GFLOPs - 最小理论读取数据量 :矩阵 A、B、C 至少各完整读一次:
3 * 4092² * 4 Bytes = 201 MB - 最小理论写出数据量 :矩阵 C 写出:
4092² * 4 Bytes = 67 MB
因此, 268 MB 是任何算法在理论具备无限缓存下,与显存(Global Memory)交互的数据吞吐下限。
硬件标称参数:RTX A6000 具备 30 TFLOPs/s 的标称 FP32 算力峰值(Boost 频率下最高 38.7 TFLOPs)以及 768 GB/s 的显存带宽:
- 按峰值算力计算,纯数学计算仅需:
137 GFLOPs / 30 TFLOPs = 4.5 ms; - 按峰值带宽计算,数据搬运仅需:
268 MB / 768 GB/s = 0.34 ms。
核心洞见: 纯数学运算时间约是理论访存时间的 13 倍 。这意味着只要我们的数据复用率达到 10 倍以上, 最终的高度优化 Kernel 必然是计算受限(Compute-bound)任务 ,绝不应受制于显存瓶颈。
朴素 Kernel 的低效内存访问模式
为什么 Naive 实现仅有 309 GFLOPs(只有标称性能的 1%)?
同一 Block 内的两个相邻线程 (0, 0) 和 (0, 1) 会读取相同的 B 列,但各自读取完全不同的 A 行。在无缓存复用的极端情况下,每个线程都要从显存中读取 2 * 4092 + 1 个浮点数。由于总共有 个线程,这引发了高达 548 GB 的恐怖显存访问洪流。
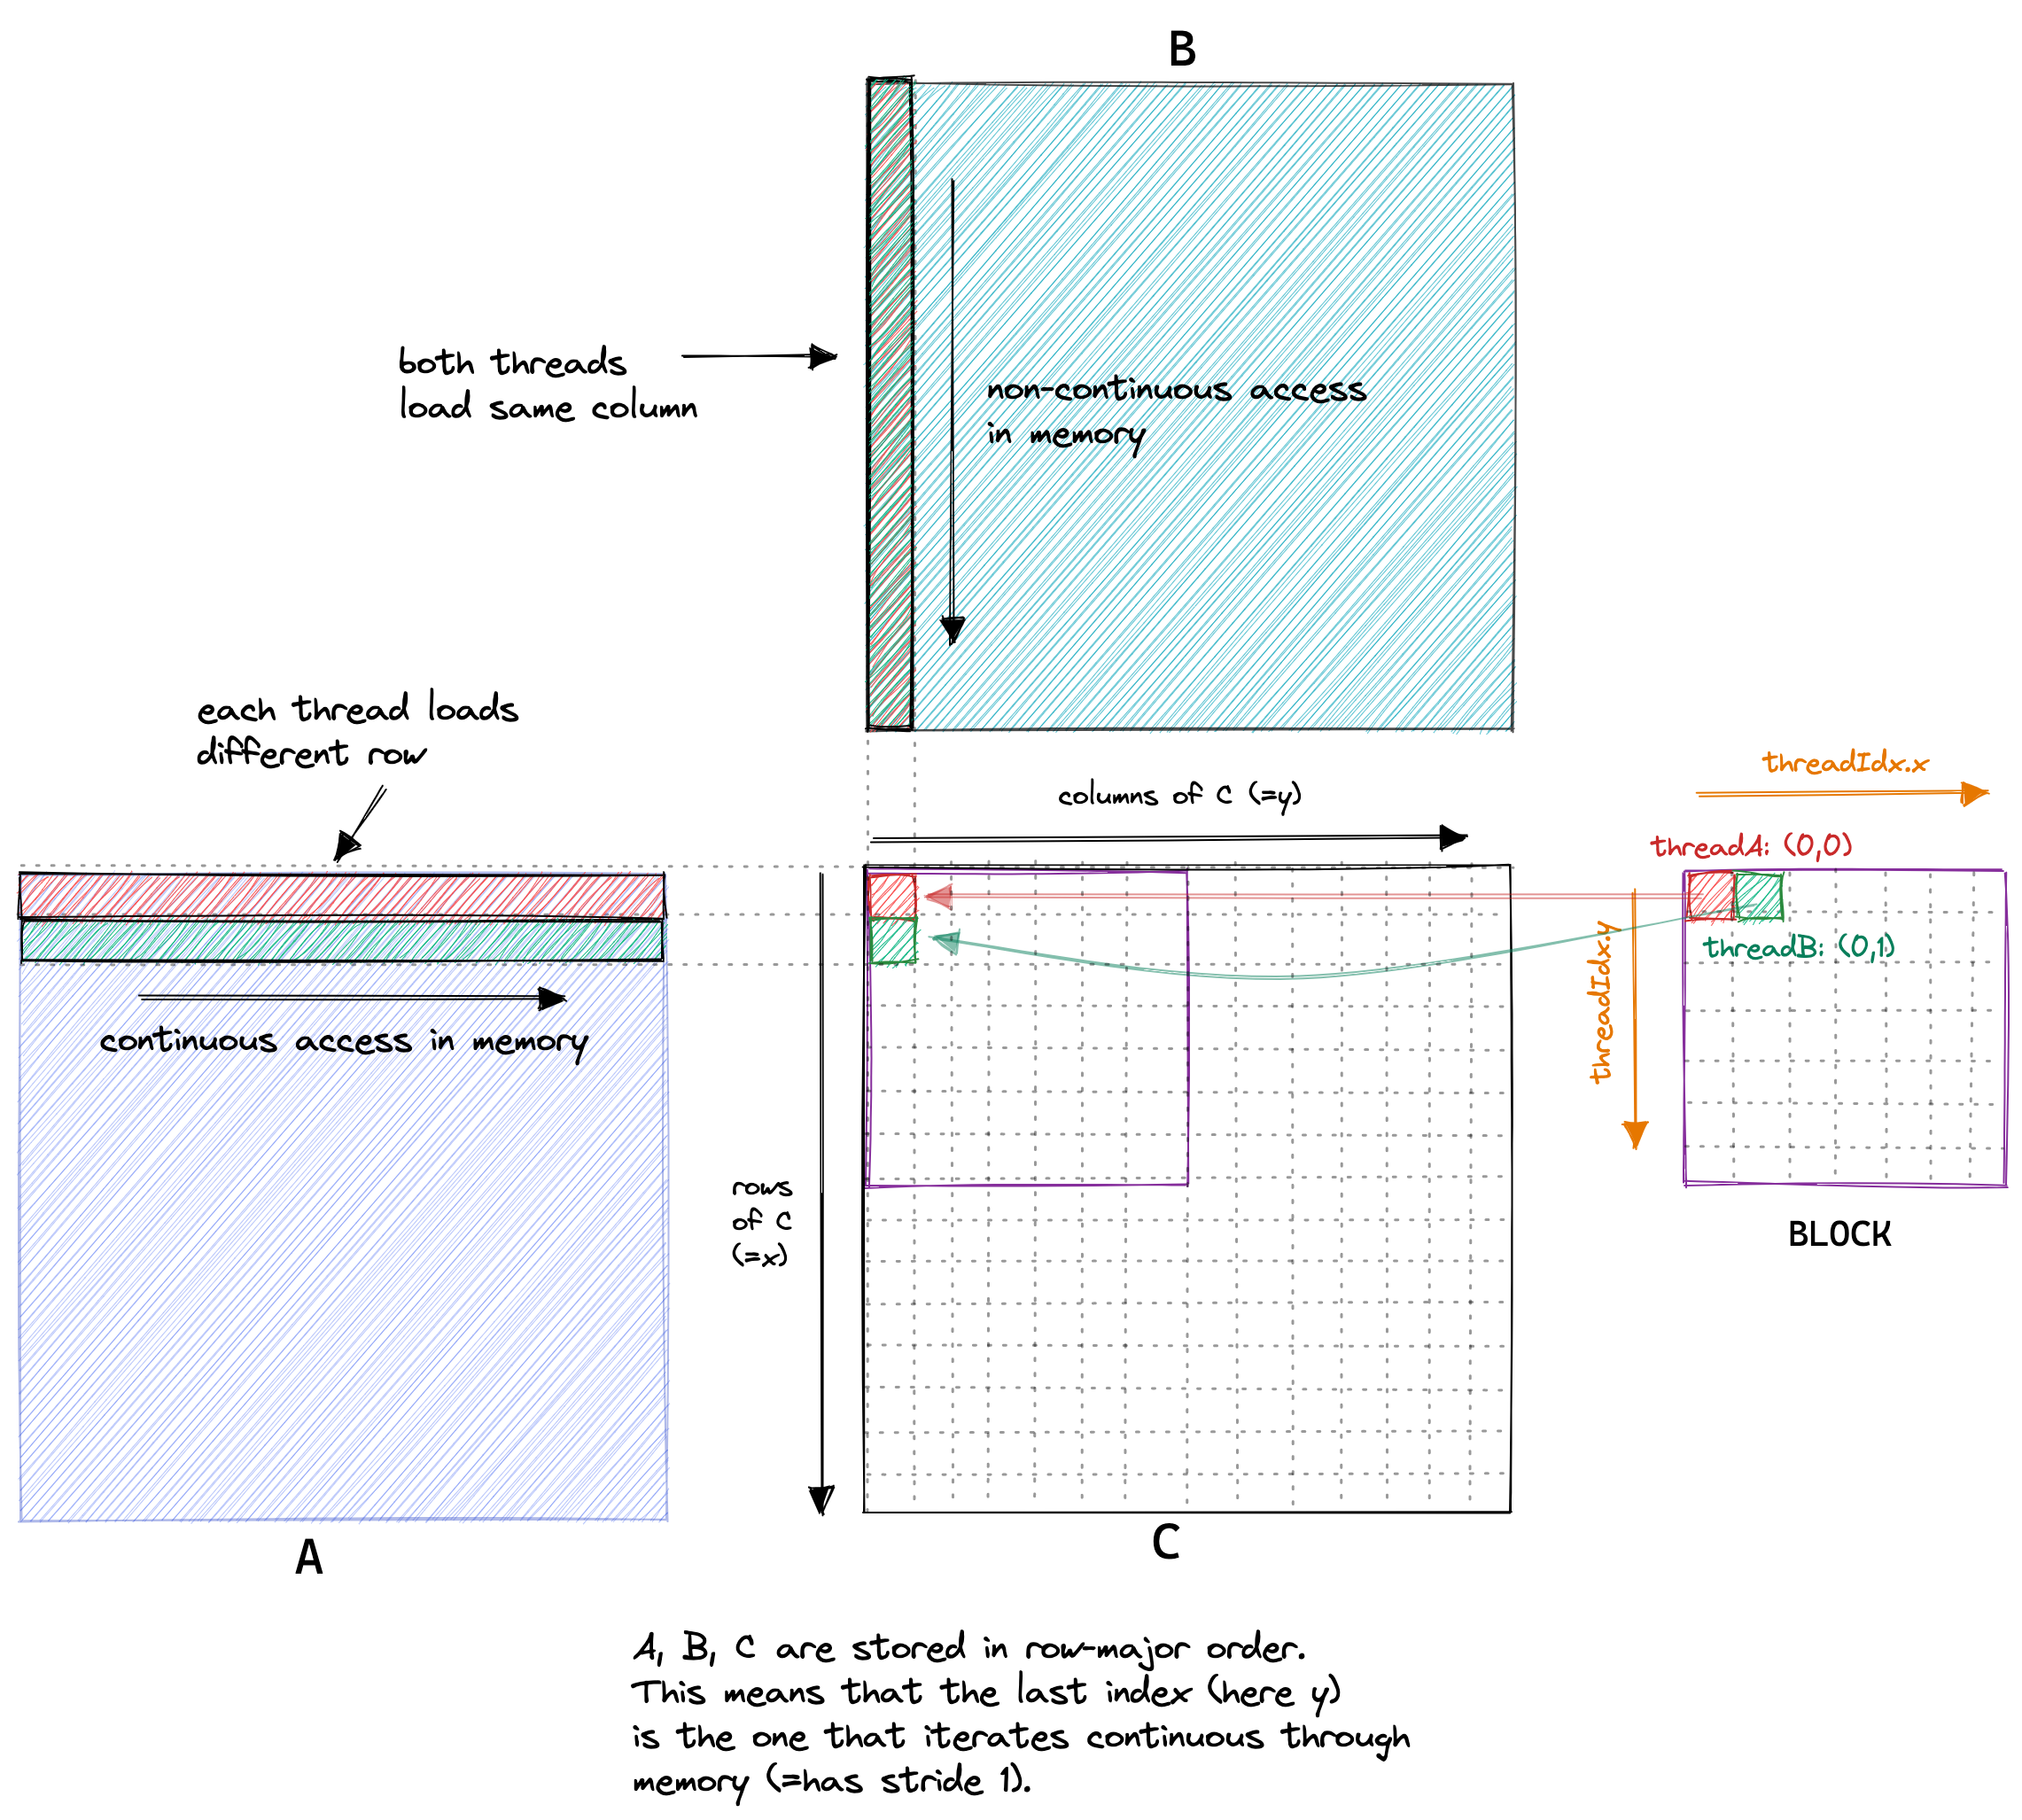
图 3 Naive Kernel 内存访问模式:线程 A(红)与线程 B(绿)独立重复加载数据,缺乏复用
2. Kernel 2: 全局内存合并访问
要理解合并访存,必须先理解 GPU 的执行核心单位—— 线程束(Warp) 。在硬件底层,Block 内的线程按连续的 threadId 划分为每组 32 个线程的 Warp。SM 中的 Warp 调度器以 Warp 为原子单位发射指令。
多维 blockDim 下连续 threadId 计算公式如下:
// 多维 Block 中,将 (x, y, z) 坐标线性化映射为一维硬件 threadId:
// 第一维 threadIdx.x 沿 Warp 内部连续增长,用于对齐 32 线程的物理 Warp 调度
threadId = threadIdx.x + blockDim.x * (threadIdx.y + blockDim.y * threadIdx.z);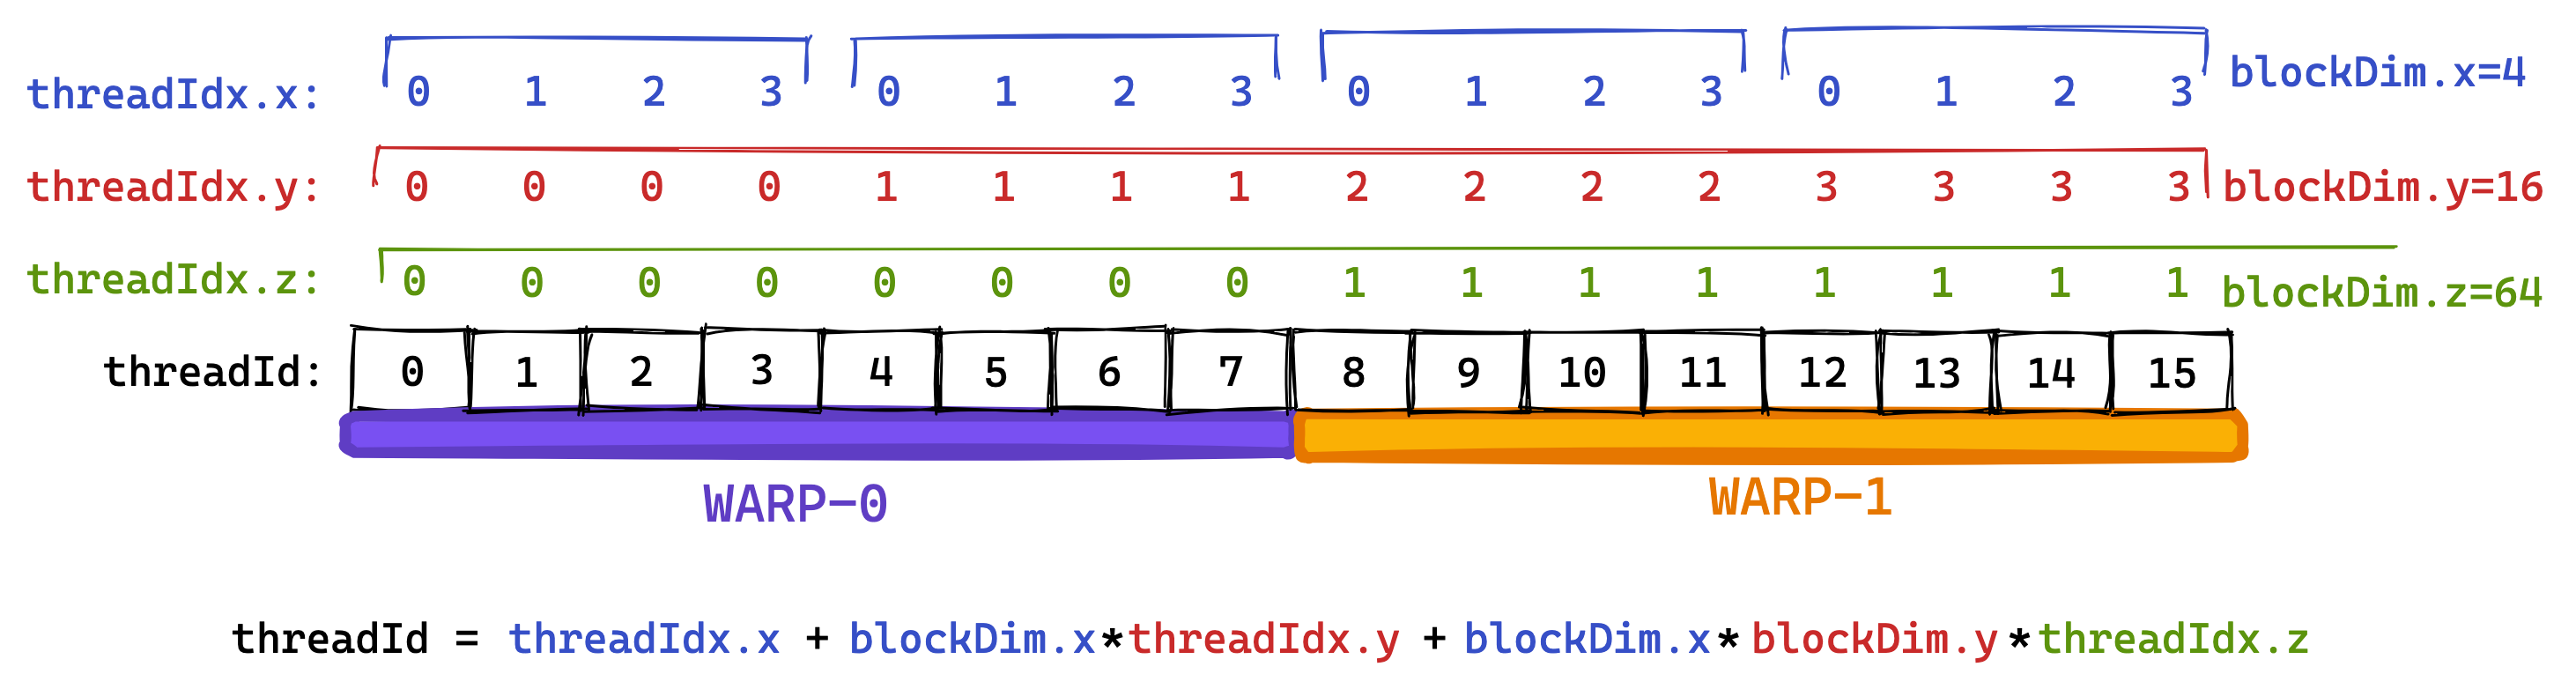
图 4 连续的 threadId 被聚合成 Warp(示意图以 8 线程展示,实际硬件为固定 32 线程)
全局内存合并(Coalescing) :当同一个 Warp 内的 32 个线程同时发起全局内存访问时,如果它们请求的内存地址在空间上是 连续且对齐的 ,硬件访存单元会自动将这 32 次离散的 4 字节读取聚合为一次或极少数几次 32B / 64B / 128B 的单次总线事务(Bus Transaction)执行。
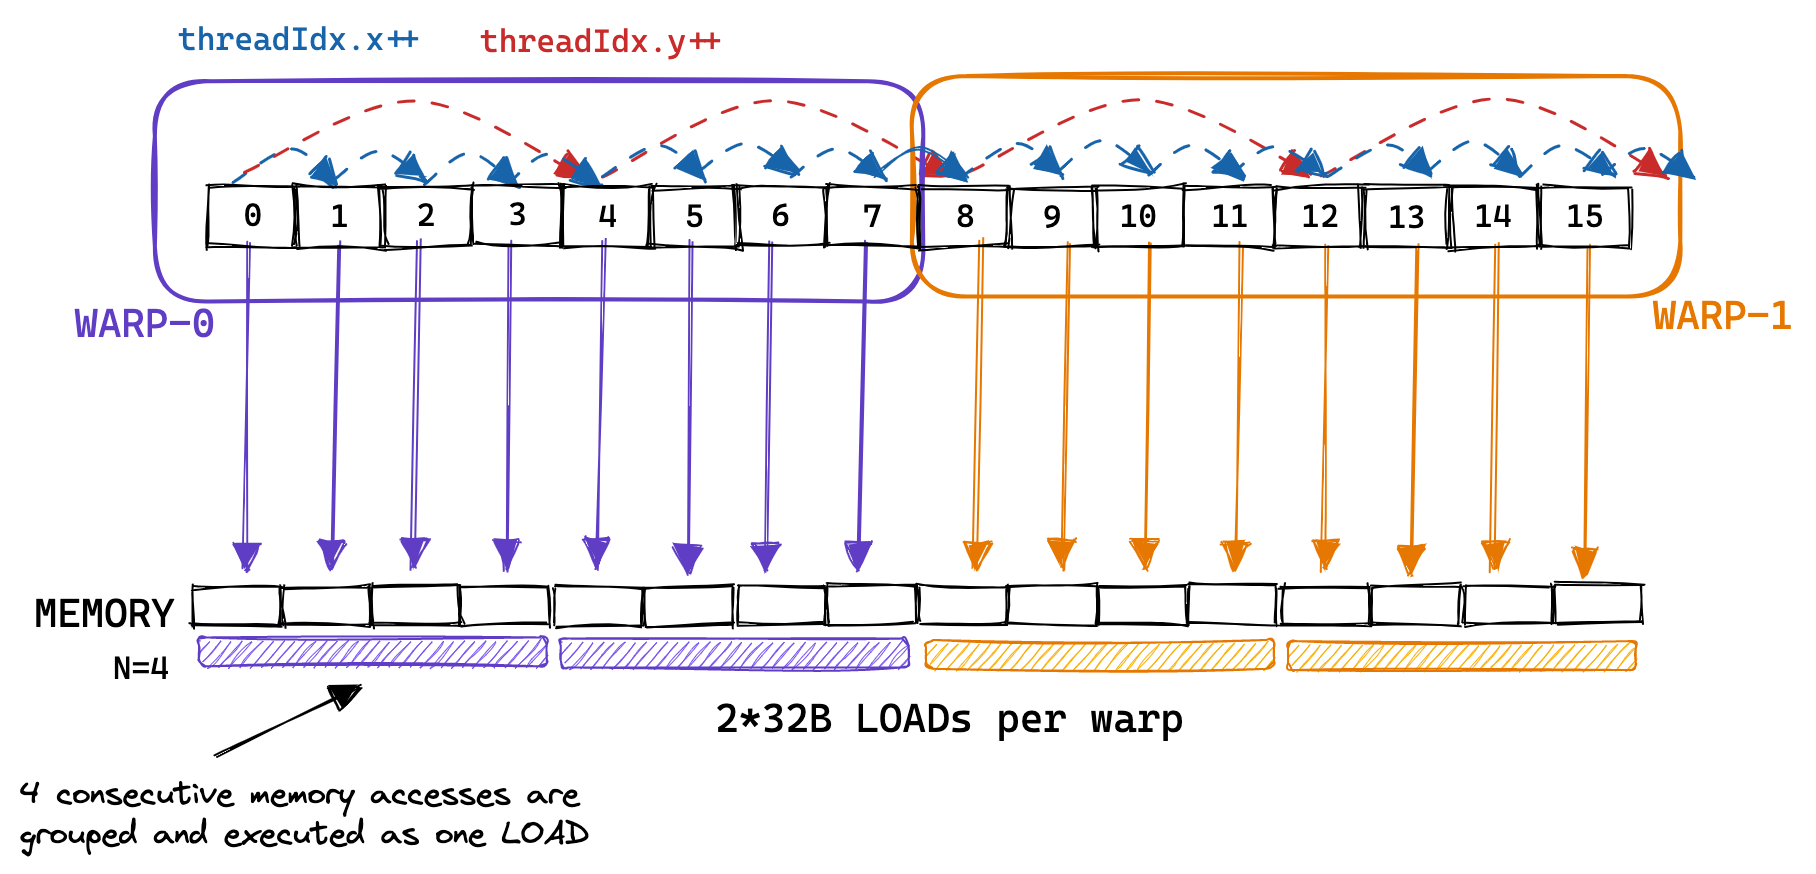
图 5 全局内存合并访问:8 个连续内存请求被聚合成 2 次 32 字节硬件加载事务
冷知识: Warp 内部的线程访问顺序不要求严格顺序对应,即便内部乱序访问,只要该 Warp 访问的地址总范围在同一个对齐窗口内,硬件依然可以完成合并加载。 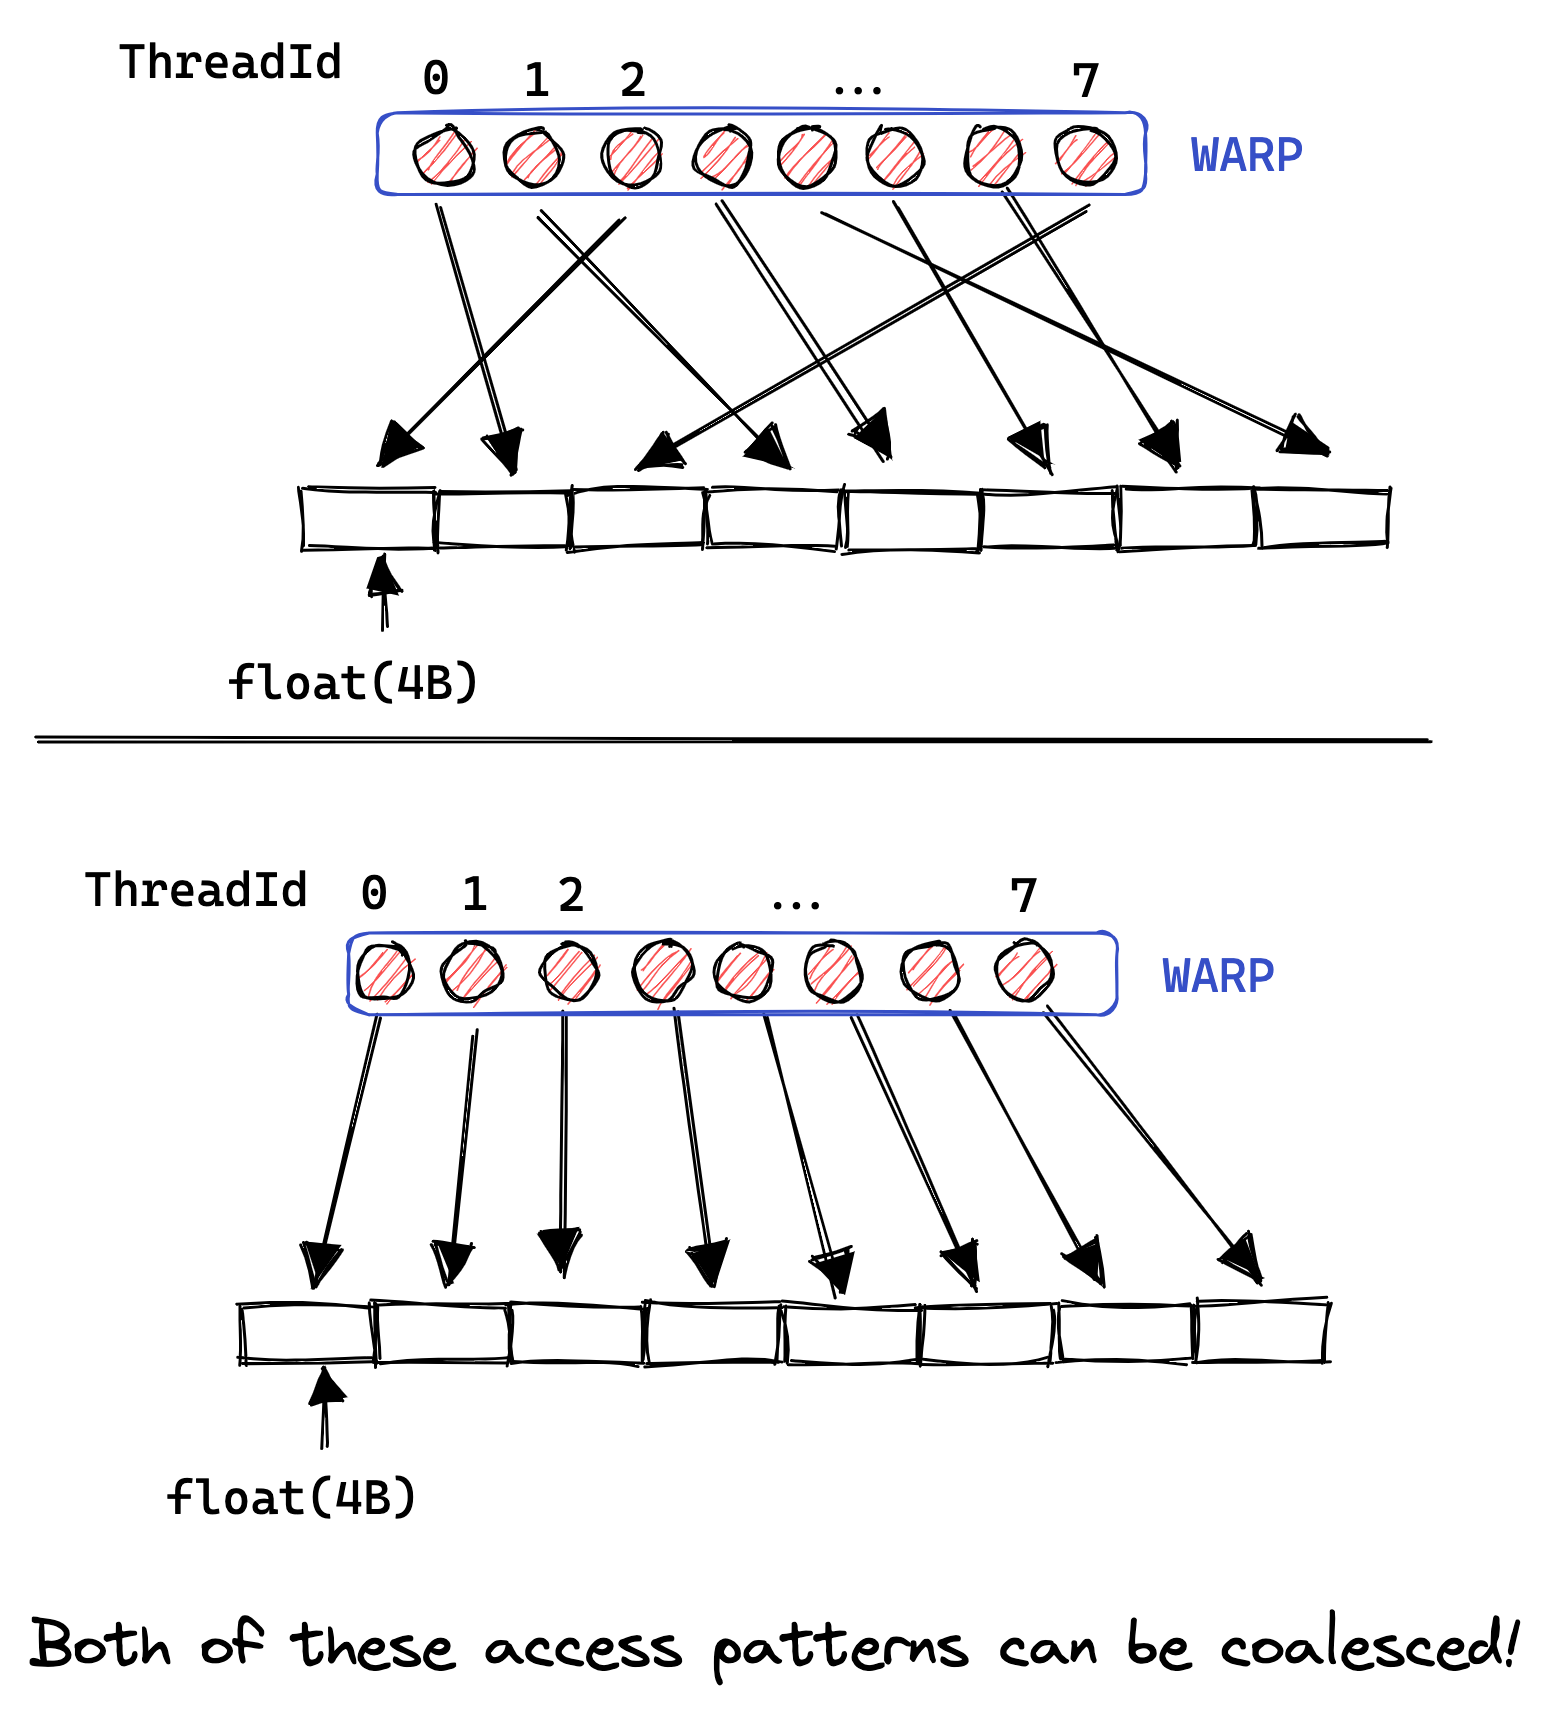
在 Naive Kernel 中:
// Naive Kernel 中的灾难性坐标绑定:
// threadIdx.x 递增导致 x 递增,即 Warp 内相邻线程分别去读 A 的不同行(跨步达 K 个 float)!
const uint x = blockIdx.x * blockDim.x + threadIdx.x; // x 对应 A 的行号(跨行大步长,无法合并!)
const uint y = blockIdx.y * blockDim.y + threadIdx.y; // y 对应 B 的列号
同一个 Warp 内拥有连续 threadIdx.x 的线程,其 x 坐标递增,导致它们访问的是矩阵 A 不同的行(行与行之间相隔 K 个元素,物理地址跨度极大)。这直接打碎了合并访问,显存吞吐被严重劣化至仅剩可怜的 15 GB/s。
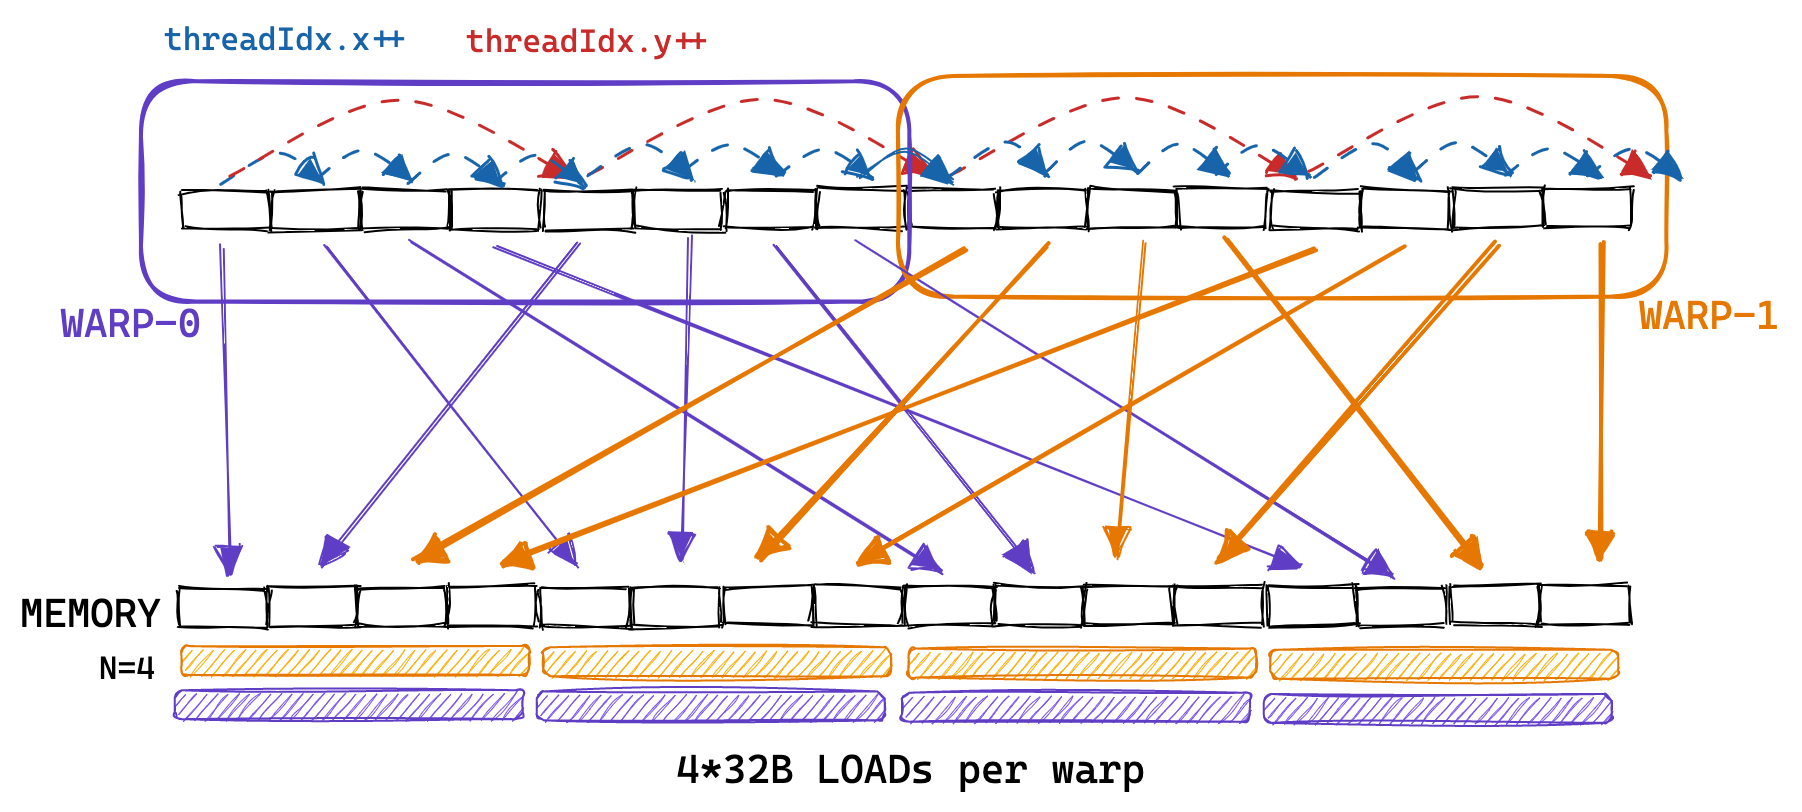
图 6 原 Naive Kernel 的非连续加载模式:Warp 线程跨步跳跃在显存的不同行
优化手段: 调整索引映射方式,让同一个 Warp 内的线程在内层连续访问行主序存储的相邻内存单元:
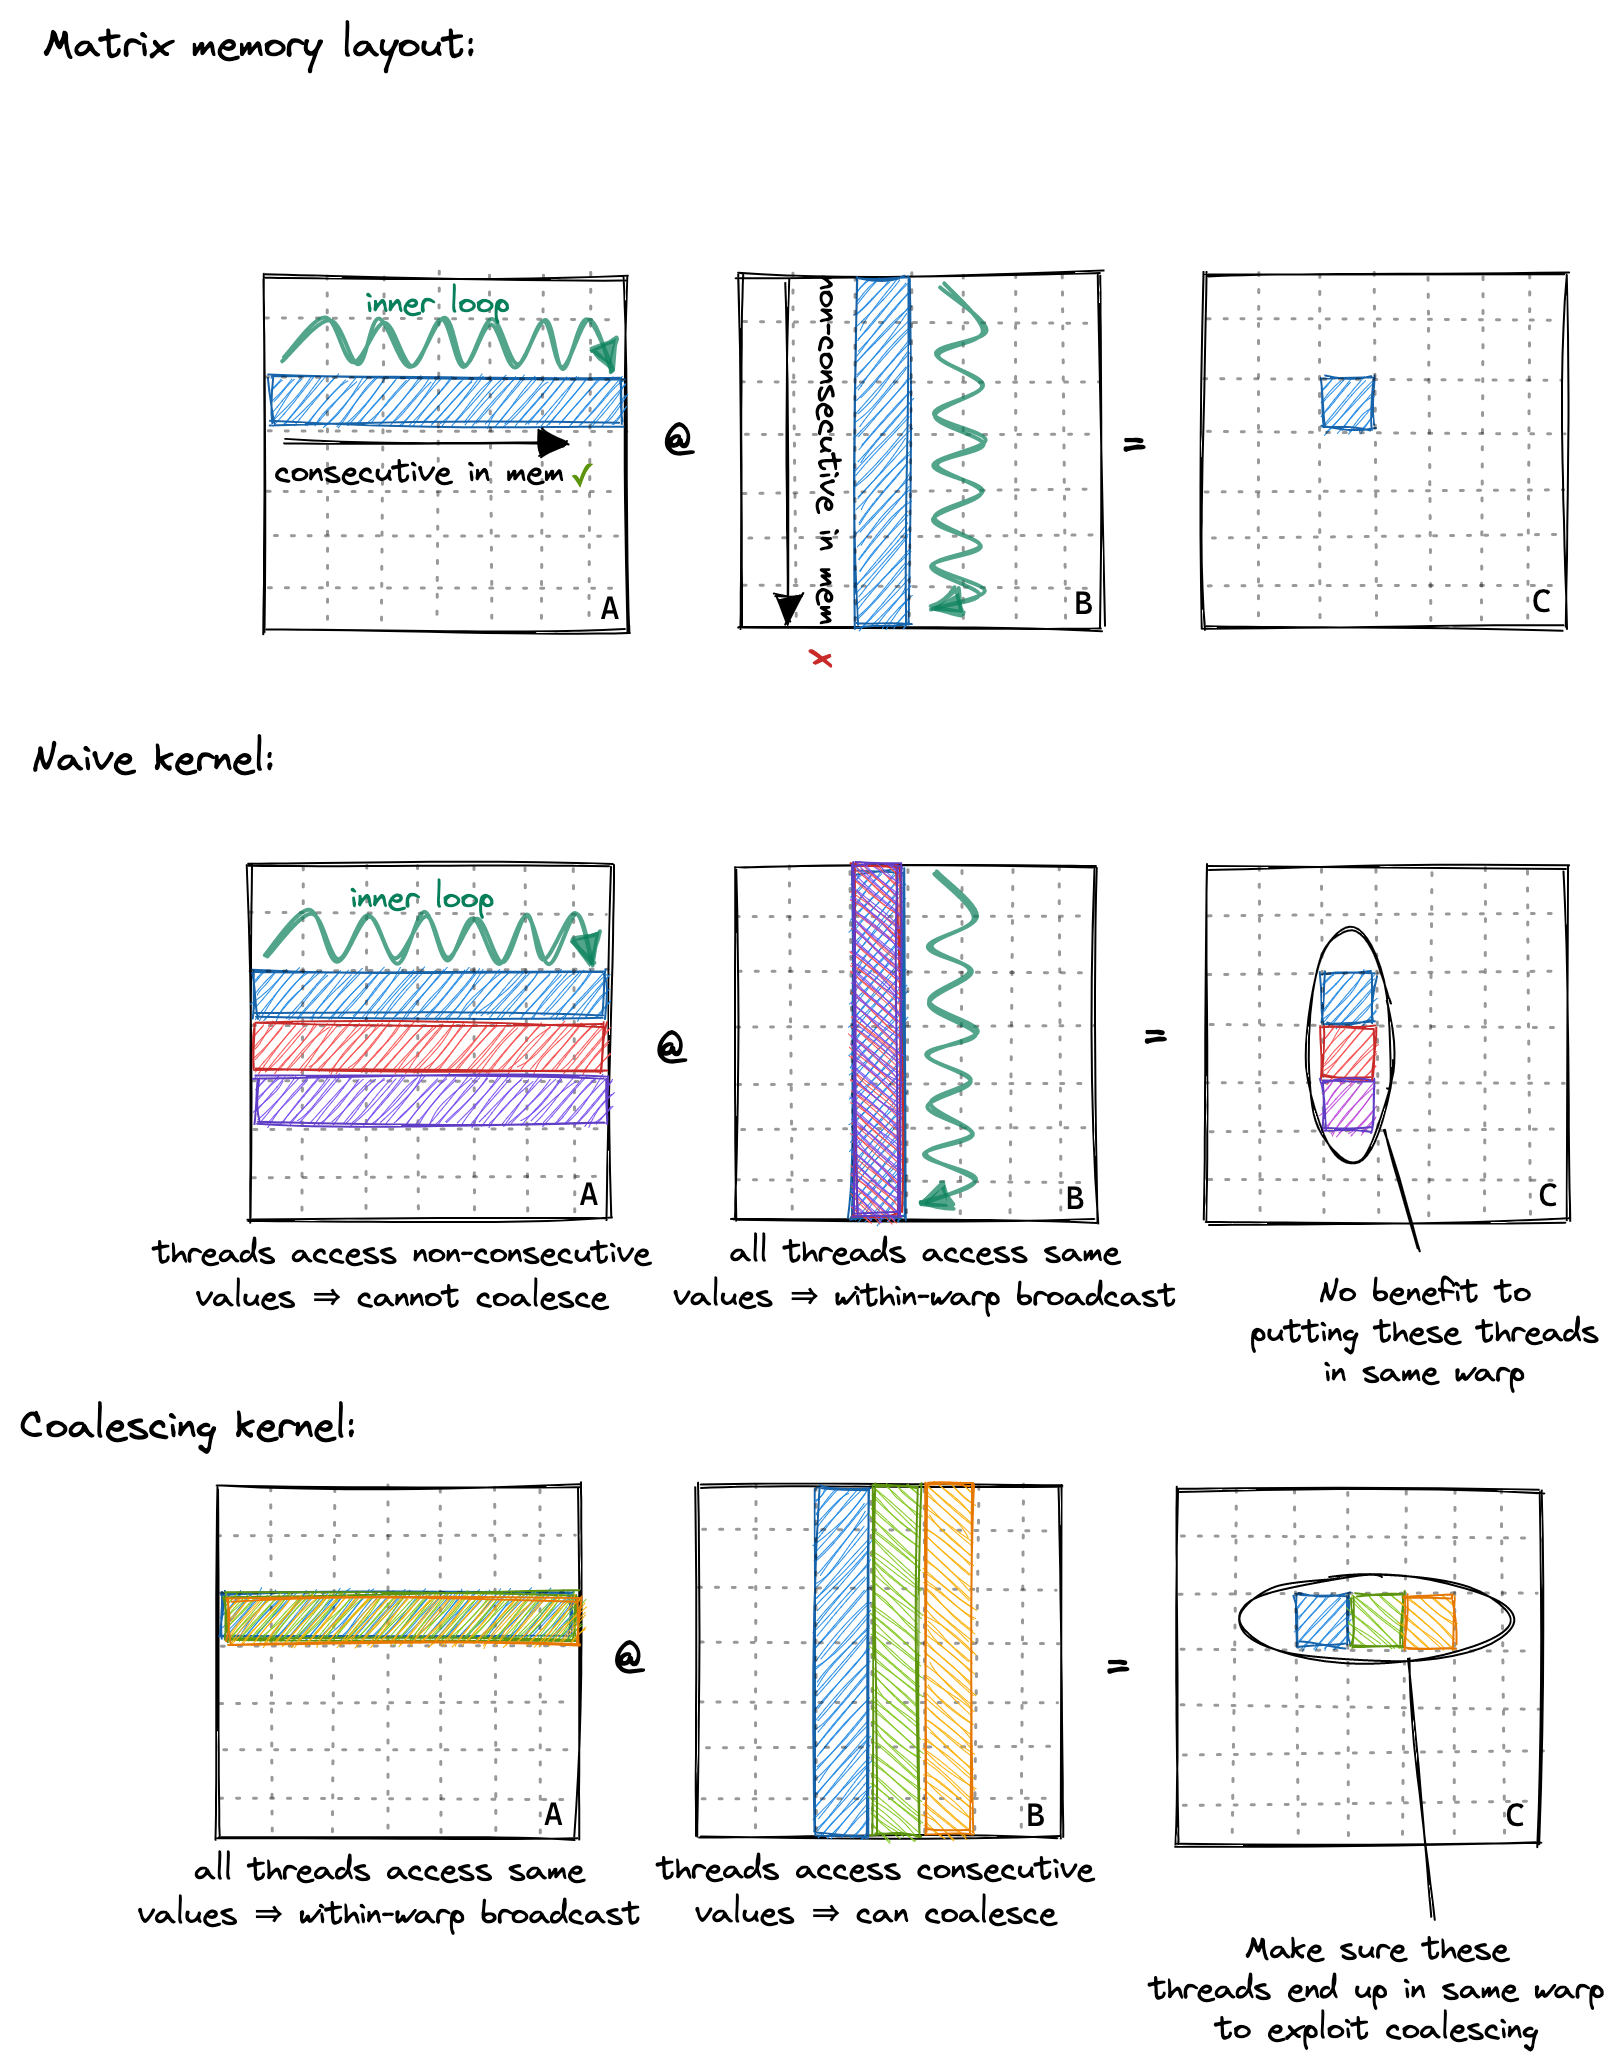
图 7 调整坐标分配:确保 Warp 内部线程沿着内存中物理连续的方向遍历
// 核心优化:彻底重构线程坐标与矩阵行列的映射关系!
// 原先将 threadIdx.x 绑定到 A 的行,导致相邻线程访问不同行(跨步为 K),打碎了内存合并。
// 现在将 Block 展平为一维(1024 线程),再通过除法和取模重构为 32x32 的二维空间:
const int x = blockIdx.x * BLOCKSIZE + (threadIdx.x / BLOCKSIZE); // 行号:连续 32 个线程的 x 相同,共享同一行!
const int y = blockIdx.y * BLOCKSIZE + (threadIdx.x % BLOCKSIZE); // 列号:连续 32 个线程的 y 坐标严格连续递增!

if (x < M && y < N) {
  float tmp = 0.0f;
  for (int i = 0; i < K; ++i) {
    // 关键效果:
    // 读取 B[i * N + y] 时,同一个 Warp(32 个线程)的 y 坐标是连续的!
    // 32 个线程在同一时钟周期发起的 4 字节读取被硬件合并为单次 128 字节的总线事务!
    tmp += A[x * K + i] * B[i * N + y];
  }
  // 写回 C 时,相邻线程也是写向同一行中连续的列,完全满足合并写入条件
  C[x * N + y] = alpha * tmp + beta * C[x * N + y];
}
优化效果: 显存总线吞吐从 15 GB/s 骤增至 110 GB/s ,算力从 300 GFLOPs 跃升至 1,986.5 GFLOPs(提升超 6.5 倍) 。
3. Kernel 3: 共享内存分块缓存
虽然 Kernel 2 实现了合并访存,但它依然一遍又一遍地从远端显存中重复加载相同的元素。为了解决复用问题,必须使用 GPU 芯片内部极速的 共享内存(Shared Memory, SMEM) 。
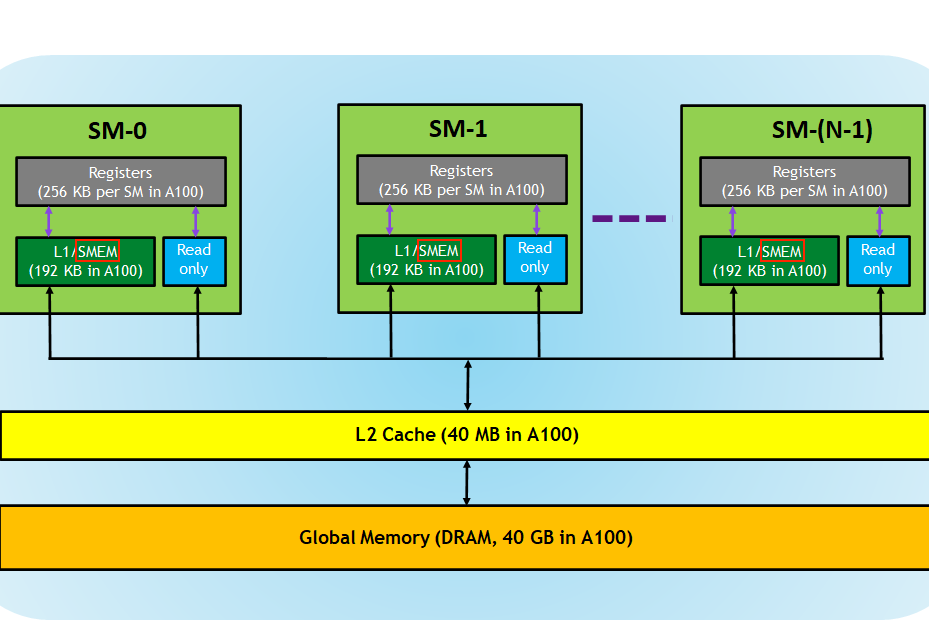
图 8 现代 GPU 内存层级结构:全局显存(~750 GB/s)与片上共享内存(~12,000 GB/s)存在数量级差距
算法逻辑: 每个 Block 在共享内存中开辟大小为 BLOCKSIZE * BLOCKSIZE 的缓冲区 As 和 Bs。所有线程协同将矩阵 A 的一个方块与矩阵 B 的一个方块搬入 SMEM,执行同步屏障 __syncthreads(),然后基于这部分高速缓存计算部分和;随后沿 K 维度滑动方块,直至累加完成。
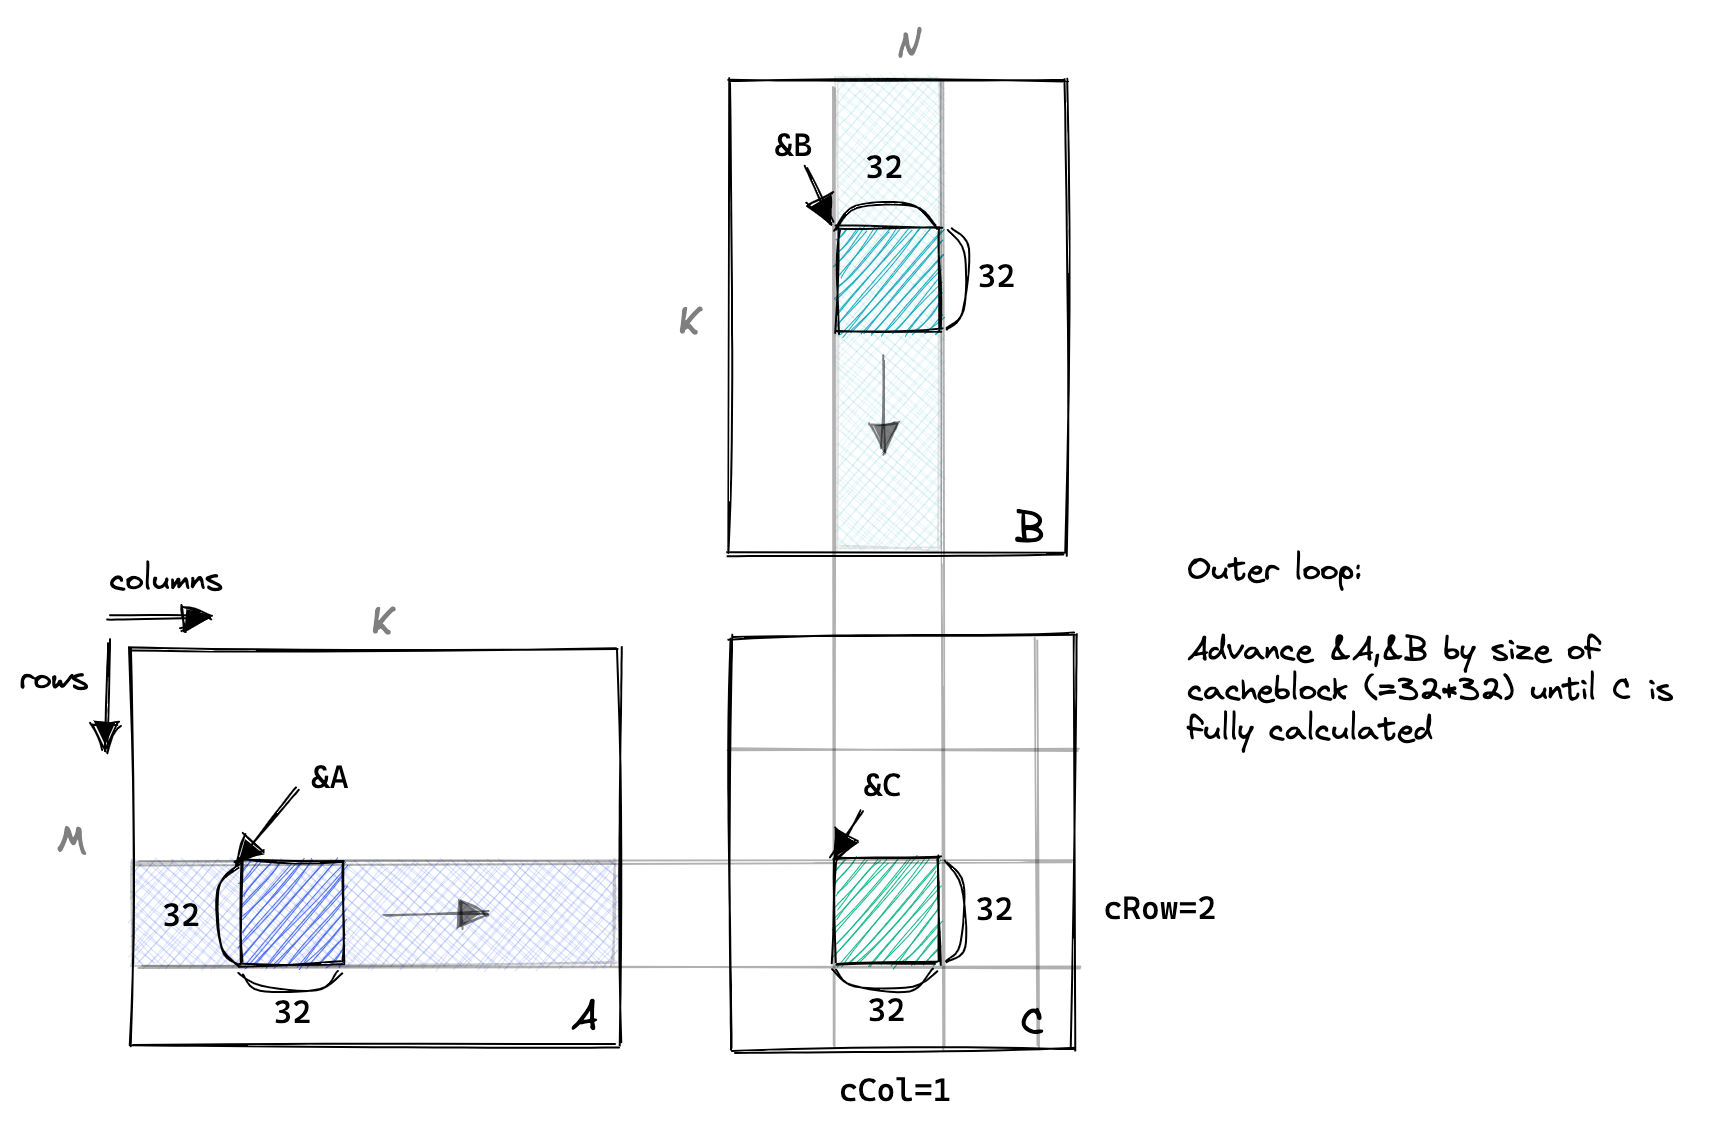
图 9 共享内存分块策略:分批协作搬运局部子块并沿 K 轴滑动
// 1. 基址指针前移:将指针快速定位到当前 Block 所负责的局部起始地址
A += cRow * BLOCKSIZE * K;                    // A 的起始行:cRow * 32,跳过前面所有整行
B += cCol * BLOCKSIZE;                        // B 的起始列:cCol * 32
C += cRow * BLOCKSIZE * N + cCol * BLOCKSIZE; // C 当前 Block 负责的 32x32 左上角基地址

float tmp = 0.0f; // 累加中间结果的寄存器

// 2. 外层滑动循环:沿公共维度 K 按 BLOCKSIZE(32)步长推进切片
for (int bkIdx = 0; bkIdx < K; bkIdx += BLOCKSIZE) {
  // 3. 协作搬运:每个线程从高延迟的全局显存加载 1 个 A 元素和 1 个 B 元素写入片上共享内存
  // threadCol(即 threadIdx.x % 32)作为内层连续索引,严格保证全局显存的合并读取!
  As[threadRow * BLOCKSIZE + threadCol] = A[threadRow * K + threadCol];
  Bs[threadRow * BLOCKSIZE + threadCol] = B[threadRow * N + threadCol];

  // 4. 同步屏障 ①:阻塞当前 Block 内的所有 1024 个线程,
  // 必须确保当前分块的全部 32x32 缓存数据均已安全落入共享内存后,才能开启后续计算!
  __syncthreads();

  // 5. 提前前移全局内存指针,为下一个分块的加载做准备
  A += BLOCKSIZE;     // A 向右移动 32 列
  B += BLOCKSIZE * N; // B 向下移动 32 行

  // 6. 纯片上计算:利用共享内存(SMEM)中的当前分块数据计算局部的向量点积
  // 共享内存带宽高达 12 TB/s,比全局显存高出一个数量级,大幅消除访存停顿
  for (int dotIdx = 0; dotIdx < BLOCKSIZE; ++dotIdx) {
    tmp += As[threadRow * BLOCKSIZE + dotIdx] *
           Bs[dotIdx * BLOCKSIZE + threadCol];
  }

  // 7. 同步屏障 ②:必须再次同步!
  // 防止跑得快的线程在下一轮循环中过早向 As/Bs 写入新数据,从而覆写了慢线程尚未读取完的旧数据(消除 WAR 读后写风险)
  __syncthreads();
}

// 8. 最终写回全局内存:完成缩放与旧矩阵 C 的累加更新
C[threadRow * N + threadCol] = alpha * tmp + beta * C[threadRow * N + threadCol];
优化效果: 性能提升至 2,980 GFLOPs(接近 3 TFLOPs) 。但距离 30 TFLOPs 的硬件极限依然十分遥远。
4. 瓶颈分析:活跃度(Occupancy)与 Roofline 剖析
我们绘制 Kernel 3 的 Roofline 性能分析图:
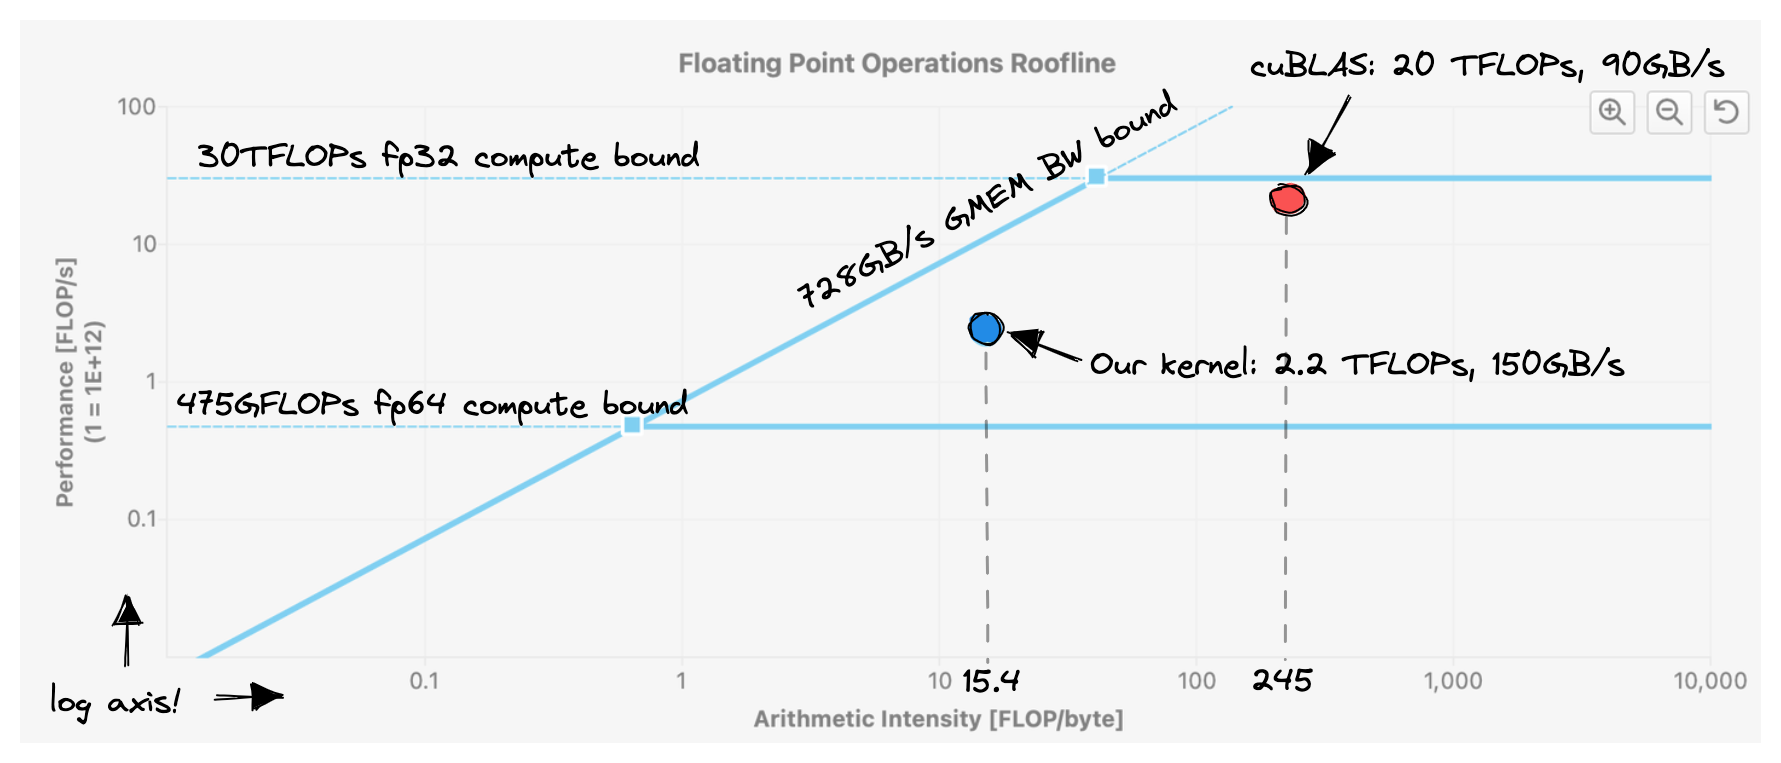
图 10 Kernel 3 的 Roofline 模型分析:我们达到的显存带宽甚至高于 cuBLAS,但算术强度过低导致实际算力低下
核心痛点:算术强度(Arithmetic Intensity)严重不足。 每次从内存搬运数据后,执行的浮点计算次数太少。接下来探究究竟是硬件哪里卡住了?
硬件活跃度(Occupancy)计算
活跃度定义为:每个 SM 上活跃运行的 Warp 数与硬件支持的最大 Warp 数的比值。以 RTX A6000 硬件参数计算:
- SMEM 容量上限 :每个 Block 消耗 8KB,加上 1KB 运行时开销共 9KB。每个 SM 拥有 100KB SMEM,可容纳 11 个 Block;
- 线程数上限 :每个 Block 含 1,024 线程,而每个 SM 上限仅允许 1,536 线程。因此 线程数硬性限制了每个 SM 只能加载 1 个 Block ;
- 寄存器上限 :单线程用 37 个寄存器,单 Block 消耗 40,960 个寄存器,SM 上限 65,536。同样只能驻留 1 个 Block。
最终得出 Kernel 3 的实际活跃度:32 活跃 Warp / 48 最大 Warp = 66%。66% 的活跃度已经足够掩盖指令发射延迟(参见 Volkov 论文的尖点效应 Cusp Behavior),活跃度并非根本元凶。
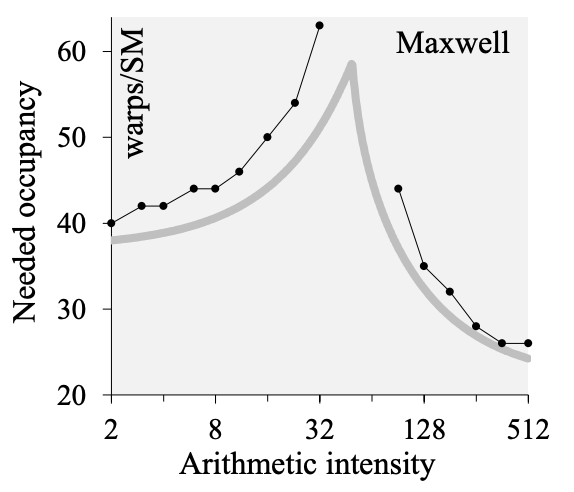
图 11 Volkov 经典论文中的尖点效应:在高算术强度下,并不需要 100% 活跃度即可打满性能
通过 NVIDIA Nsight Compute (NCU) 分析指令混合与停顿原因:
// Kernel 3 内层循环编译出的核心 PTX 指令序列:
ld.shared.f32   %f91, [%r8+3456];        // 指令 1:从共享内存加载 1 个 float (As 元素) 到寄存器 %f91
ld.shared.f32   %f92, [%r7+108];         // 指令 2:从共享内存加载 1 个 float (Bs 元素) 到寄存器 %f92
fma.rn.f32      %f93, %f92, %f91, %f90;  // 指令 3:乘加融合指令,计算 %f93 = %f92 * %f91 + %f90

// 严重瓶颈剖析:
// 每次计算只执行 1 次算术乘加 FMA,却需要执行 2 次共享内存加载 LDS!
// 访存指令频率远高于算术指令,导致硬件 MIO (Memory Input/Output) 指令队列严重拥塞排队,
// NCU Profiler 中显示大量的 "Stall MIO Throttle" 和 "Long Scoreboard" 停顿!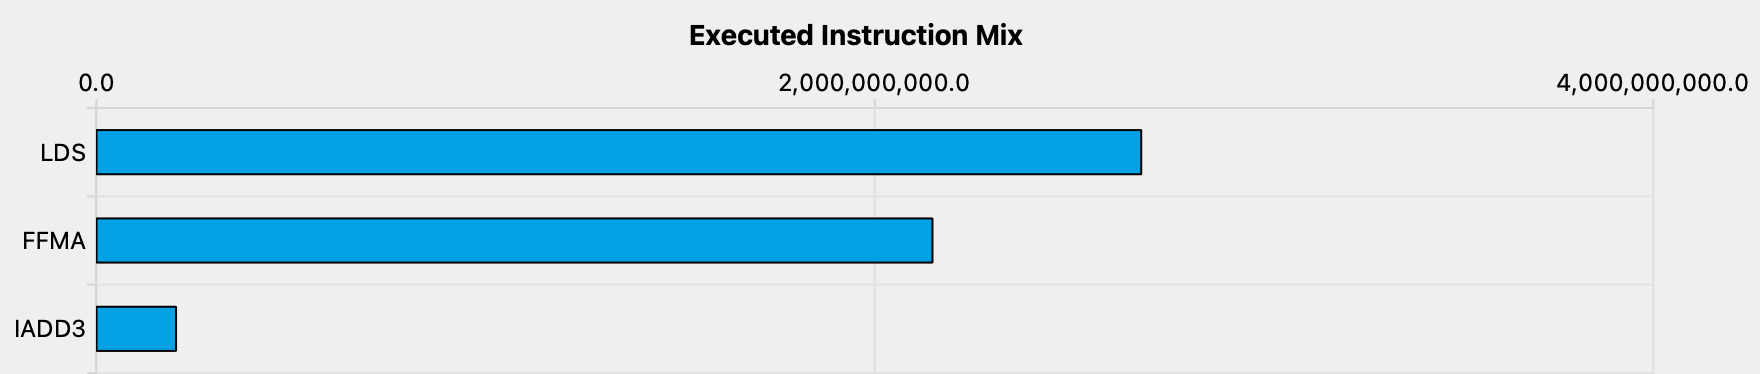
图 12 Kernel 3 指令分布:绝大部分指令全是 LDS(共享内存加载),FMA 乘加指令被严重稀释
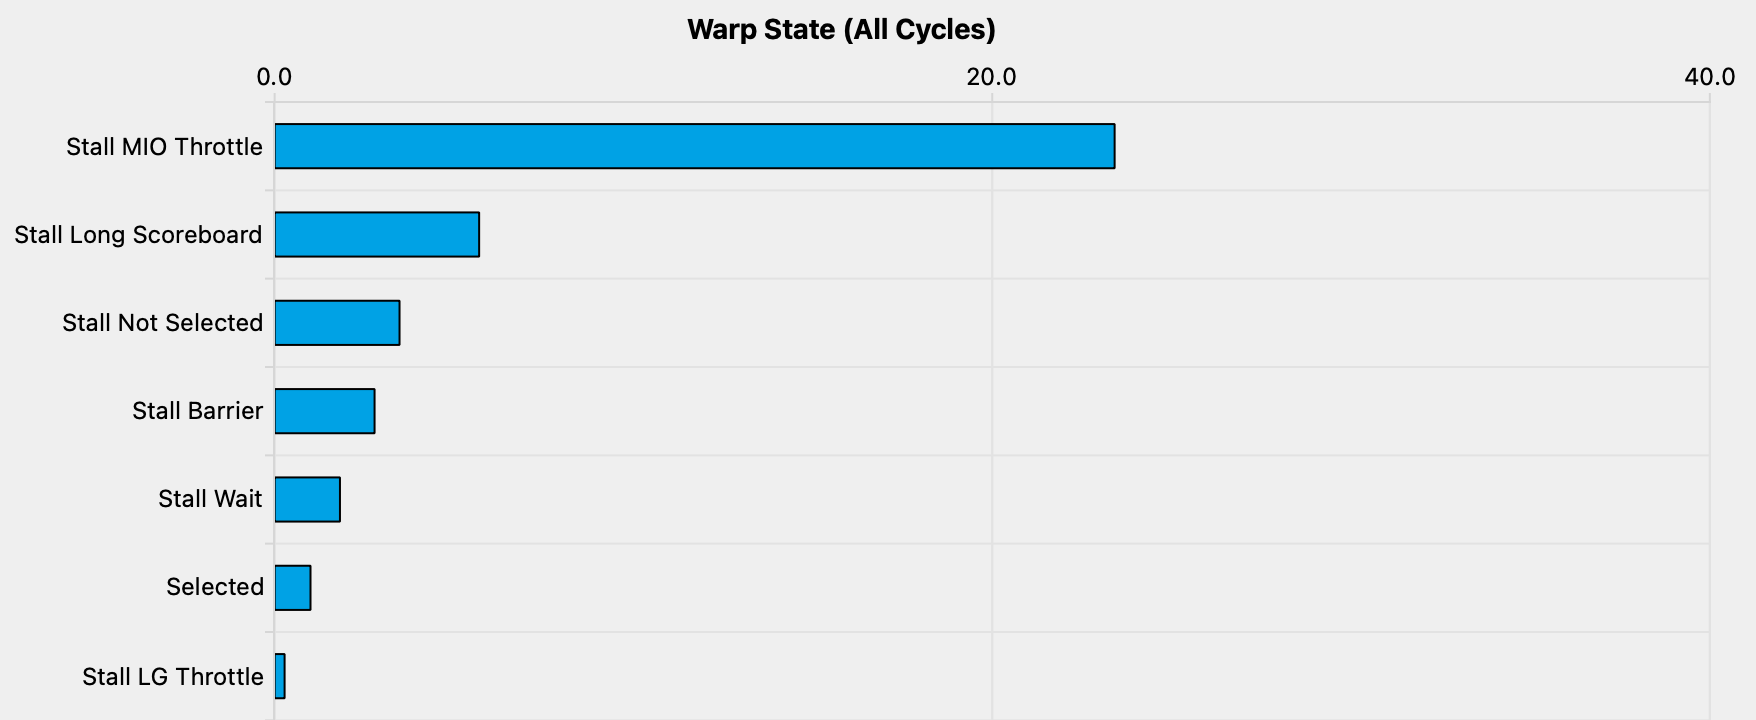
图 13 Warp 停顿原因:主要卡在 Stall MIO Throttle 与 Long Scoreboard,即共享内存访存流水线严重阻塞排队
5. Kernel 4: 一维分块提升单线程算力(1D Blocktiling)
诊断结果非常明确: 共享内存读取指令太多,把 MIO 队列堵死了。
解决方案: 不再让一个线程只算一个结果,而是让 每个线程连续计算 TM=8 个结果 。这样多个输出可以共享对同一个 B 矩阵元素的读取,将其存入私有寄存器中,成倍减少对 SMEM 的请求。
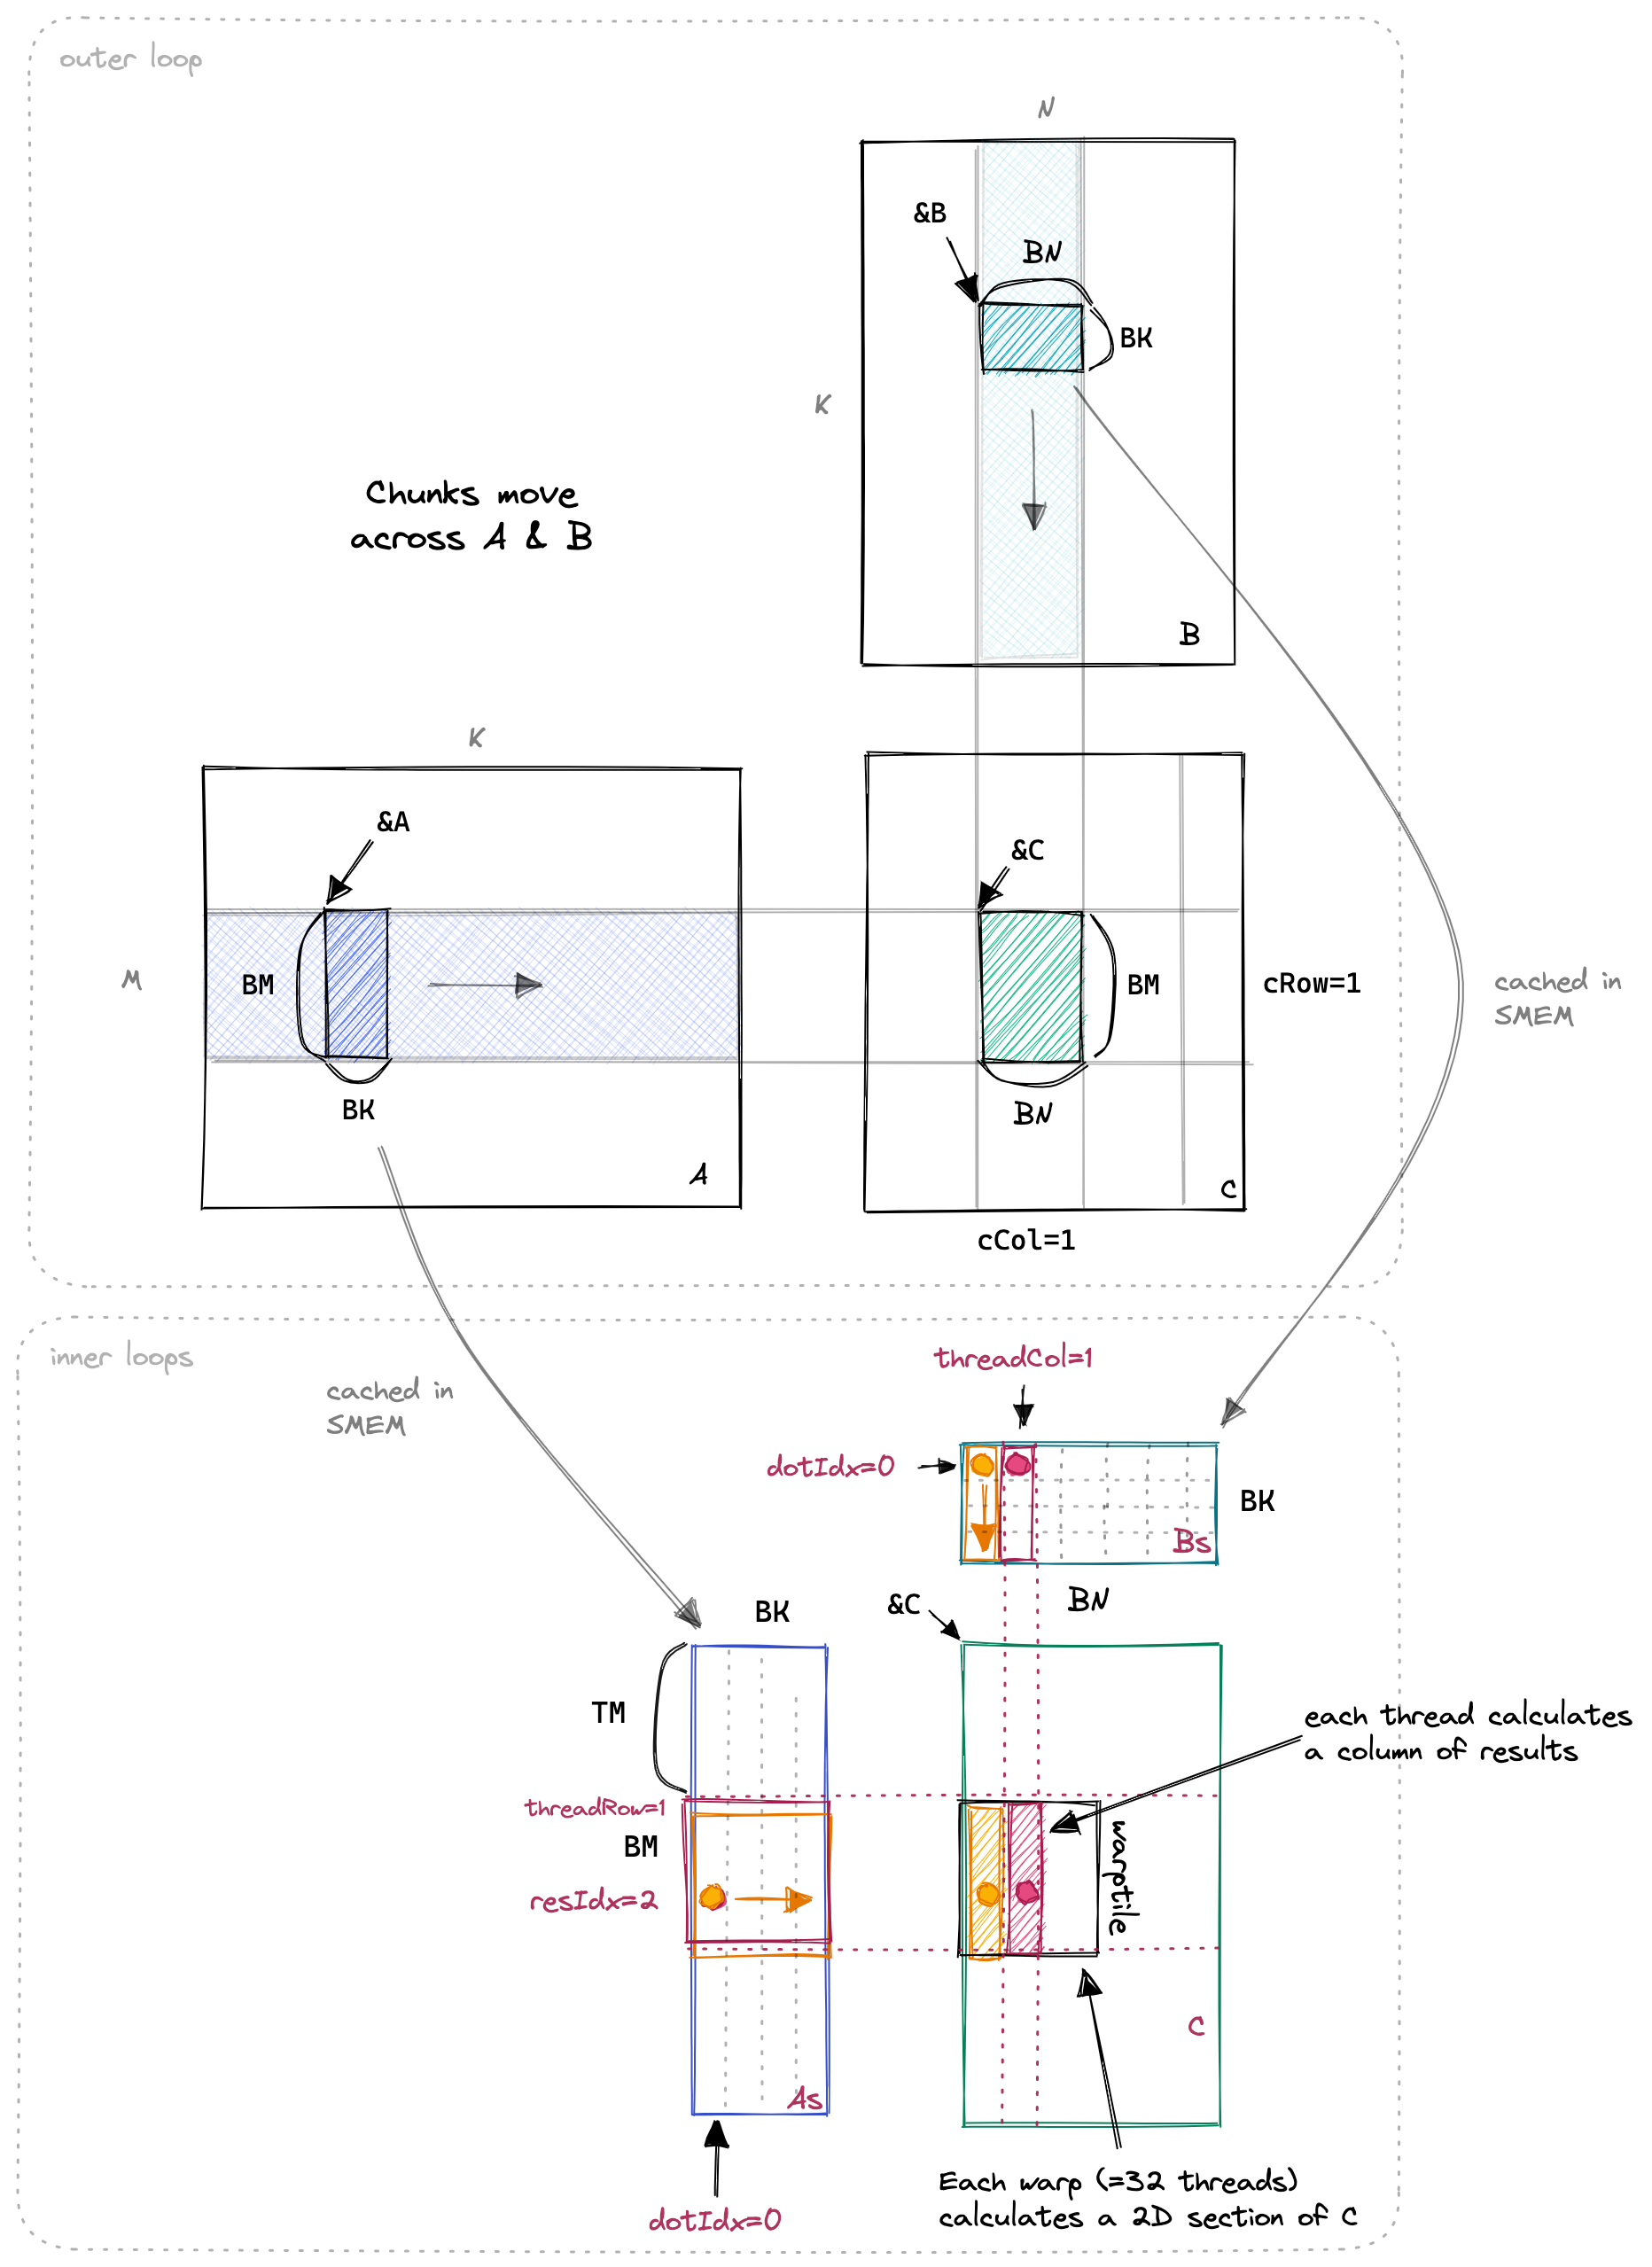
图 14 一维分块:每个线程负责计算一整列中连续的 TM=8 个元素
// 1. 为当前线程分配输出缓冲区:在寄存器堆中开辟大小为 TM(=8)的私有数组
// 每个线程将计算结果矩阵 C 中沿列方向连续的 8 个元素!
float threadResults[TM] = {0.0f};

// 2. 外层循环:沿 K 轴以 BK(=8)为切片步长滑动
for (uint bkIdx = 0; bkIdx < K; bkIdx += BK) {
  // 协作加载:Block 规模为 BM x BK 和 BK x BN(64x8),共 64x8x2 = 1024 浮点数,正好对应 1024 线程
  As[innerRowA * BK + innerColA] = A[innerRowA * K + innerColA];
  Bs[innerRowB * BN + innerColB] = B[innerRowB * N + innerColB];
  __syncthreads(); // 等待 SMEM 填充完毕

  A += BK;     // A 指针向右滑 8 列
  B += BK * N; // B 指针向下滑 8 行

  // 3. 计算单线程负责的 8 个结果:
  // 核心优化:将 dotIdx(沿 K 深度)置于最外层,将针对结果的 resIdx 放在内层!
  for (uint dotIdx = 0; dotIdx < BK; ++dotIdx) {
    // 关键复用:将当前所需的 Bs 元素先读入临时标量寄存器 Btmp!
    // 这样接下来的 8 次乘法都能无偿复用这个寄存器值,免去 7 次重复读取 SMEM!
    float Btmp = Bs[dotIdx * BN + threadCol];
    for (uint resIdx = 0; resIdx < TM; ++resIdx) {
      threadResults[resIdx] +=
          As[(threadRow * TM + resIdx) * BK + dotIdx] * Btmp;
    }
  }
  __syncthreads(); // 确保当前块使用完毕,保护下一轮写入
}
访存开销数学对比:
- Kernel 3(单线程单结果) :每个计算结果消耗
K/16次 GMEM 读取,2K次 SMEM 读取; - Kernel 4(单线程 8 结果) :每个计算结果仅消耗
K/32次 GMEM 读取,1.125 K次 SMEM 读取(SMEM 压力几乎减半) 。
// SASS 汇编层剖析:编译器将连续的内存加载自动向量化
LDS     R26, [R35.X4+0x800]; // 标量读取 As:每次仅加载 32 位(1 个 float)
LDS.128 R8,  [R2];           // 向量化读取 Bs:单条指令直接加载 128 位(4 个 float 宽向量)!
LDS.128 R12, [R2+0x20];      // 再次 128 位向量化读取接下来的 4 个 float
LDS     R24, [R35.X4+0x900]; // 标量读取 As 下一个元素
LDS.128 R20, [R2+0x60];      // 继续 128 位向量化读取 Bs
LDS     R36, [R35.X4+0xb00];
LDS.128 R16, [R2+0x40];
LDS.128 R4,  [R2+0x80];
LDS     R38, [R35.X4+0xd00];

// 硬件启示:
// Bs 沿行连续存储,硬件原生生成了高效的 LDS.128 向量指令;
// 而 As 沿列存储导致无法向量化,这直接启发了后续 Kernel 6 中的 "As 显存转置" 优化!
优化效果: 性能达到 8,474.7 GFLOPs(相对 cuBLAS 36.5%) ,相比 Kernel 3 提速 2.8 倍。Warp 因内存等待导致的停顿周期断崖式下降:
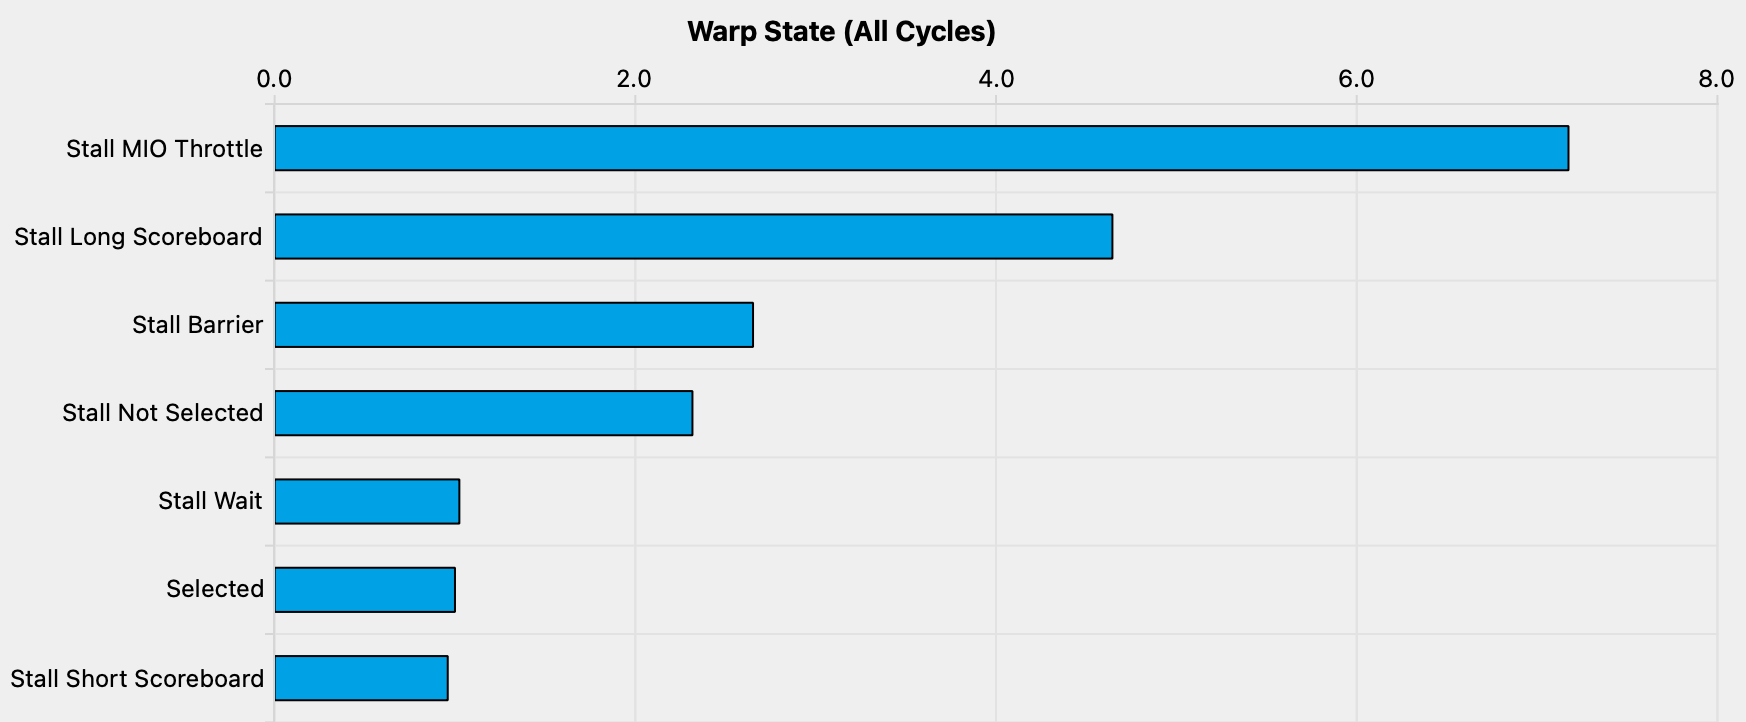
图 15 Kernel 4 内存停顿指标大幅下降,计算单元得以持续工作
6. Kernel 5: 二维分块与寄存器外积(2D Blocktiling)
既然一维分块可以沿一列复用 B 元素,那如果让单线程同时跨行和列,负责一个 的二维方块 ,效果会怎样?
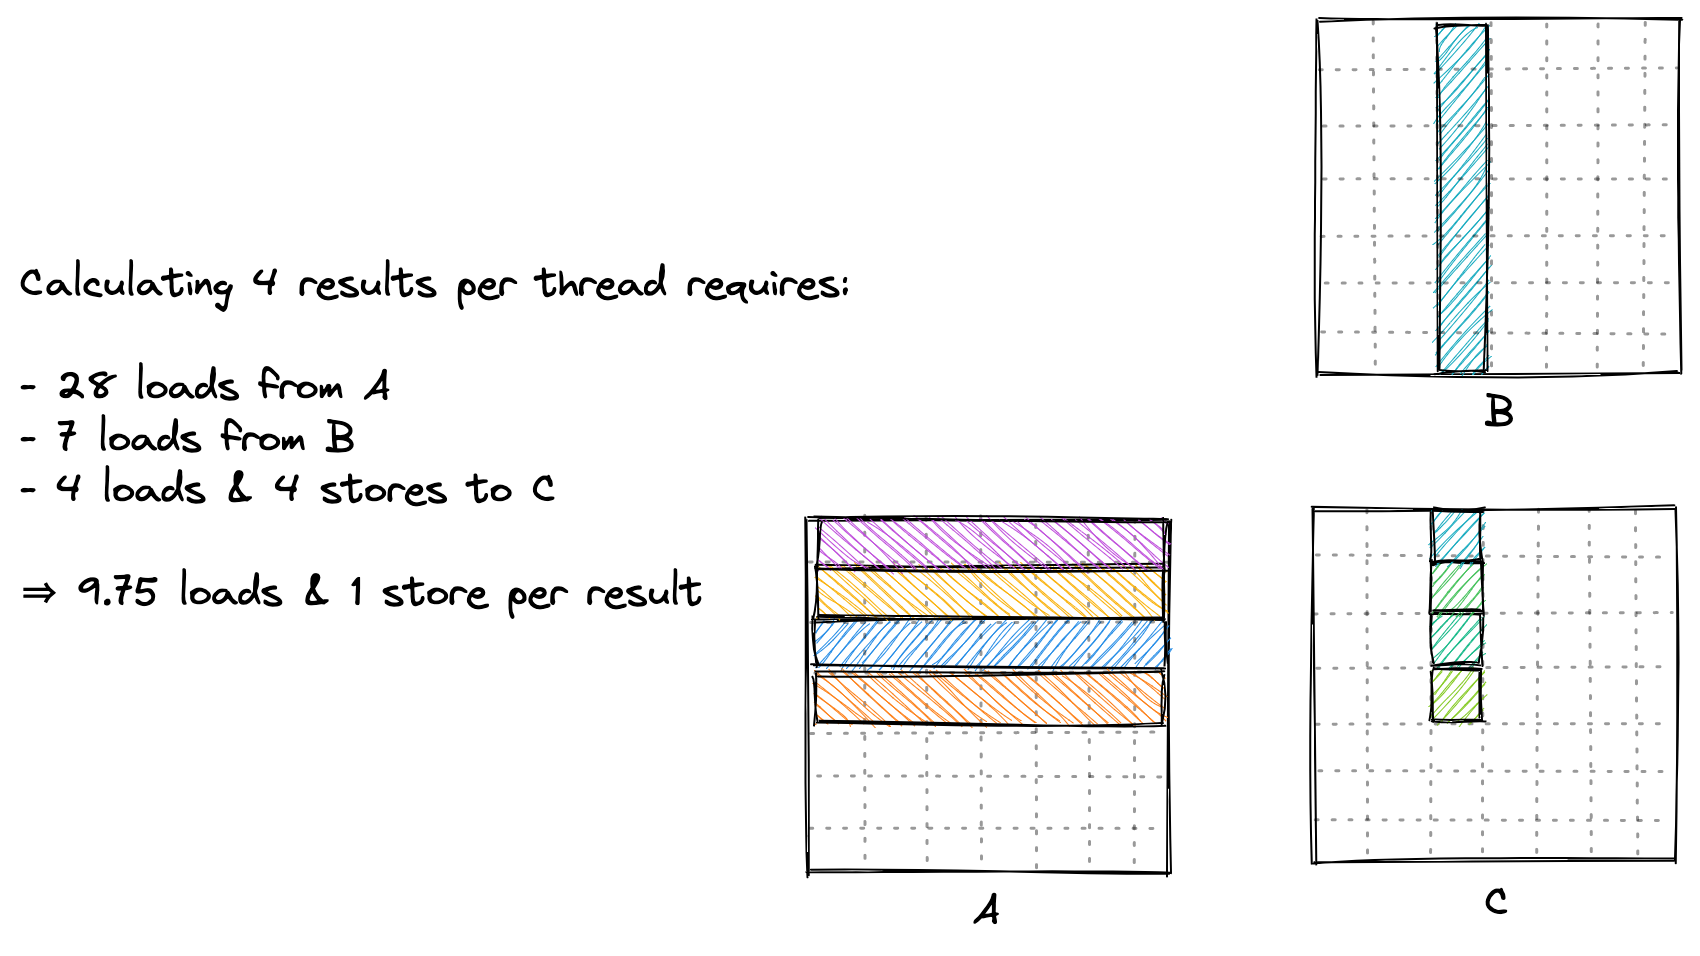
图 16 计算几何原理:计算二维方块比计算一维长条能以几何级数共享更多的数据
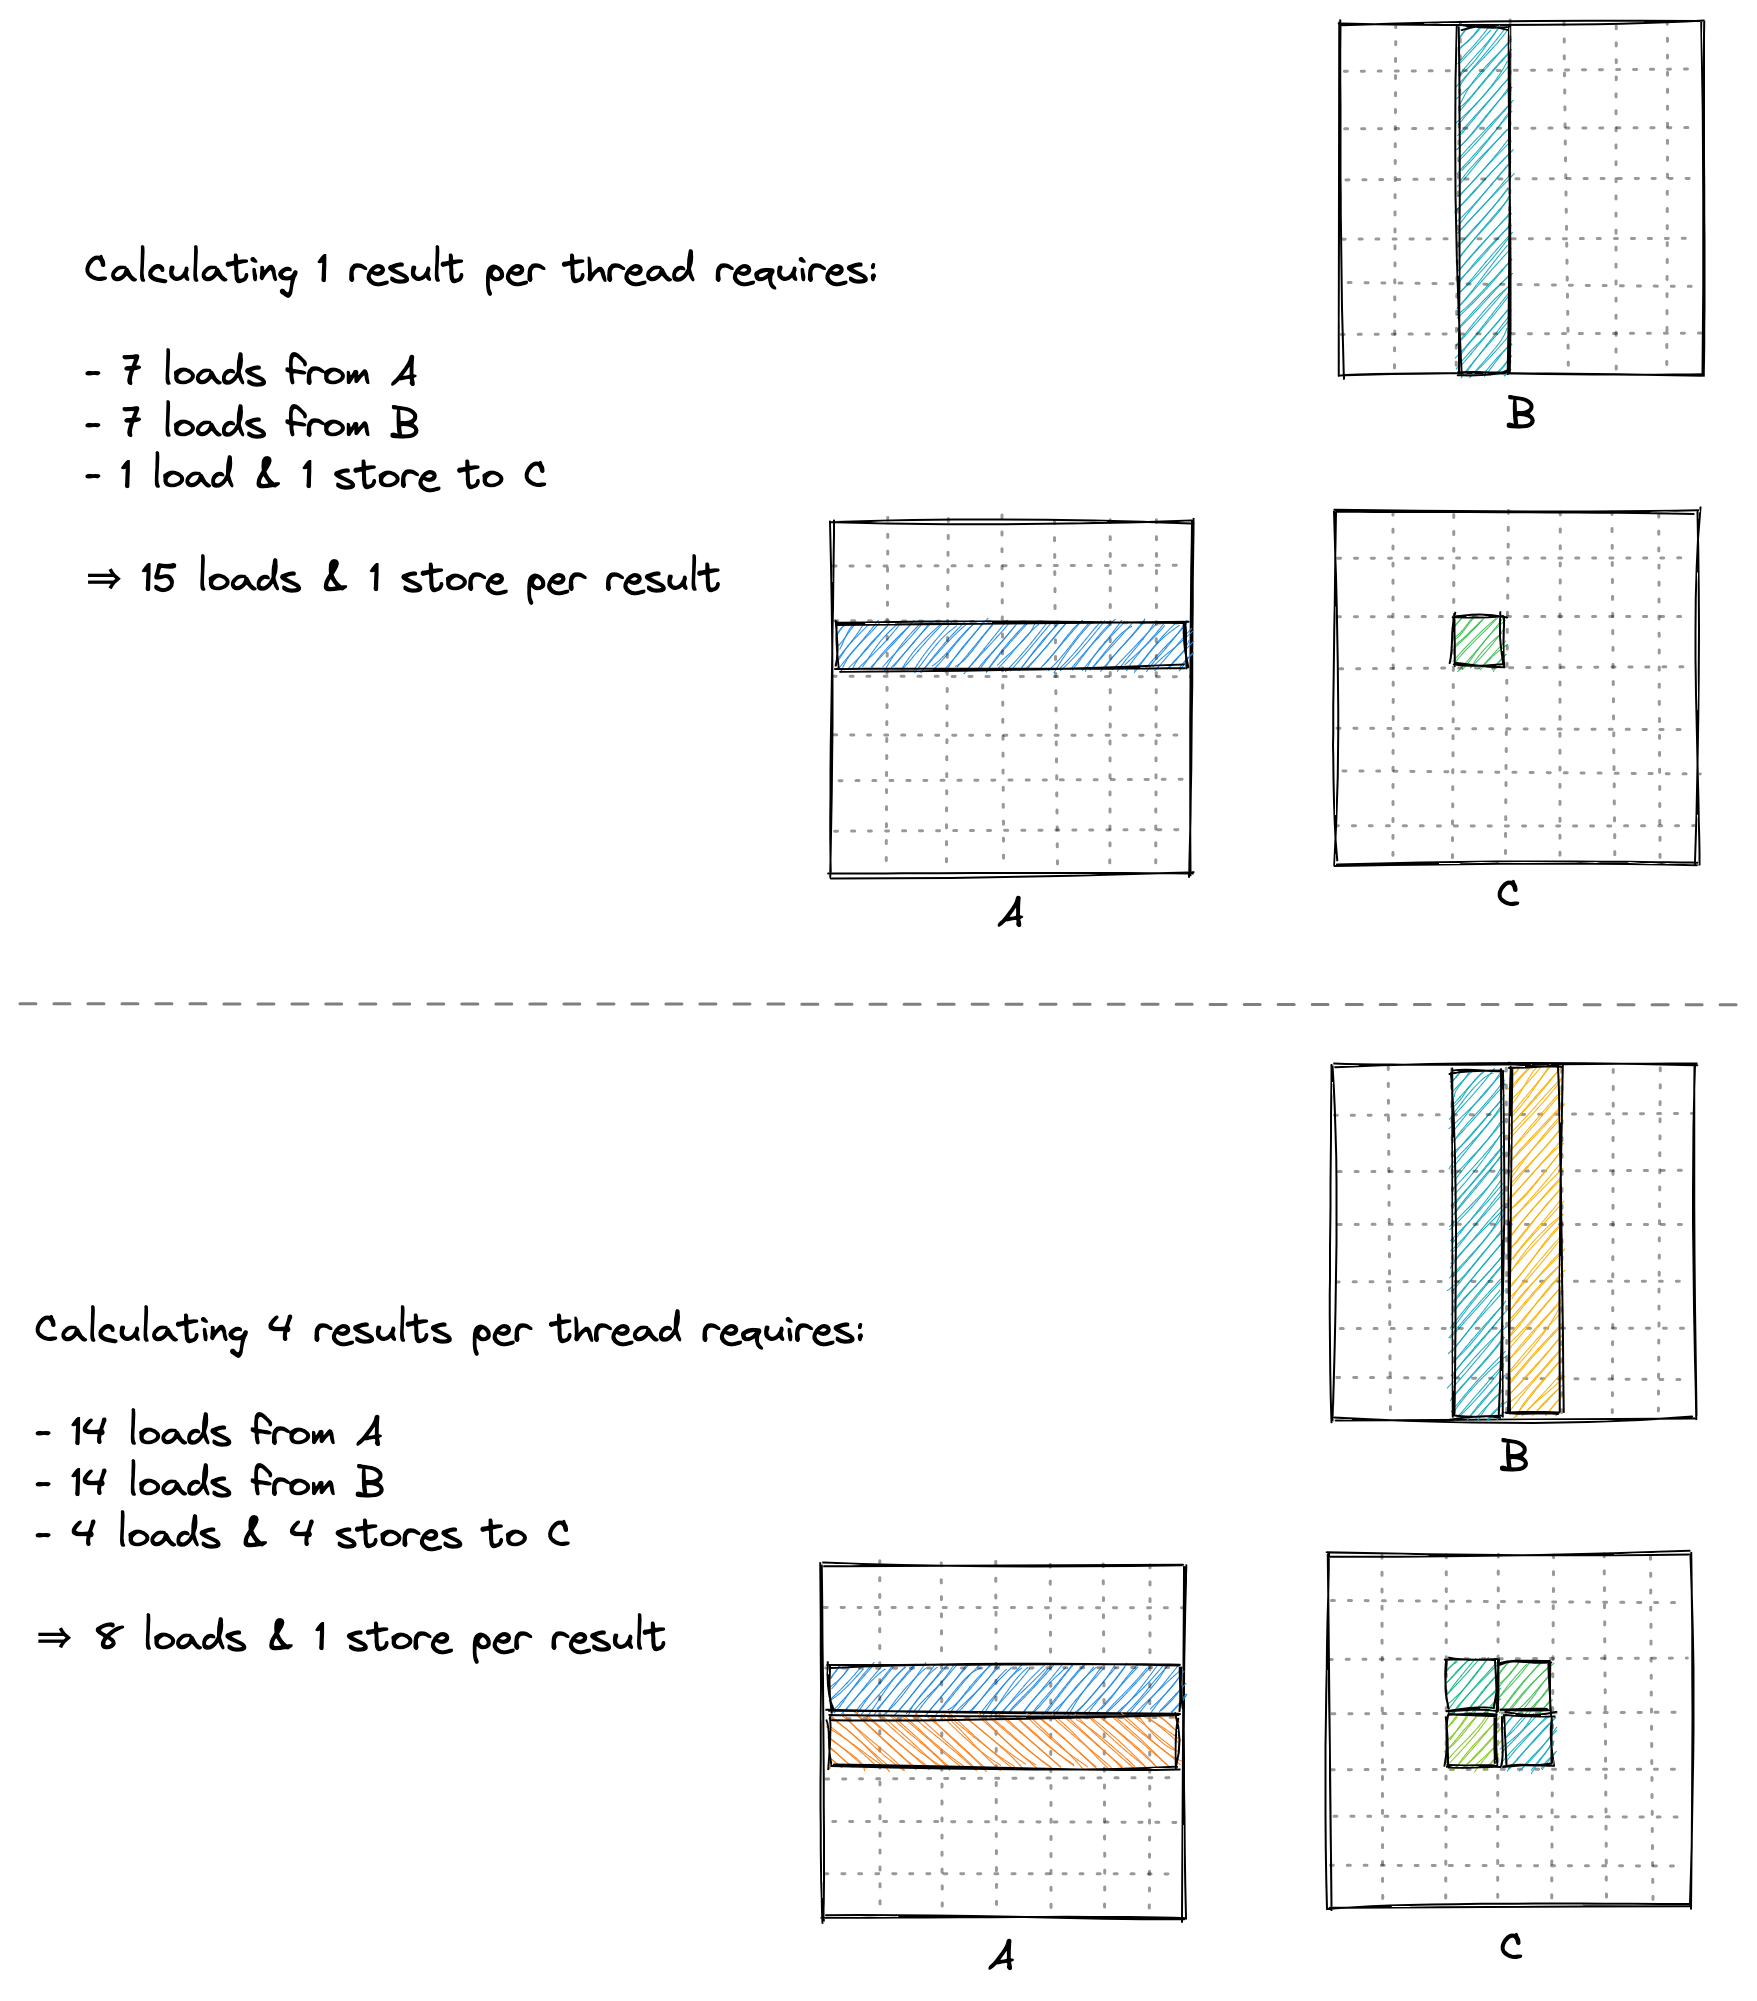
图 17 2D 寄存器分块大幅拉升算术强度:加载 2 个向量,直接做外积矩阵更新
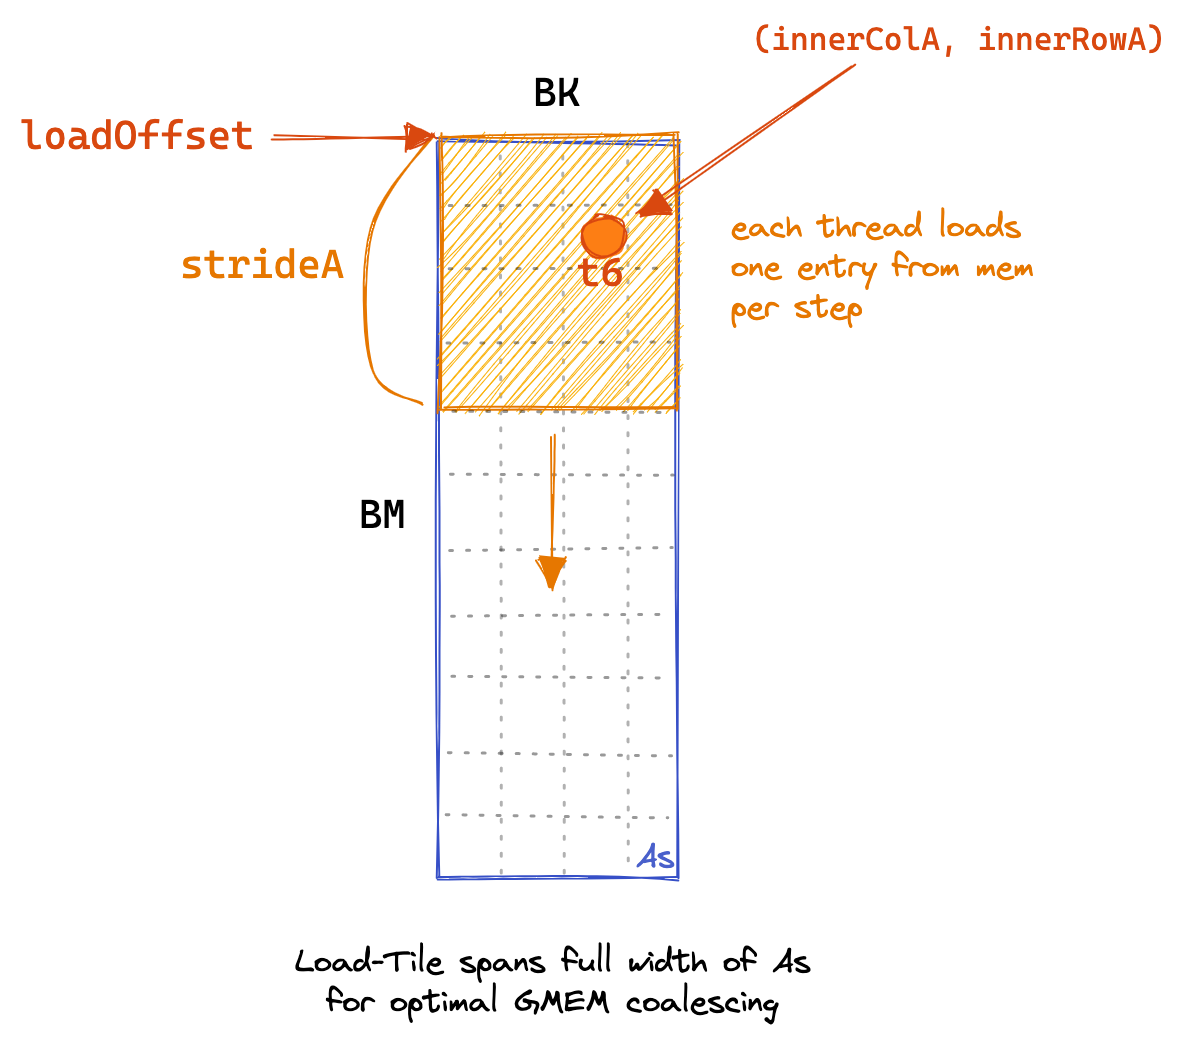
图 18 Kernel 5 全局内存到共享内存的协作填充过程
// Kernel 5 中协作填充共享内存缓存(BM=128, BN=128, BK=8,Block 内仅 256 线程):
// 256 个线程需搬运 128x8 = 1024 个 A 元素,因此每个线程必须循环多轮搬运!
// 步长 strideA = 线程总数 / BK = 256 / 8 = 32 行
for (uint loadOffset = 0; loadOffset < BM; loadOffset += strideA) {
  As[(innerRowA + loadOffset) * BK + innerColA] =
      A[(innerRowA + loadOffset) * K + innerColA];
}

// 类似地,多步长协同搬运 B 矩阵的 1024 个分块元素:
// 步长 strideB = 线程总数 / BN = 256 / 128 = 2 行
for (uint loadOffset = 0; loadOffset < BK; loadOffset += strideB) {
  Bs[(innerRowB + loadOffset) * BN + innerColB] =
      B[(innerRowB + loadOffset) * N + innerColB];
}

// 屏障同步:必须等待 256 线程将全部 2048 个浮点数全部落入 SMEM,才能开启外积计算!
__syncthreads();
在内层循环中,我们将 As 的一列(长度 TM)和 Bs 的一行(长度 TN)分别加载到 线程私有寄存器数组 regM 与 regN 中,然后执行 外积(Outer Product) 累加:
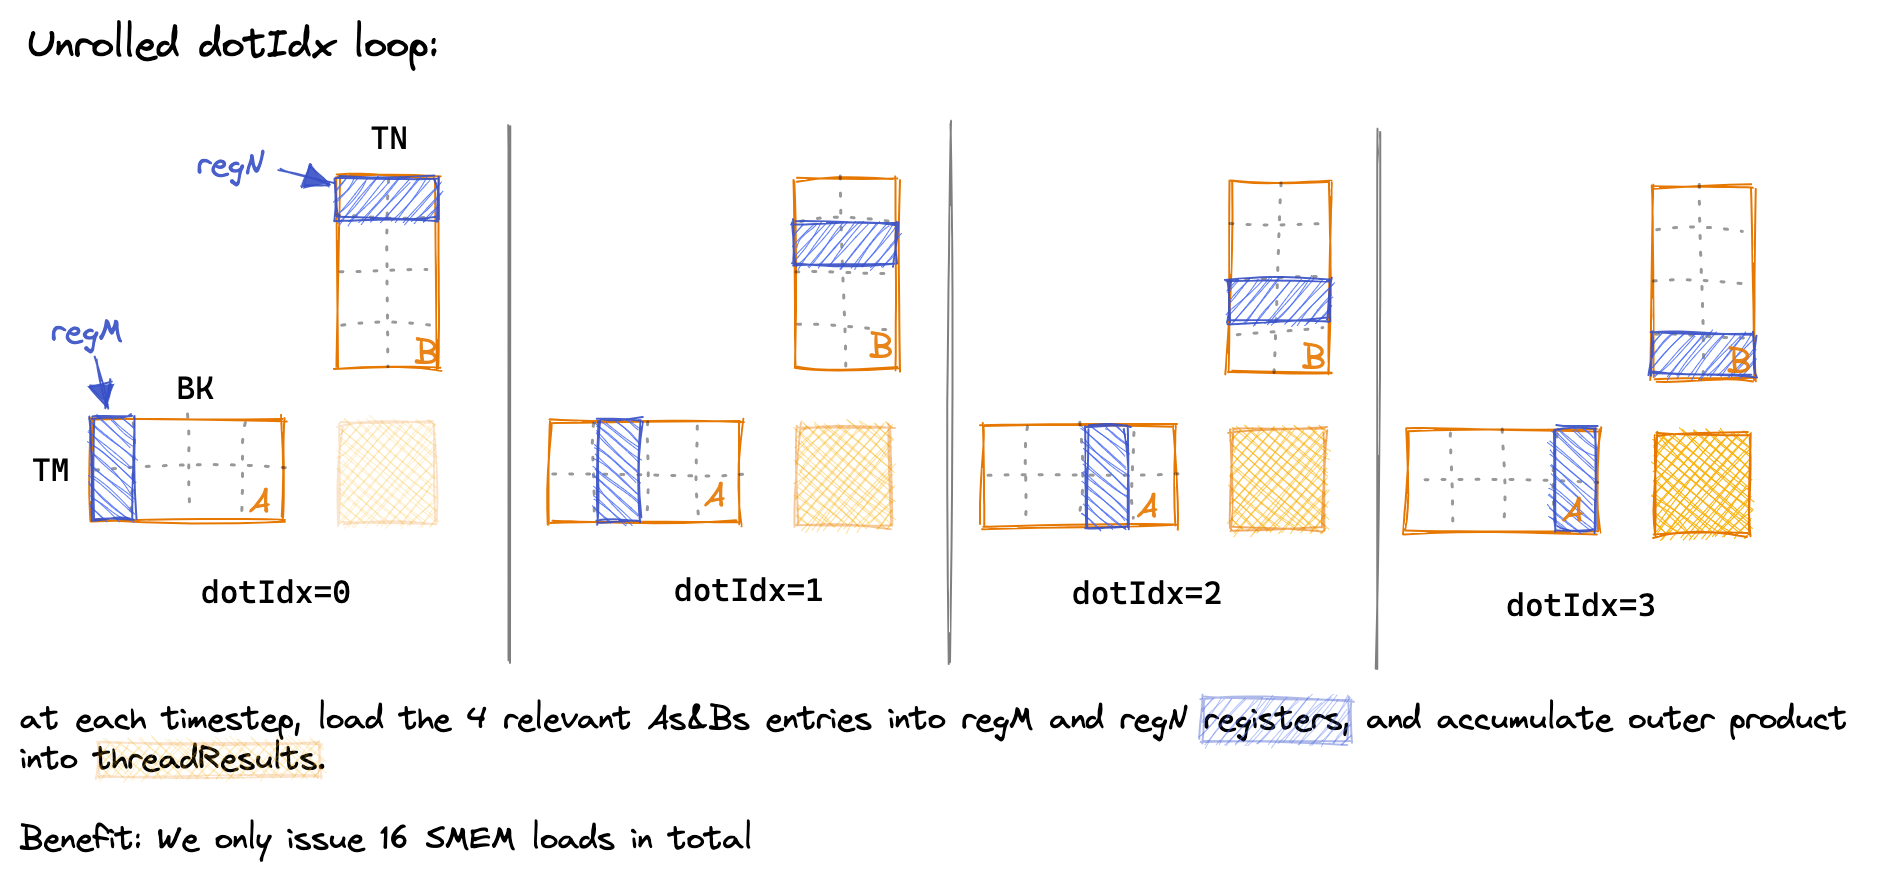
图 19 寄存器外积累加时间序列:从 SMEM 搬入寄存器,在纯寄存器内提升 FMA
// 1. 线程私有寄存器数组定义:
float threadResults[TM * TN] = {0.0f}; // 8x8 = 64 个累加寄存器,存放最终结果
float regM[TM] = {0.0f};               // 缓存 As 对应的当前列(8 个 float)
float regN[TN] = {0.0f};               // 缓存 Bs 对应的当前行(8 个 float)

// 2. 外层沿 K 轴滑动分块
for (uint bkIdx = 0; bkIdx < K; bkIdx += BK) {
  // 协作搬运:256 个线程通过多步长循环完整填充 128x8 的 As 和 8x128 的 Bs
  for (uint loadOffset = 0; loadOffset < BM; loadOffset += strideA) {
    As[(innerRowA + loadOffset) * BK + innerColA] =
        A[(innerRowA + loadOffset) * K + innerColA];
  }
  for (uint loadOffset = 0; loadOffset < BK; loadOffset += strideB) {
    Bs[(innerRowB + loadOffset) * BN + innerColB] =
        B[(innerRowB + loadOffset) * N + innerColB];
  }
  __syncthreads(); // 等待数据全部就绪

  A += BK;     // 指针向右滑 BK=8 列
  B += BK * N; // 指针向下滑 BK=8 行

  // 3. 计算阶段:遍历深度切片 dotIdx(0 到 7)
  for (uint dotIdx = 0; dotIdx < BK; ++dotIdx) {
    // 关键步 ①:从共享内存将 A 的 8 个元素读入寄存器向量 regM
    for (uint i = 0; i < TM; ++i) {
      regM[i] = As[(threadRow * TM + i) * BK + dotIdx];
    }
    // 关键步 ②:从共享内存将 B 的 8 个元素读入寄存器向量 regN
    for (uint i = 0; i < TN; ++i) {
      regN[i] = Bs[dotIdx * BN + threadCol * TN + i];
    }

    // 关键步 ③:执行 8x8 寄存器外积(Outer Product)!
    // 仅通过 8 + 8 = 16 次 SMEM 访存,就支撑起了 8 x 8 = 64 次纯寄存器间的 FMA 乘加!
    // 算术强度相比前代暴增 4 倍!
    for (uint resIdxM = 0; resIdxM < TM; ++resIdxM) {
      for (uint resIdxN = 0; resIdxN < TN; ++resIdxN) {
        threadResults[resIdxM * TN + resIdxN] +=
            regM[resIdxM] * regN[resIdxN];
      }
    }
  }
  __syncthreads();
}
此时每个结果的平均访存: GMEM 降至 K/64,SMEM 降至 K/4。
优化效果: 性能跨越至 15,971.7 GFLOPs(约 16 TFLOPs,达到 cuBLAS 的 68.7%) 。
7. Kernel 6: 向量化访存优化
为追求,我们进一步在内存指令层面压榨吞吐:
- 在写入 SMEM 时对 As 进行转置 :原本读取
As时在内存中不是跨步连续的,转置后,线程对As的读取也能使用 128 位宽向量化加载(SASS 中对应LDS.128指令); - 对全局内存使用
float4向量类型进行 128 位宽读写 :将单条 32 位的LDG.E指令替换为极速的LDG.E.128。
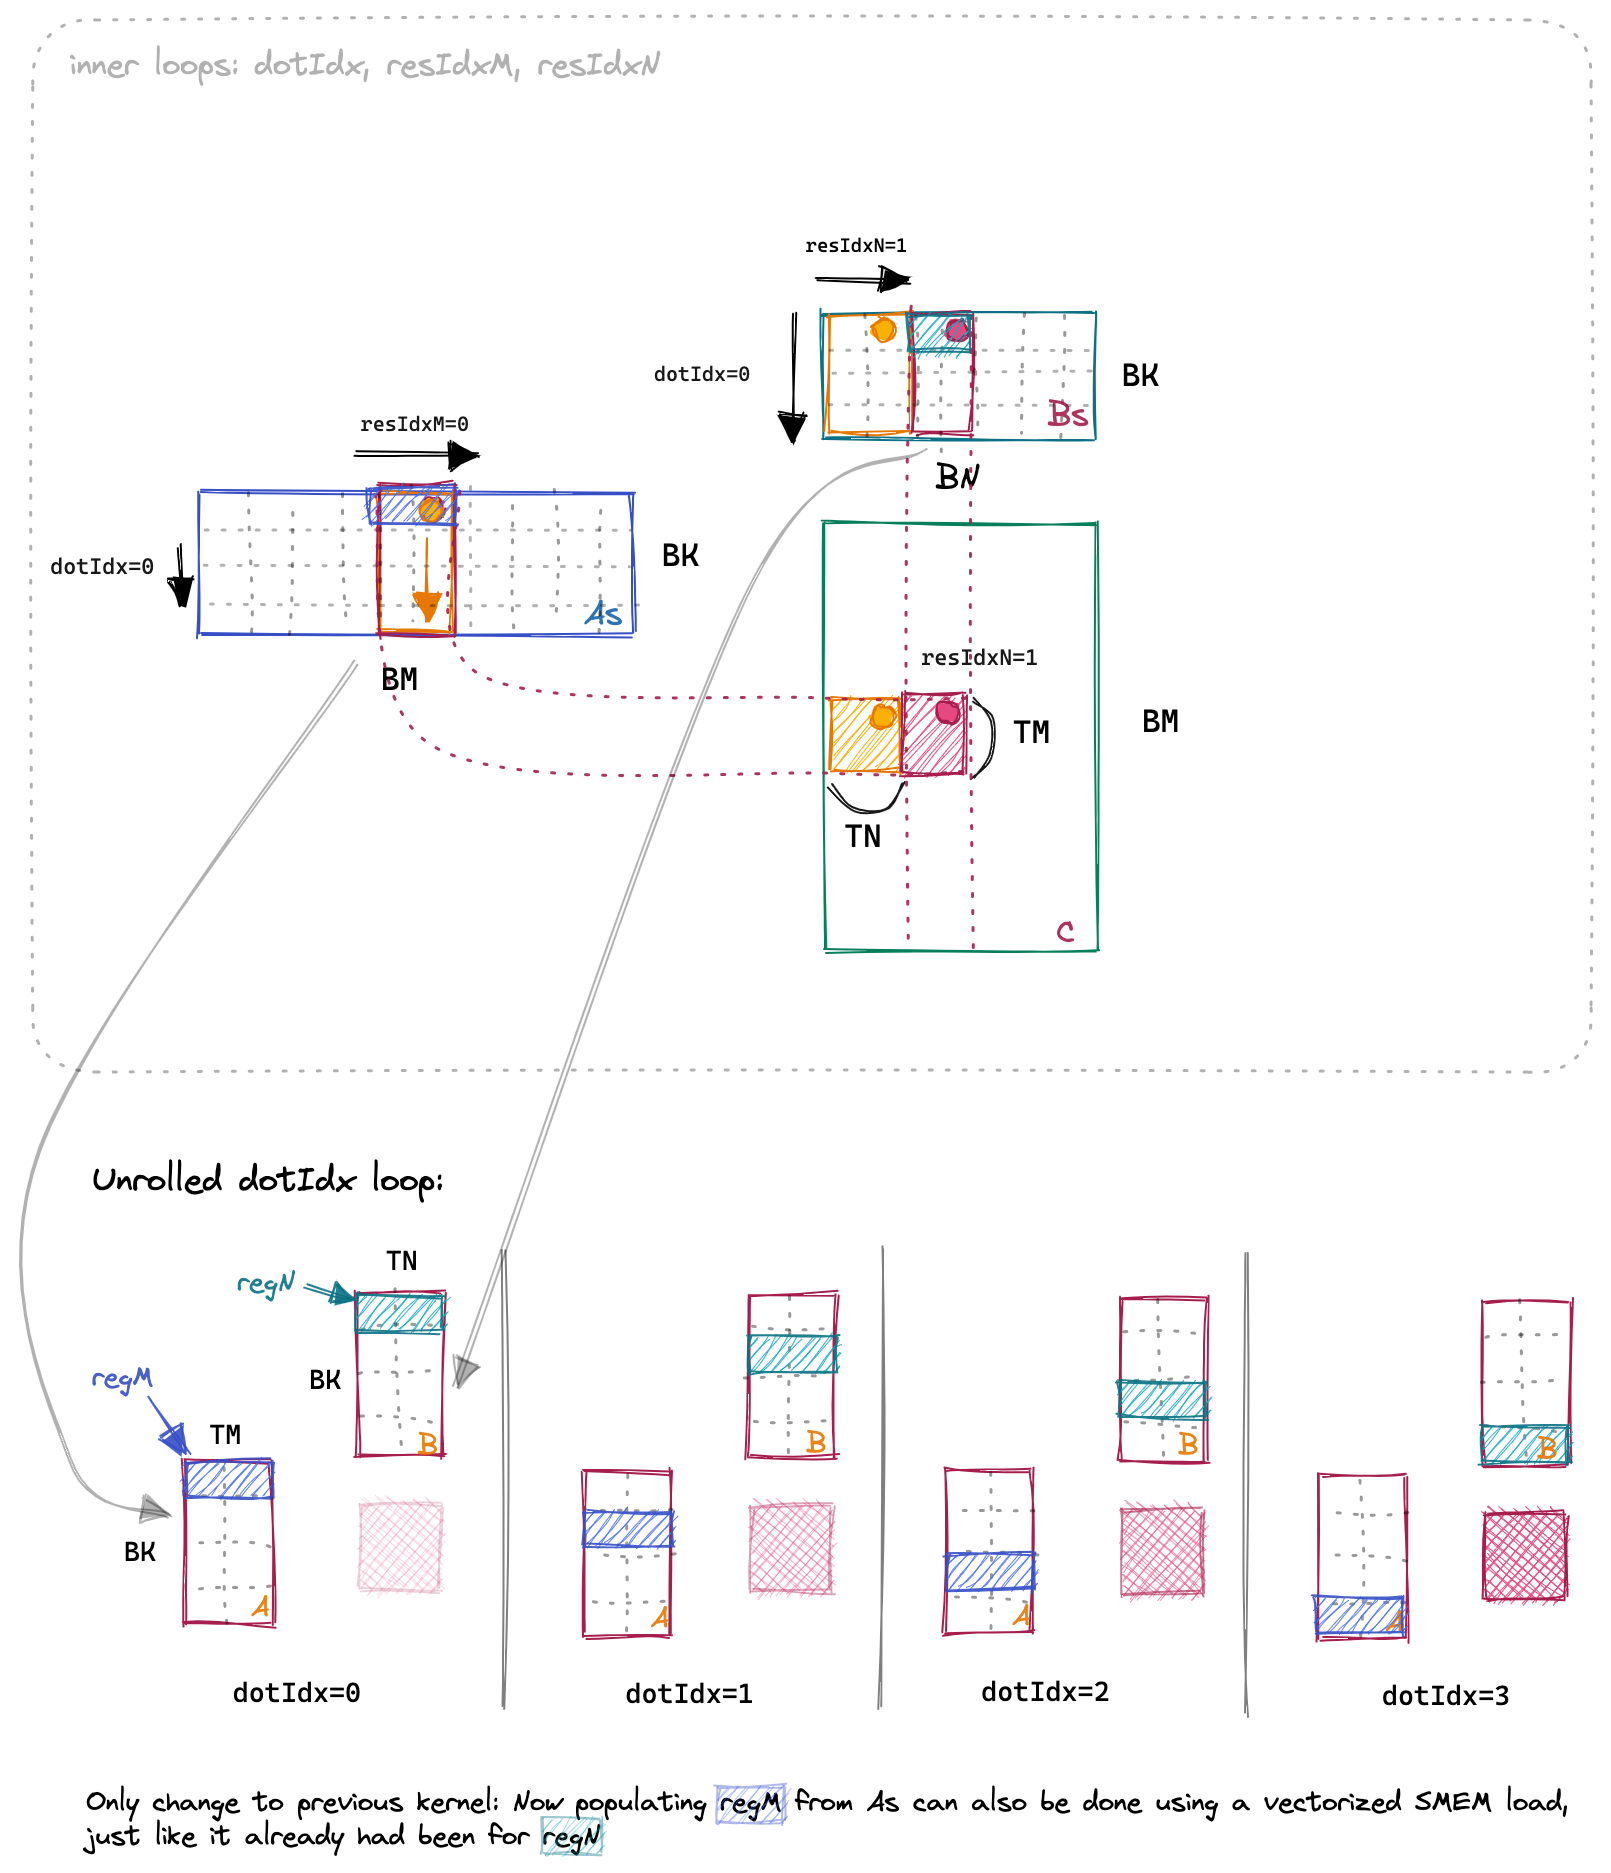
图 20 转置 As 布局:消除跨步读取,释放 LDS.128 向量化加载潜能
// 1. 向量化读取全局内存:
// 将 float* 强转为 float4* 指针,向编译器保证指针已按 16 字节对齐,
// 促使 NVCC 生成单条 128 位的全局加载指令(LDG.E.128)!
float4 tmp = reinterpret_cast<float4 *>(&A[innerRowA * K + innerColA * 4])[0];

// 2. 空间布局转置:在写入共享内存 As 时执行转置(行列调换存储)!
// 使得原本沿列分布的数据在共享内存中变成连续行存储,
// 从而让后续线程读取 As 时也能完全触发 LDS.128 向量化加载指令!
As[(innerColA * 4 + 0) * BM + innerRowA] = tmp.x;
As[(innerColA * 4 + 1) * BM + innerRowA] = tmp.y;
As[(innerColA * 4 + 2) * BM + innerRowA] = tmp.z;
As[(innerColA * 4 + 3) * BM + innerRowA] = tmp.w;

// 3. Bs 本身在内存中就是行主序连续的,直接 128 位对齐写入:
reinterpret_cast<float4 *>(&Bs[innerRowB * BN + innerColB * 4])[0] =
    reinterpret_cast<float4 *>(&B[innerRowB * N + innerColB * 4])[0];

__syncthreads();
为何需要 reinterpret_cast<float4*>?
C++ 编译器无法在编译期确认外部传入的 float* 指针是否符合 128 位(16 字节)对齐。强制指针转换的本质是程序员向编译器 立下契约 保证指针绝对已对齐,促使 NVCC 生成原生的 LDG.E.128 汇编指令。
// 方案 A:通过 reinterpret_cast<float4*> 向编译器立下 128 位对齐契约
reinterpret_cast<float4 *>(&Bs[innerRowB * BN + innerColB * 4])[0] =
    reinterpret_cast<float4 *>(&B[innerRowB * N + innerColB * 4])[0];

// 方案 B:手动展开 4 次标量循环(或使用 #pragma unroll)
Bs[innerRowB * BN + innerColB * 4 + 0] = B[innerRowB * N + innerColB * 4 + 0];
Bs[innerRowB * BN + innerColB * 4 + 1] = B[innerRowB * N + innerColB * 4 + 1];
Bs[innerRowB * BN + innerColB * 4 + 2] = B[innerRowB * N + innerColB * 4 + 2];
Bs[innerRowB * BN + innerColB * 4 + 3] = B[innerRowB * N + innerColB * 4 + 3];

// 深度机理:
// 为何编译器不能自动将方案 B 优化为 128 位宽加载?
// 原因是函数入参为裸指针 float* B,编译器在编译期无法求证其运行时是否严格 16 字节对齐!
// 显式 reinterpret_cast<float4*> 充当了程序员向编译器的对齐担保,合法解锁了 LDG.E.128 原生向量指令!
优化效果: 性能推进至 18,237.3 GFLOPs(cuBLAS 的 78.4%) 。
8. Kernel 9: 参数自动调优
目前我们的 Kernel 积累了 5 个核心编译期模板参数:
BM, BN, BK:从全局内存缓存到共享内存的 Tile 体积;TM, TN:从共享内存缓存到寄存器的单线程工作分块体积。
通过编写搜索脚本,在排除硬件非法的无效参数后,针对 RTX A6000 进行自动化调优探索:
- RTX A6000 最佳参数 :
BM=BN=128, BK=16, TM=TN=8,性能提升至 19,721.0 GFLOPs(84.8%) ; - A100 架构最佳参数 :由于架构硬件差异,最佳设置为
BM=BN=64, BK=16, TM=TN=4。这直接证明了高性能底层计算库(如 Triton / cuBLAS)必须配备 Autotuning 机制的原因。
9. Kernel 10: 线程束级分块
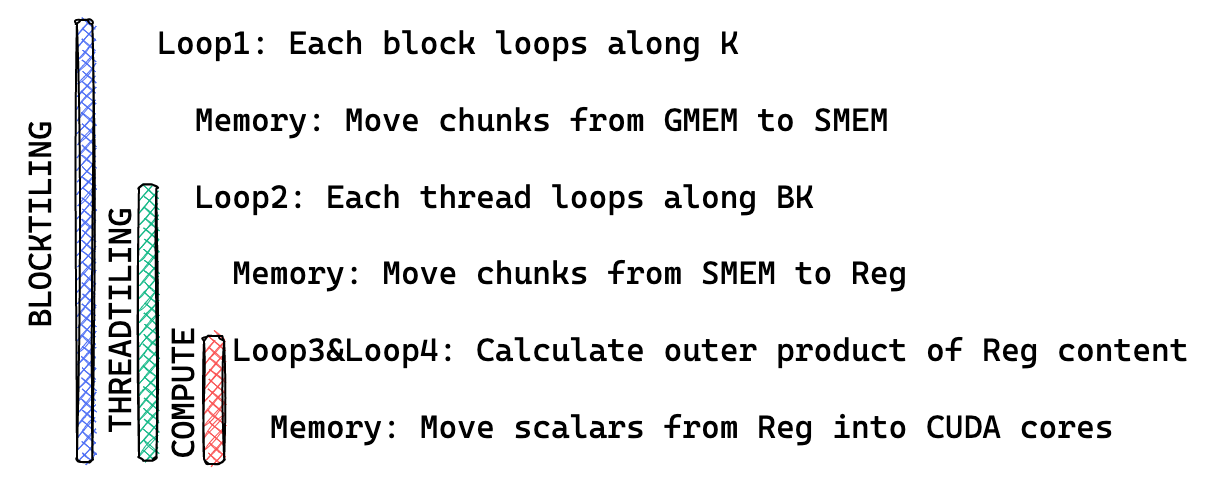
图 21 当前循环结构示意:Block 级与 Thread 级之间仍缺少一层关键纽带
在 Blocktiling 与 Threadtiling 之间,我们正式引入第三层分块: Warptiling(线程束级分块) 。
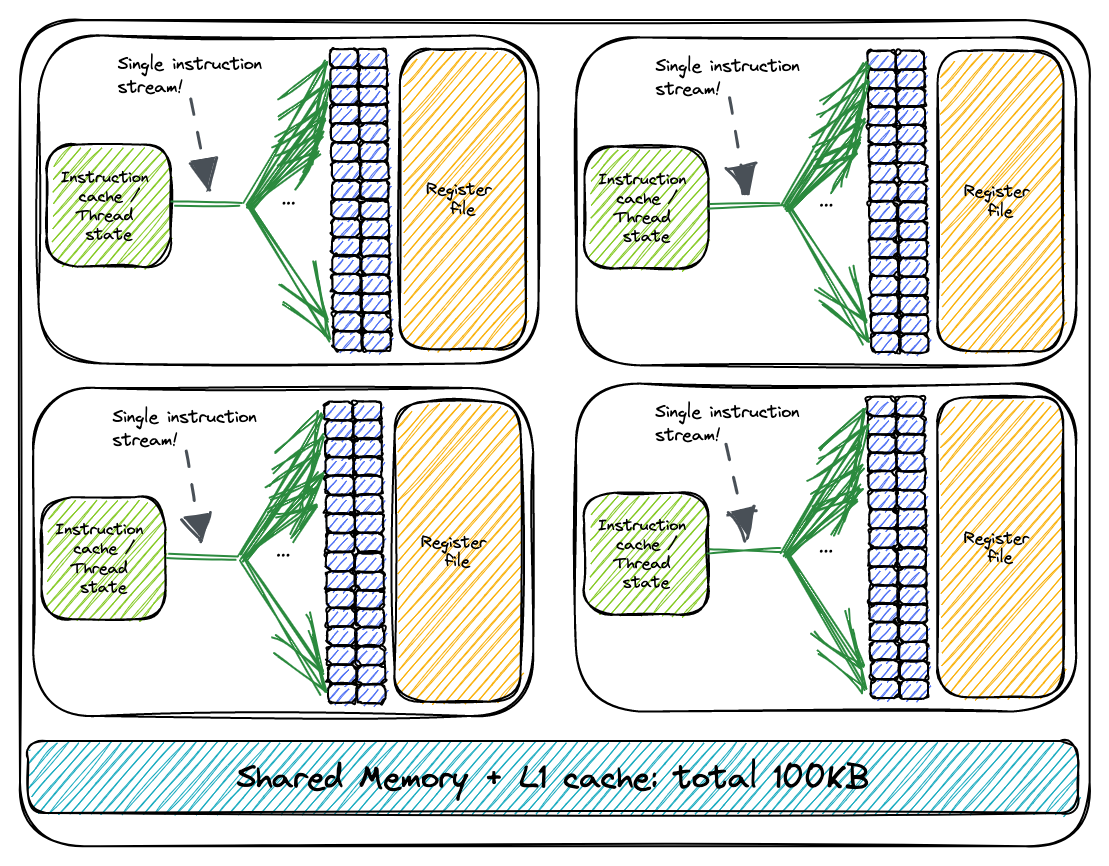
图 22 SM 内部通常包含 4 个 Warp 调度器,Warptiling 结合线程束的分工组织计算
引入 Warptiling 的三重收益:
- 消除共享内存 Bank 冲突 :Bank 冲突仅发生于同一 Warp 内各线程之间。通过将连续的 Warp 分配到彼此独立的 Warptile,从根本上隔离了不同 Warp 间的 SMEM 竞争;
- 提升寄存器缓存局部性 :紧凑的局部数据排列使得现代 GPU 的寄存器缓存命中率更高;
- 为未来迁移 Tensor Core 铺路 :Tensor Core 的
mma.sync指令本身就是以 Warp 为单位调用的,Warptiling 为其提供了天然的切分结构。
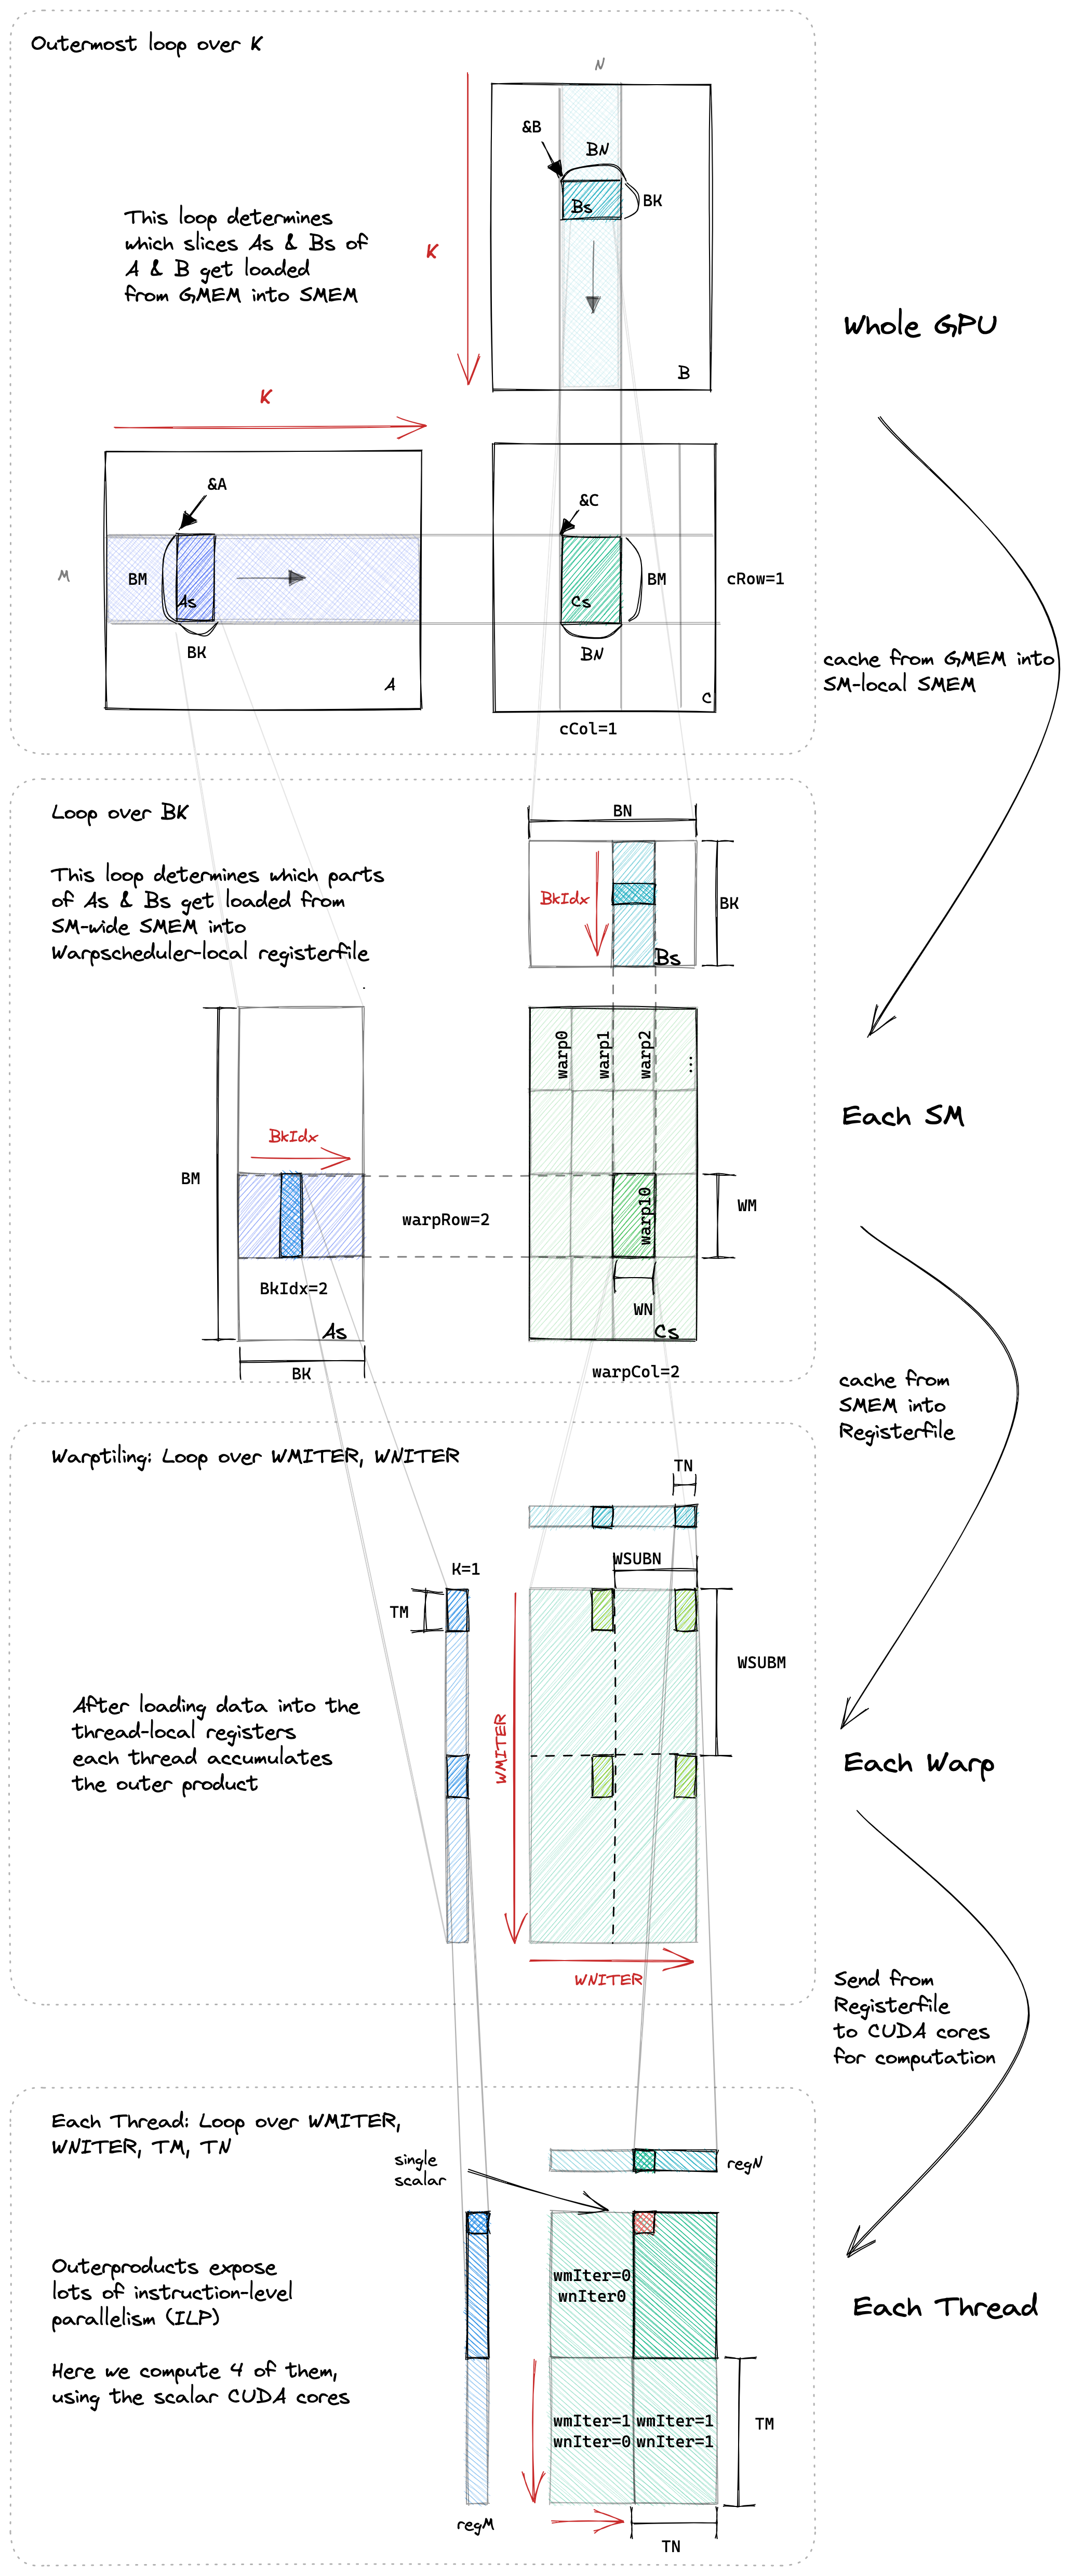
图 23 三级分块完整金字塔:Blocktile (跨 SM) Warptile (跨调度器) Threadtile (指令级并行)
核心计算代码:
// 核心计算循环:三级分块金字塔
// 沿 K 维度遍历共享内存内容(dotIdx 0 到 BK-1)
for (uint dotIdx = 0; dotIdx < BK; ++dotIdx) {
  // 1. 为当前 Warp 分配的子矩阵填充寄存器 regM:
  // 映射硬件坐标:warpRow(Warp 在 Block 内的行号)、wSubRowIdx(Warp 内部子迭代)
  // 精准将当前线程在 Warp 内所需的数据从 SMEM 搬入寄存器
  for (uint wSubRowIdx = 0; wSubRowIdx < WMITER; ++wSubRowIdx) {
    for (uint i = 0; i < TM; ++i) {
      regM[wSubRowIdx * TM + i] =
          As[(dotIdx * BM) + warpRow * WM + wSubRowIdx * WSUBM +
             threadRowInWarp * TM + i];
    }
  }

  // 2. 为当前 Warp 分配的子矩阵填充寄存器 regN:
  for (uint wSubColIdx = 0; wSubColIdx < WNITER; ++wSubColIdx) {
    for (uint i = 0; i < TN; ++i) {
      regN[wSubColIdx * TN + i] =
          Bs[(dotIdx * BN) + warpCol * WN + wSubColIdx * WSUBN +
             threadColInWarp * TN + i];
    }
  }

  // 3. 执行 Warptile 矩阵乘法:
  // 这一步与硬件 Warp 调度器相匹配,改善线程束内的数据复用;Bank 冲突还取决于实际的访存布局,
  // 并且具备较好的寄存器局部性(Register Cache Locality)!
  for (uint wSubRowIdx = 0; wSubRowIdx < WMITER; ++wSubRowIdx) {
    for (uint wSubColIdx = 0; wSubColIdx < WNITER; ++wSubColIdx) {
      for (uint resIdxM = 0; resIdxM < TM; ++resIdxM) {
        for (uint resIdxN = 0; resIdxN < TN; ++resIdxN) {
          threadResults[(wSubRowIdx * TM + resIdxM) * (WNITER * TN) +
                        (wSubColIdx * TN) + resIdxN] +=
              regM[wSubRowIdx * TM + resIdxM] * regN[wSubColIdx * TN + resIdxN];
        }
      }
    }
  }
}
最终战果: 在 A100 上性能从 19.7 TFLOPs 冲顶至 21,779.3 GFLOPs(21.78 TFLOPs) ,达到了官方 cuBLAS 的 93.7% 。
10. cuBLAS 领先的性能差异与全尺寸 Benchmark
我们将优化后的 Kernel 10 与 cuBLAS 在不同矩阵尺寸(256 到 4096)下进行全面横向对比:
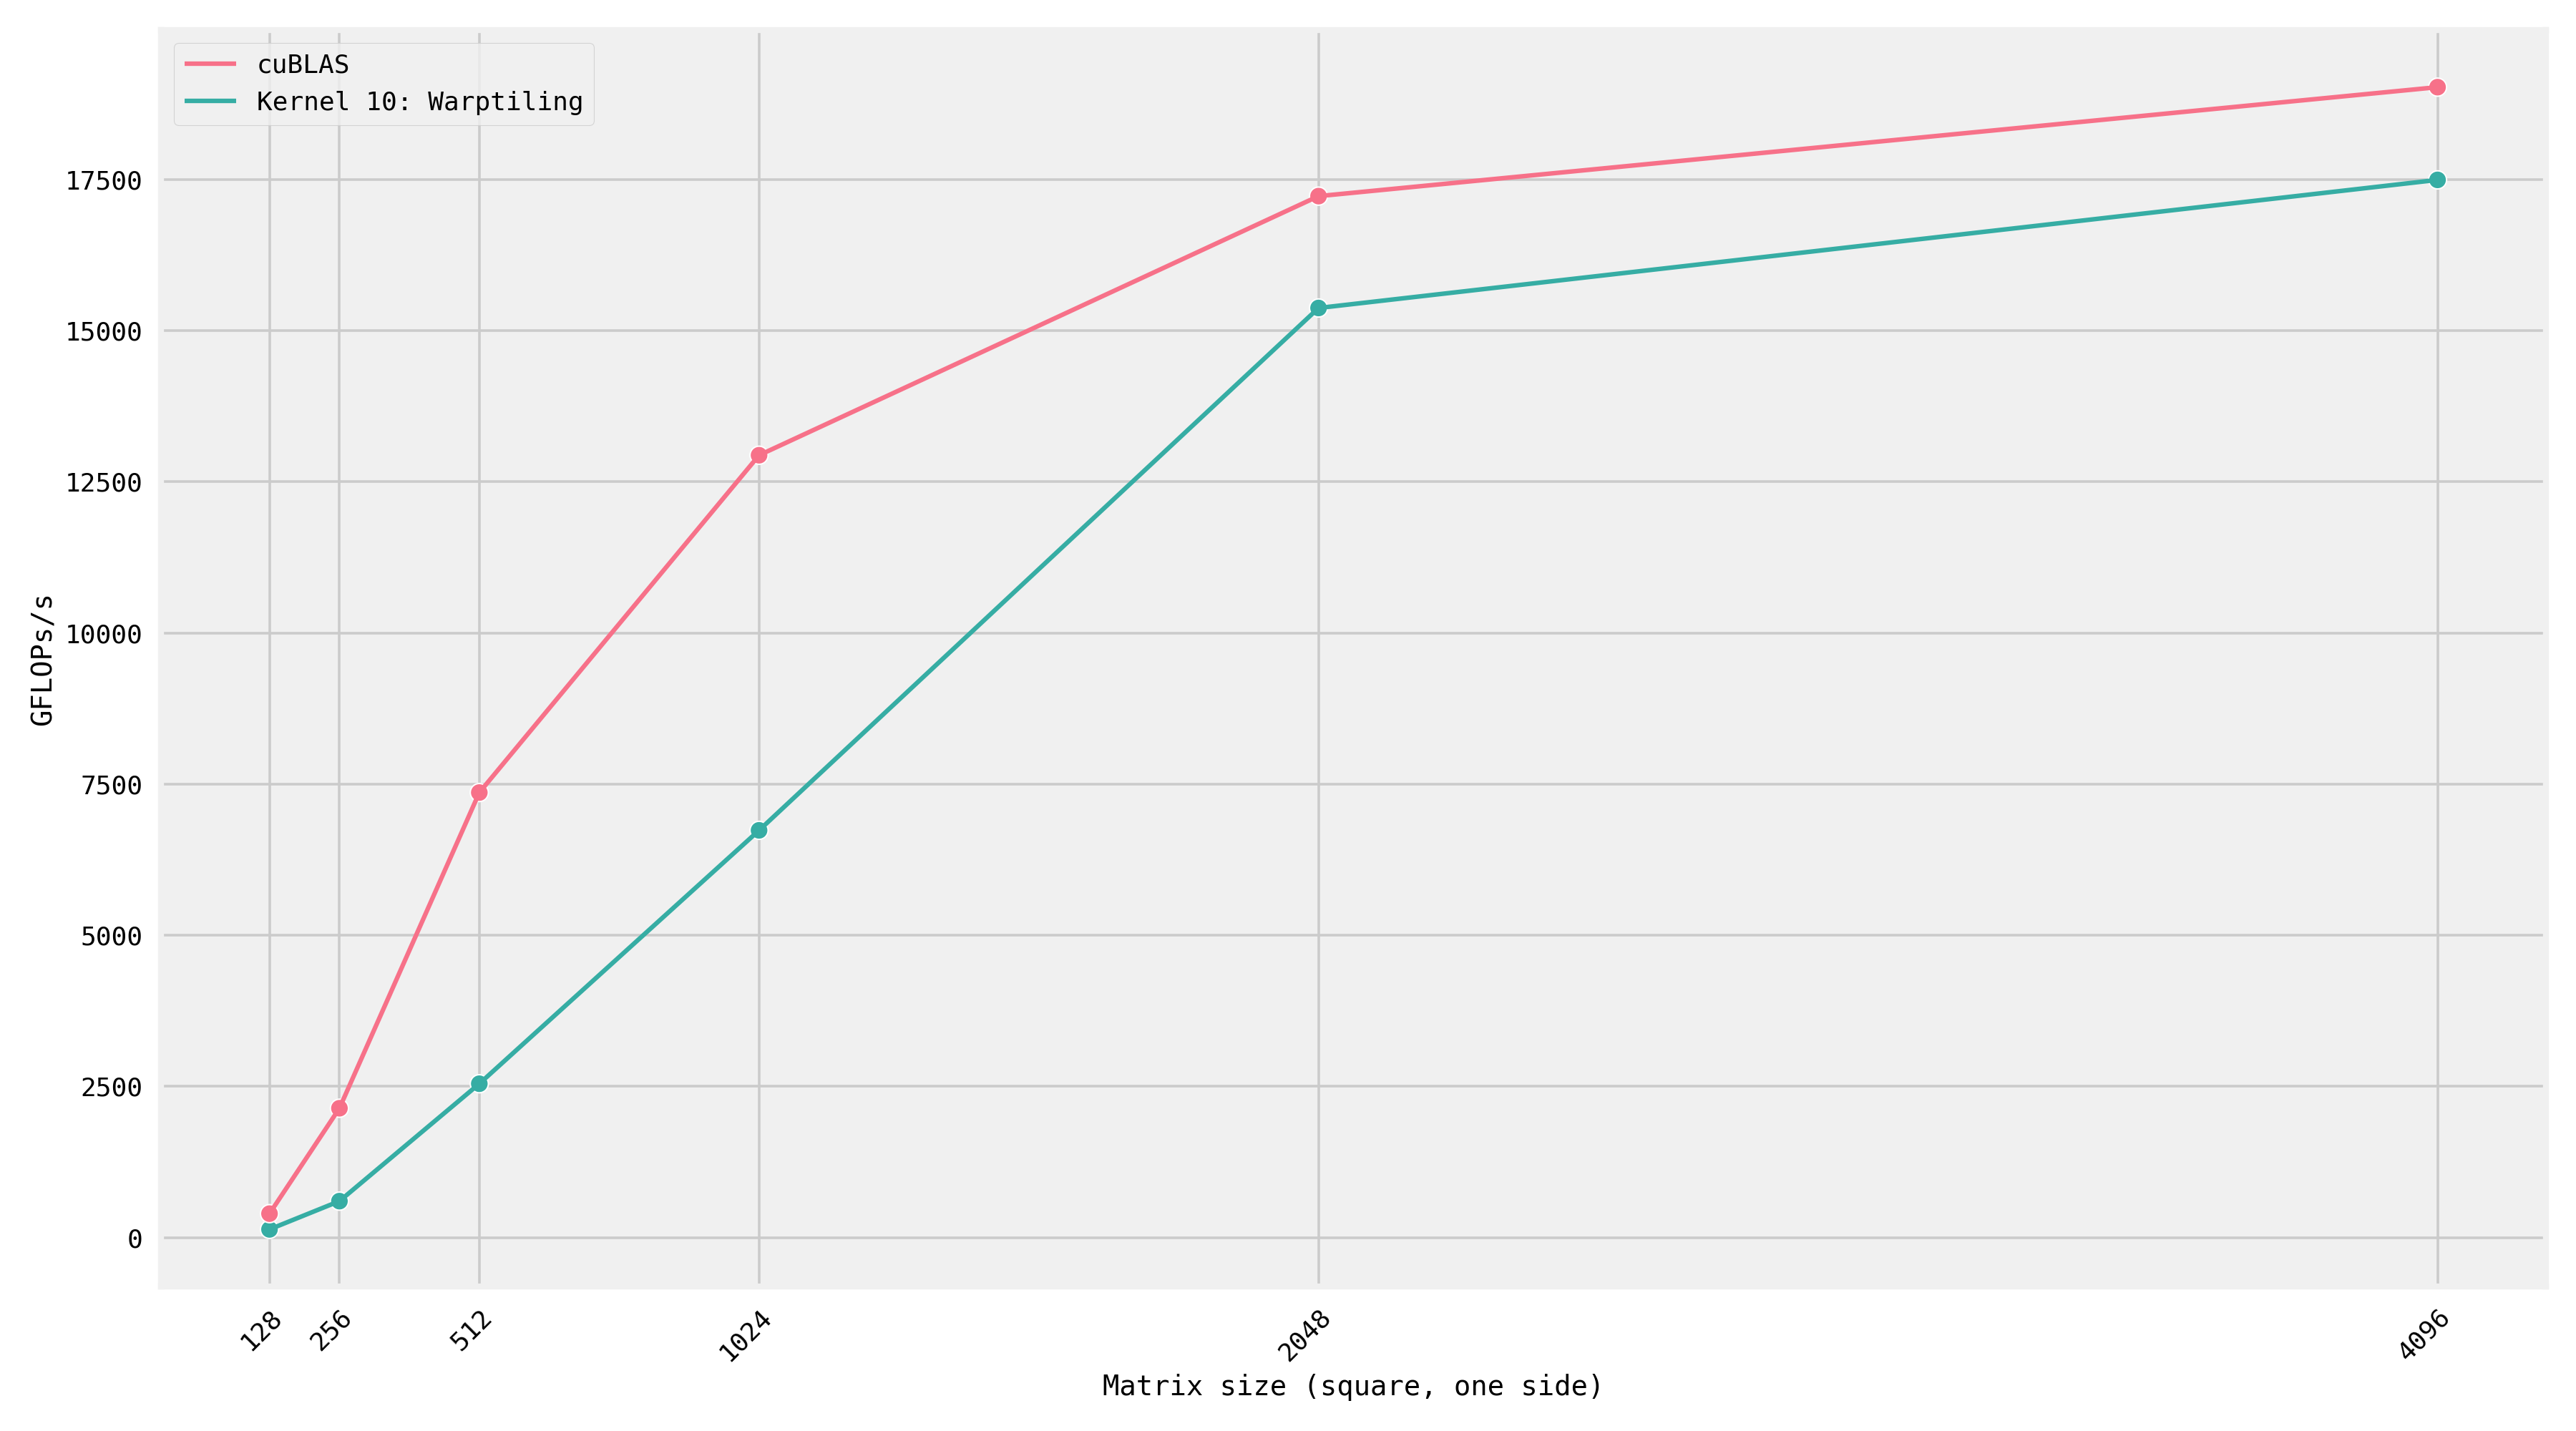
图 24 各尺寸下的性能对比曲线:在大矩阵下两者旗鼓相当,但在小尺寸下 cuBLAS 依然大幅领先
在大尺寸(2048、4096)下,我们的算力已经与 cuBLAS 仅差几个百分点。但在 256~512 的小尺寸下,cuBLAS 为何快得多?
cuBLAS 的制胜法宝:动态内核派发与 Split-K 技术。
cuBLAS 编译出的二进制体积高达 500MB,里面内置了成百上千个针对不同矩阵形态特化的 Kernel。在运行时,cuBLAS 会根据输入尺寸动态调度最合适的内核。
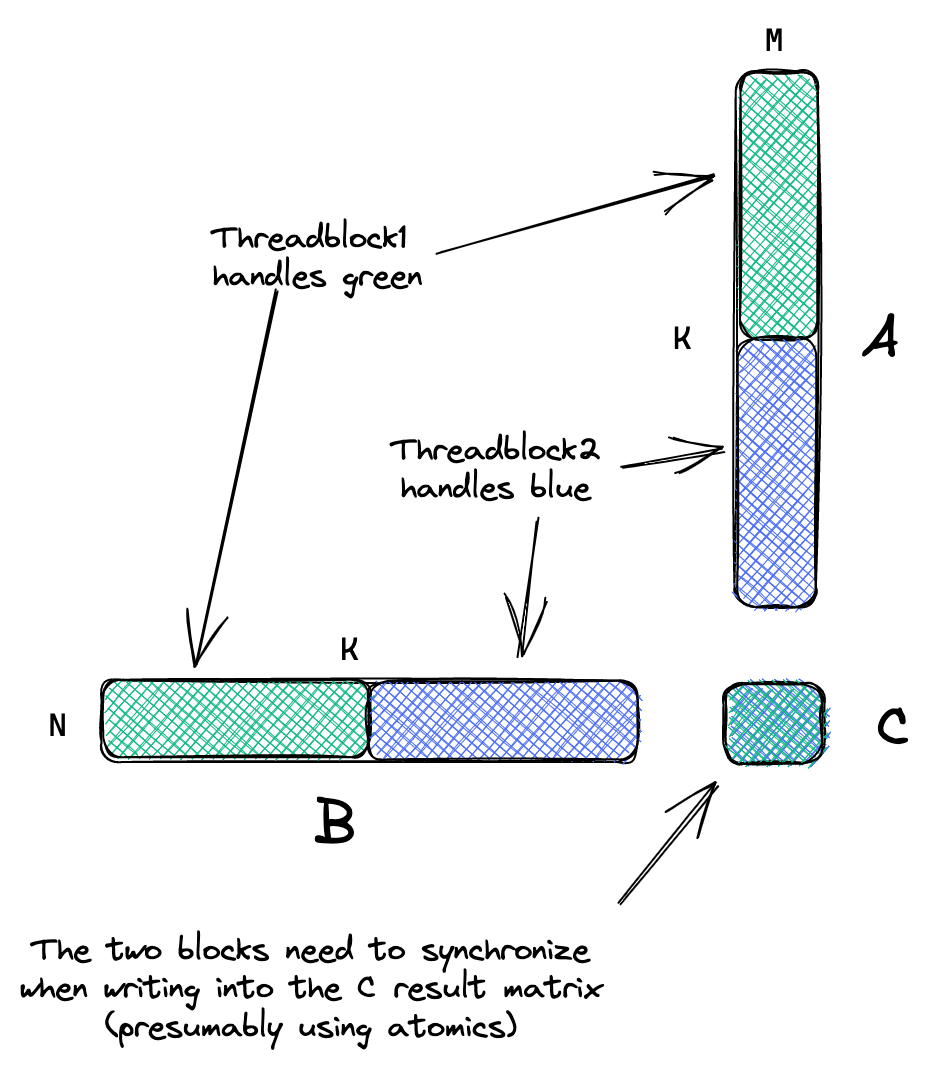
图 25 Split-K 机制:将 K 轴切分给多个 Block 并行累加,最后调用规约 Kernel 聚合结果
在尺寸为 256 时,如果只切分 M 和 N,生成的 Block 数量太少,连 GPU 的 84 个 SM 都填不满。cuBLAS 在此场景下启动 Split-K 策略 :不仅切分 M、N,还把 K 维度切分到多个 Block 并行计算部分和,最后追加启动一个 splitKreduce_kernel 进行规约合并,从而在小尺寸下跑满 GPU 吞吐。
11. 探索未尽与总结
未完工的 Kernel 11 探索方向:
- 软件流水线与双缓冲(Double Buffering) :借鉴 CUTLASS 模式,在当前步计算的同时,异步预取下一步的数据(涵盖 GMEM SMEM 与 SMEM 寄存器两级流水),彻底重叠计算与访存开销;
- Hopper 架构新特性 :利用 TMA(Tensor Memory Accelerator)硬件指令直接实现 GMEM 到 SMEM 的异步搬运,完全释放寄存器压力;
- 彻底消除 SMEM 内部 Bank Conflict :通过对 SMEM 进行特定的 Padding 和 Swizzle 数据排布,实现真正的零冲突。
实战工程心得
幂律分布无处不在 :用两个周末写出的前 6 个 Kernel 就拿下了 80% 的峰值性能;而为了攻克后续的自动调优与 Warptiling,又花了整整 4 个周末才提升到 94%。越接近物理极限,收益递减越显著。
第一性原理可视化是 CUDA 优化的神器 :一旦能够在草稿纸或 Excalidraw 上把数据流动与线程协作的几何拓扑画得一清二楚,写出高性能 CUDA 代码就变成了自然而然的水到渠成。