深入浅出 FlashAttention:快如闪电的精确注意力机制与 IO 感知计算
从第一性原理、GPU 显存金字塔到 Online Softmax 动态分块与反向重计算的全景图解推导。
原文标题:ELI5: FlashAttention
作者:Aleksa Gordic | 发布时间:2023年7月18日
副标题:从第一性原理到 GPU 显存金字塔,像独立发明者一样从零推导快如闪电的精确注意力机制
原论文:FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(NeurIPS 2022,Tri Dao 等)
这篇博文的核心目标,是用深入浅出(ELI5,Explain Like I’m 5)的方式彻底讲透 FlashAttention。希望任何此前已经理解标准注意力机制(Attention)的读者,在读完全文后都能由衷感叹两句话:
“为什么我以前没有想到这个方法?”
“它的核心逻辑原来如此自然而优雅。”
我们将严格从**第一性原理(First Principles)**出发。首先理解原生标准注意力机制(Standard/Vanilla Attention)在现代计算硬件上的执行瓶颈,然后逐一拆解、攻破其效率缺陷——就像我们自己正在从零独立发明 FlashAttention 一样。
此外,本文的另一个附带目标是帮大家破除来自编译器与系统底层社区的若干高频“黑话”迷雾:例如 Kernel(算子/核函数)、Kernel Fusion(算子融合)、Materialization(显存物化) 等概念。
💡 说明
本文不再对基础的 Attention 机制本身做入门科普。如果不熟悉 Attention 的基本矩阵运算,推荐先阅读 Jay Alammar 的经典图解文章 The Illustrated Transformer。
目录
- 论文标题解构:四大关键词
- 为什么需要“IO 感知”?——算力墙与算术强度
- GPU 显存金字塔与标准注意力的“罪状”
- 编译器优化的第一绝技:算子融合与显存物化
- FlashAttention 的两大核心支柱
- 分块的核心瓶颈与数学破局:Online Softmax
- 前向传播:逐行算法全景深度拆解
- 进阶扩展:Block-Sparse FlashAttention
- 显存与访存复杂度分析
- 连接现实世界工程:多 Head、反向重计算与 Triton
- 总结与第一性原理思考
- 参考文献与拓展资料
第一部分:论文标题解构——四大关键词
在深入算法细节前,我们先来剖析原始论文的标题:
“FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness”
(FlashAttention:基于 IO 感知的高速、显存高效精确注意力机制)
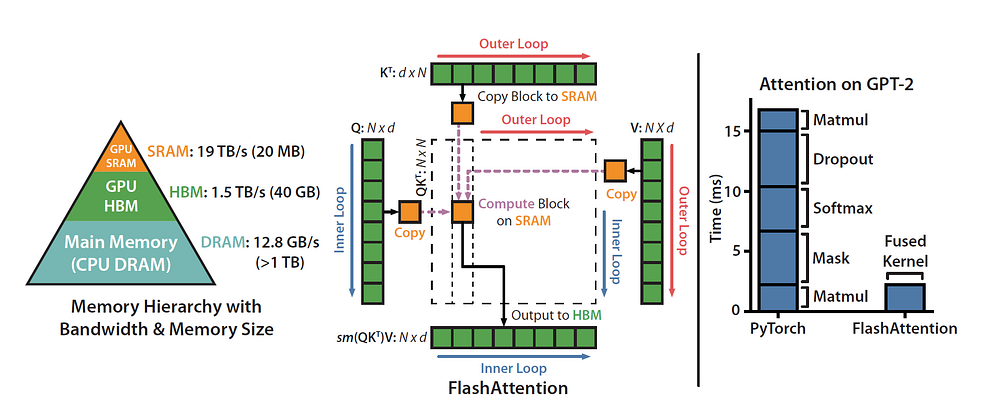
读完本文后,你将能够毫不费力地完全看懂上面这张全景架构对比图。标题中的四个核心特性概括了它的全部魔力:
- 快(Fast):
- 论文实测数据:在 BERT-large(序列长度 512)上,训练速度比当时 MLPerf 1.1 的最快世界纪录还要快 15%;
- 在 GPT-2(序列长度 1K)上,比 Hugging Face 和 Megatron-LM 的标准基线实现快 3 倍;
- 在长文本基准 Long-Range Arena(序列长度 1K~4K)上,比基线加速 2.4 倍。
- 显存高效(Memory-Efficient):
- 原生标准注意力的中间激活值显存占用随序列长度 N 呈二次方增长(
O(N²)); - FlashAttention 将运行时的额外显存开销直接降至线性(
O(N))。稍后我们会深入剖析其数学与工程原理。
- 原生标准注意力的中间激活值显存占用随序列长度 N 呈二次方增长(
- 数学精确(Exact):
- 它绝非近似注意力(不同于 Sparse Attention 稀疏注意力或 Low-Rank 低秩矩阵逼近等有损方案);
- 它的数学计算结果与原生标准注意力在数值上是完全等价的,无需在模型精度与推理质量上做任何妥协。
- IO 感知(IO-Aware):
- 如果说标准注意力对底层硬件是“盲目”的,那么 FlashAttention 则是对硬件“觉醒且通透”的。
所谓 IO 感知(IO-Awareness),绝不是把底层 GPU 当作一个纯粹黑盒的数值计算黑洞。相反,它深度契合并主动利用底层硬件的显存层级架构(Memory Hierarchy)(以 GPU 为典型代表,但该思想同样普适于各类 AI 专用加速器)。
第二部分:为什么需要“IO 感知”?——算力墙与算术强度
为什么更多的理论浮点算力(FLOPS)往往不能线性转化为端到端运行时间(Wall-Clock Time)的加速?直觉上似乎多给算力就该更快,但如果你理解底层硬件的工作方式,答案就会显而易见。
论文中有一段极其深刻的论述:
“尽管现有的近似注意力方法将计算量缩减到了序列长度的线性或近似线性级别,但许多方法在真实的物理耗时上却并未展现出相对于标准注意力的加速,因而在工业界未能得到广泛普及。核心根源在于:它们只专注于缩减浮点计算量(FLOPs)(这往往与实际物理耗时并不强相关),却普遍忽视了来自**内存访问(Memory IO)**的严重开销。”
问题到底出在哪里?答案在于现代硬件的演进失衡:
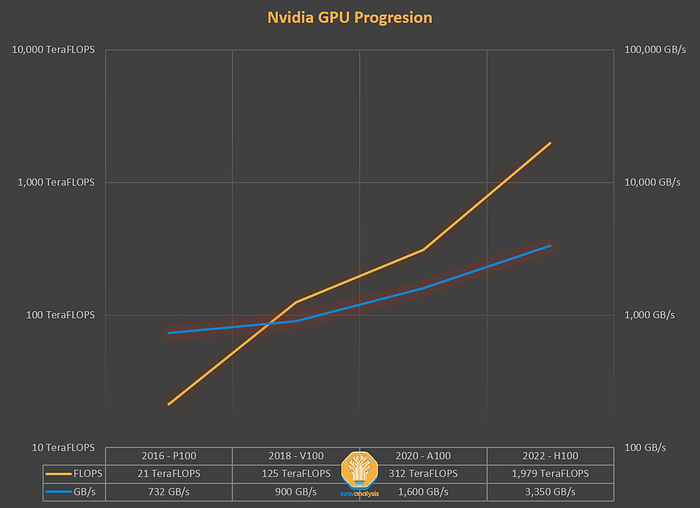
多年以来,GPU 芯片理论算力(FLOPS)的增长速度,远远超过了显存物理带宽(TB/s)的增长速度。
核心定律:如果数据根本来不及送进计算单元,你的芯片理论上能跑到多少个 ExaFLOPS 都毫无意义。算力与数据搬运能力必须保持平衡;而既然硬件架构已经出现了带宽与算力的失衡(内存墙),软件算法就必须主动适配并弥补这一差距。这就是“IO 感知”的立足点。
根据计算操作量与显存访问量的比例关系,深度学习系统中的各类算子通常被划分为两类:
- 计算受限(Compute-Bound):计算密度极高,硬件瓶颈在于算力单元的吞吐极限。最典型的代表就是大矩阵乘法(GEMM / MatMul);
- 访存受限(Memory-Bound):计算量极小,瓶颈完全卡在显存数据的搬运延迟与带宽极限。典型代表包括所有逐元素操作(Elementwise Ops:如各类激活函数 ReLU/GELU、Dropout、Masking),以及归约操作(Reduction Ops:如 Softmax、LayerNorm、Sum)。
💡 关键指标:算术强度(Arithmetic Intensity)
算术强度被严格定义为:每读取/写入一个字节的显存数据,所能完成的浮点算术操作次数(FLOPs / Byte)。
算术强度越高,越容易吃满 GPU 算力;算术强度越低,GPU 绝大部分时间都在干等内存传输。
令人震惊的系统事实是:在现代 AI 加速硬件上,Transformer 的注意力机制整体上是严重访存受限(Memory-Bound)的!
为什么?因为 Attention 内部充斥着大量的逐元素与归约操作,其整体算术强度极低。
让我们放大看论文中的这张实测分解图:
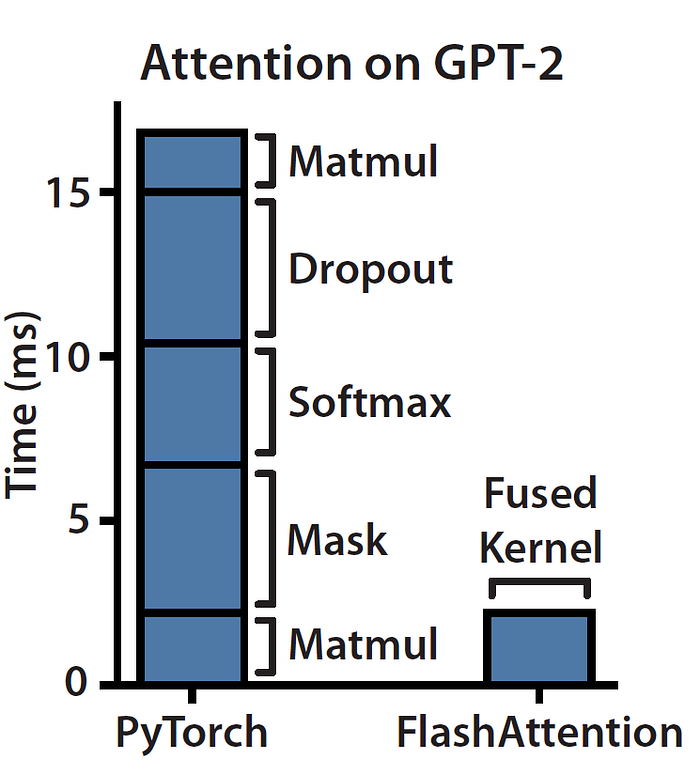
看左侧的实测柱状图:尽管矩阵乘法(MatMul)消耗了整个 Attention 中绝大部分的浮点计算量(FLOPs),但耗费绝大部分实际物理运行时间的,恰恰是 Masking、Softmax 和 Dropout 这些访存受限的小算子!
第三部分:GPU 显存金字塔与标准注意力的“罪状”
显存从来不是一块铁板。现代处理器的存储系统具有鲜明的层级金字塔结构(Memory Hierarchy):存取速度越快的存储介质,成本越昂贵,物理容量也就越小。
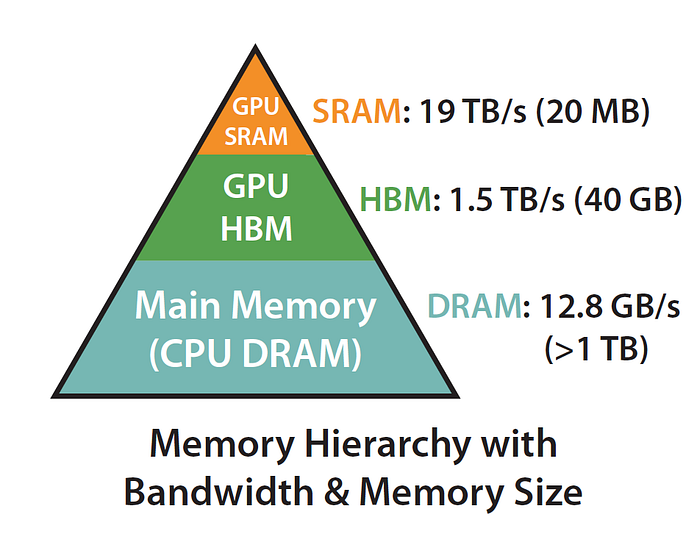
以 NVIDIA A100 GPU 为例:
- 高带宽显存(HBM,即我们常说的显存池):容量为 40~80 GB,显存物理带宽约 1.5~2.0 TB/s;它是触发 CUDA Out-Of-Memory (OOM) 报错的地方。
- 片上高速缓存(On-chip SRAM,分布在每个流式多处理器 SM 内):A100 拥有 108 个 SM,每个 SM 仅有 192 KB 的片上 SRAM,但其聚合访问带宽高达惊人的 19 TB/s!比 HBM 快整整一个数量级!
“IO 感知”的工程精髓:充分利用 SRAM 远快于 HBM 的物理事实,千方百计最小化 HBM 与 SRAM 之间的数据往返通信频率与搬运总量。
现在我们回头检视标准 Attention 机制的计算流程与访存行为:
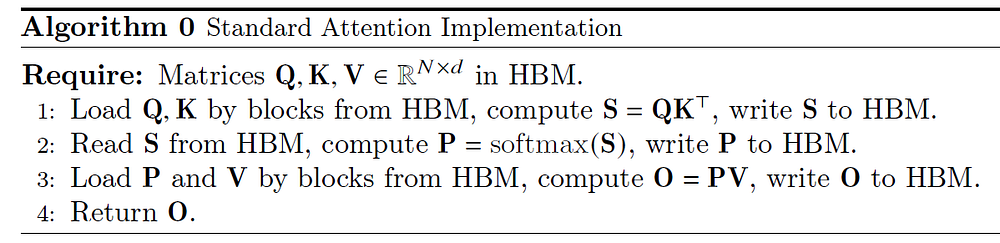
符号约定:Q 为查询矩阵,K 为键矩阵,V 为值矩阵,S 为注意力分数,P 为 Softmax 概率矩阵,O 为最终输出。
标准实现对底层硬件物理特性的不加考虑令人发指:
- 从 HBM 读出 Q, K,在 SRAM 算完点积得到分数矩阵 S;
- 立刻将巨大的 N × N 分数矩阵 S 完整写回慢速 HBM;
- 为了算 Masking 与 Softmax,又重新把 S 从 HBM 完整加载回 SRAM;
- 算完 Softmax 得到概率矩阵 P,又一次把全量 N × N 矩阵 P 写回慢速 HBM;
- 最后为了与 V 做乘法,第三次从 HBM 读回 P,并与从 HBM 读取的 V 相乘,最终写出 O。
这一过程把慢速 HBM 的 Load/Store 视作毫无开销。每一步微小操作都在全量刷盘,这就是标准实现慢且占用巨量显存的根本原因。
第四部分:编译器优化的第一绝技——算子融合与显存物化
从第一性原理出发,最直观的优化方案是什么?
彻底砍掉不必要的 HBM 重复读写!
为什么非要把中间矩阵 S 写回 HBM,只为了下一步再把它读出来算 Softmax 呢?为什么不把中间数据直接锁定在极其高速的 SRAM 中,一气呵成完成计算,只在最终结果算完后写回一次 HBM?
这就是底层编译器领域最核心的技术——算子融合(Kernel Fusion):
其实原理极为直观:
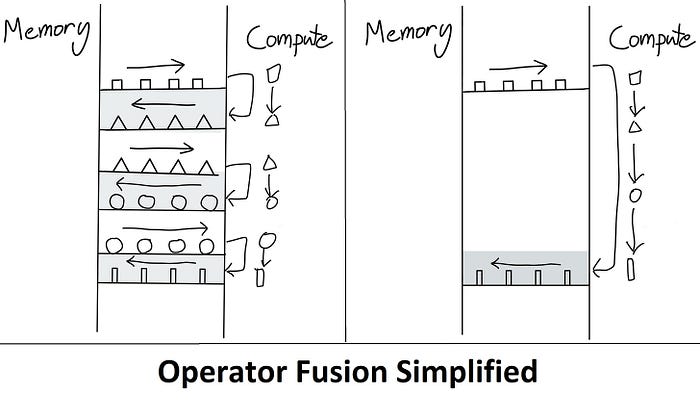
- Kernel(核函数/算子):在 GPU 编程语境下,本质上就是一段在 GPU 上并发执行的指令程序。
- Fusion(融合):将原本独立的多个小算子打包串联在一个单次执行的核函数中。数据从 HBM 仅读取一次,在片上高速缓存完成所有计算,仅写回一次结果。
此外,必须明确一个关键术语:物化(Materialization)。
在标准实现中,我们显式地向 HBM 申请分配并存储了全尺寸的 N × N 矩阵(S 和 P)。这就叫显存物化。当序列长度 N 增长到 8K、32K 乃至 128K 时,N² 的物理显存开销会发生毁灭性的爆炸。
FlashAttention 要解决的核心痛点,正是彻底消除 N × N 中间注意力矩阵在 HBM 中的物化,将显存复杂度从 O(N²) 砍到严格线性的 O(N)!
第五部分:FlashAttention 的两大核心支柱
FlashAttention 的全部魔力,归结起来就是两大支柱思想:
- Tiling(分块分片计算):在前向传播(Forward)与反向传播(Backward)中,将全尺寸的输入矩阵与 Softmax 计算逻辑切分成能够刚好塞进 SRAM 的局部小块。
- Recomputation(反向重计算):在反向传播中,坚决不保存 N × N 的前向注意力中间结果,而是仅保留极其小巧的统计量,在需要梯度时利用 SRAM 极速重算注意力矩阵。
但实现分块计算面临着一座几乎不可逾越的数学大山——Softmax 算子。
第六部分:分块的核心瓶颈与数学破局——Online Softmax
为什么 Attention 以前无法分块?因为 Softmax 的每一项输出都与整行所有元素强耦合。
回顾 Softmax 的标准数学定义,对于第 i 个输入分数 z_i:
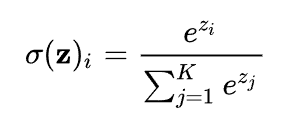
Softmax(z_i) = exp(z_i) / ∑ exp(z_j)注意到分母中的全局累加求和项 ∑ exp(z_j) 了吗?
为了计算当前序列第 i 个 Token 对其他所有 Token 的注意力权重,你必须事先拿到这一行中全部 N 个 Token 的注意力分数,才能算出分母!
而 SRAM 的物理容量极其微小(只有区区几十到几百 KB)。当序列长度 N 达到数千乃至数万时,SRAM 根本装不下整行注意力分数,更装不下全量 N × N 矩阵。
数学破局:增量分块合并 Softmax(Online Softmax)
奇迹在于:我们完全可以将 Softmax 拆解为分块局部的增量计算,并且在数学上严谨地无损还原出最终正确的全局 Softmax 输出!
核心公式推导如下:
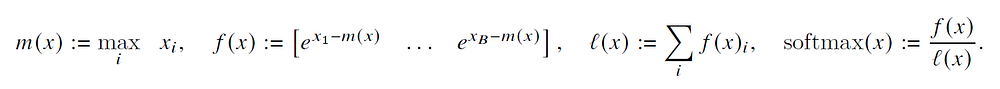
假定我们将序列切分为若干个大小为 B 的块。对于第一个数据块 x^(1) = [x_1, …, x_B],我们计算局部统计量:
- 局部最大值:
m(x^(1)) = max(x_j)(减去最大值是为了保证浮点数指数运算的数值稳定性,防止发生溢出); - 局部指数向量:
f(x^(1)) = [ exp(x_1 - m(x^(1))), ..., exp(x_B - m(x^(1))) ]; - 局部指数标量和(局部归一化分母):
l(x^(1)) = ∑ exp(x_j - m(x^(1)))。
此时计算出的局部结果在全局视角下显然是“不完整”的。但关键在于,当第二个数据块 x^(2) 到来时,我们如何将两块完美地合并?
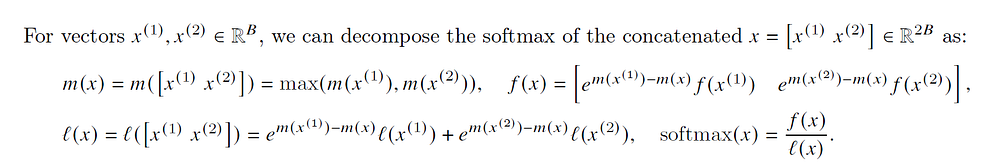
令合并后的整体输入向量为 x = [x^(1), x^(2)],其两块的合并法则如下:
1. 合并后的全局最大值:
   m(x) = max(m(x^(1)), m(x^(2)))

2. 重新标定并合并后的分母(指数和):
   l(x) = exp(m(x^(1)) - m(x)) * l(x^(1)) + exp(m(x^(2)) - m(x)) * l(x^(2))

3. 重新标定并合并后的分子(未归一化概率向量):
   f(x) = [ exp(m(x^(1)) - m(x)) * f(x^(1)),  exp(m(x^(2)) - m(x)) * f(x^(2)) ]

4. 最终精确 Softmax:
   Softmax(x) = f(x) / l(x)
💡 代数直觉说明
这背后的代数技巧非常优雅:新块带来的新最大值 m(x) 会与旧块的最大值产生差值。我们只需为旧块的指数和 l(x^(1)) 乘上一个缩放校正系数exp(m(x^(1)) - m(x)),就能抵消旧的基准并严谨地重标定(Rescale)到统一的新基准线上!
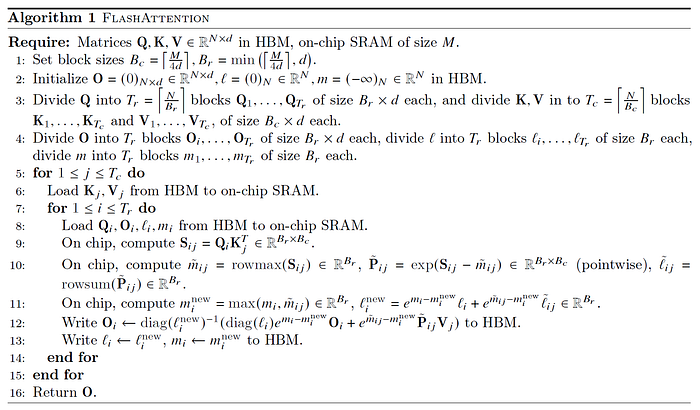
整个过程只需要保留两个轻量级标量统计量:历史最大值 m 和 历史指数和 l。
这个分块合并逻辑可以沿着数据块一路递推下去,直至处理完最后一个分块,最终直接得到完美的 N 维全局精确 Softmax!
第七部分:前向传播——逐行算法全景深度拆解
掌握了 Online Softmax 的核心思想,我们现在能够毫无压力地逐行攻克 FlashAttention 前向传播(Forward Pass)算法伪代码。
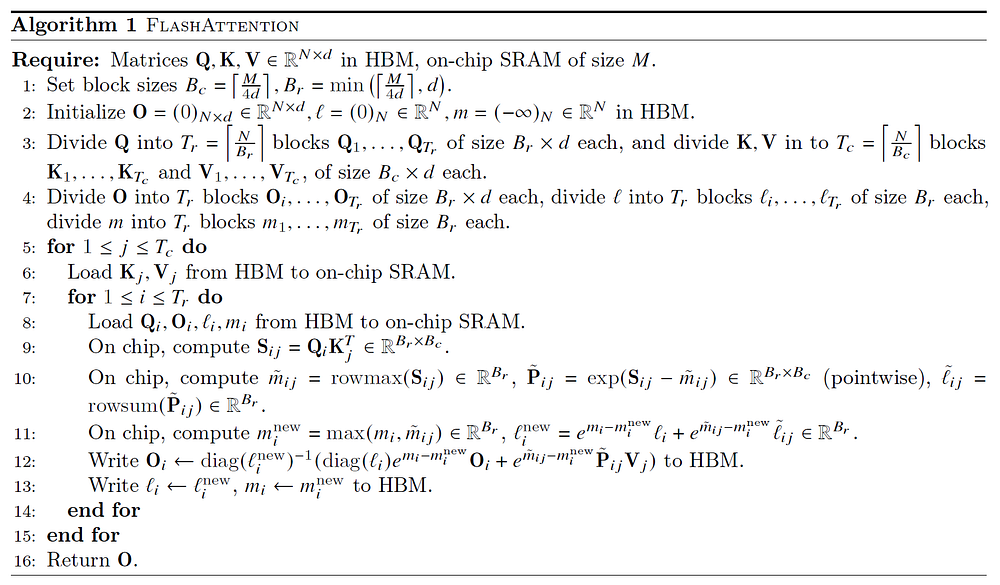
算法约定:以下推导以 Batch Size = 1、单 Head 为基准展开(多 Batch 和多 Head 在 GPU 上是完全独立的并行任务)。符号定义:d 为注意力头维度,M 为片上 SRAM 的物理可用容量。
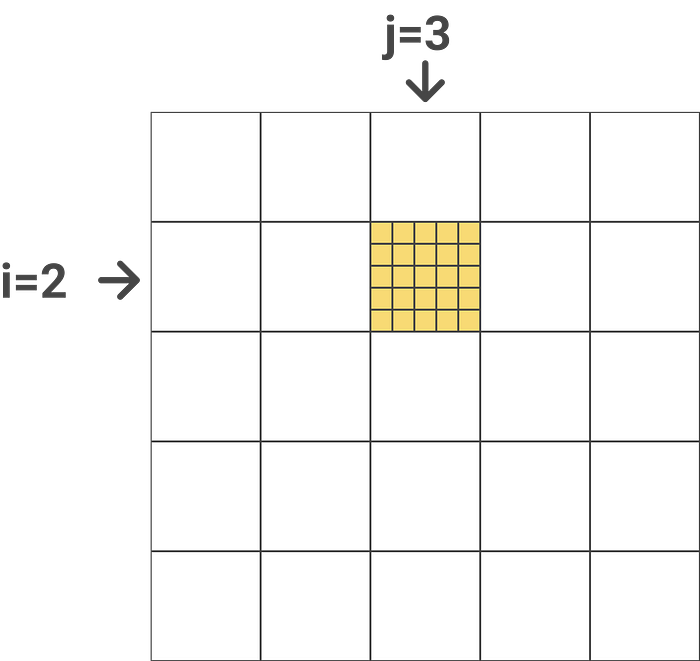
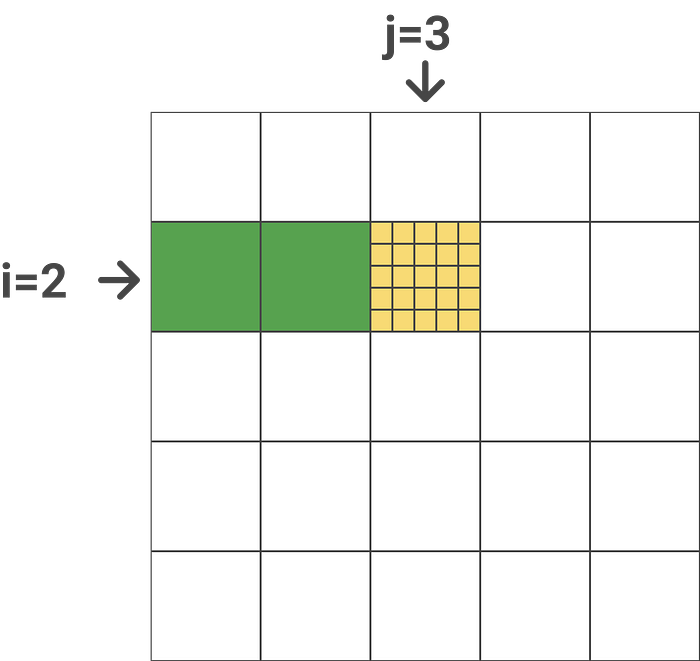
算法整体的分块网格模型示意如下(务必在脑海中建立这个几何心智模型):
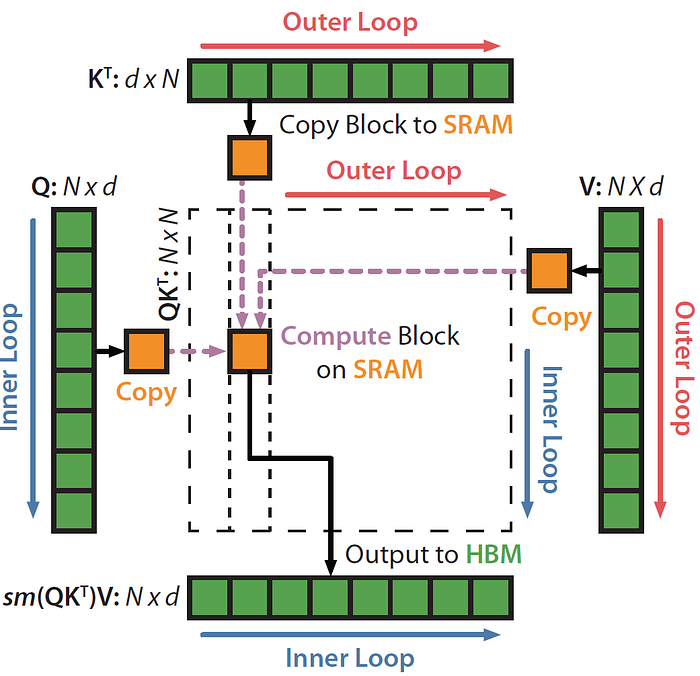
Step 0:全量输入驻留 HBM
- 输入矩阵 Q, K, V 尺寸为 N × d。由于现代 GPU 的 HBM 达到数十 GB,容纳输入张量不存在任何容量瓶颈。
Step 1:确定分块尺寸
- 列分块大小:
B_c = ceil(M / 4d); - 行分块大小:
B_r = min(ceil(M / 4d), d)。 - 为什么是 M / 4d? 因为每个 Token 向量是 d 维的,而在 SRAM 中我们需要同时协同容纳 Q 块、K 块、V 块和累加输出 O 块(共 4 类张量)。这样设置刚好能够将片上 SRAM 榨取到极限利用率。
Step 2:初始化累加器与全局统计量
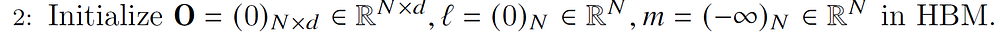
- 输出矩阵 O 初始化为全 0(尺寸 N × d);
- 累积 Softmax 分母标量和 l 初始化为全 0(尺寸 N);
- 累积最大值统计量 m 初始化为
-inf(尺寸 N)。由于后续要求最大值,任何有限数值都会大于-inf。
Step 3 & 4:逻辑切分
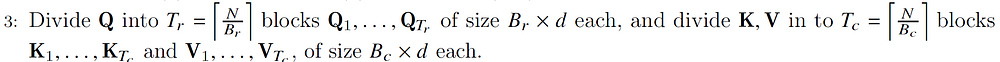
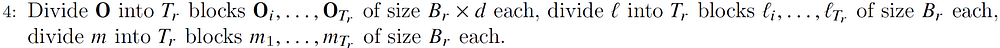
- 将输入 Q 按行切分为
T_r = ceil(N / B_r)个块 Q_1, …, Q_{T_r}(每个块尺寸 B_r × d); - 将 K, V 按行切分为
T_c = ceil(N / B_c)个块 K_1, …, K_{T_c} 和 V_1, …, V_{T_c}(每个块尺寸 B_c × d); - 同样将 O, l, m 对应切分成块。
Step 5 & 6:外层循环(遍历列,即遍历 Key / Value 块)
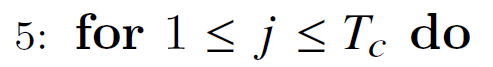
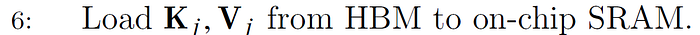
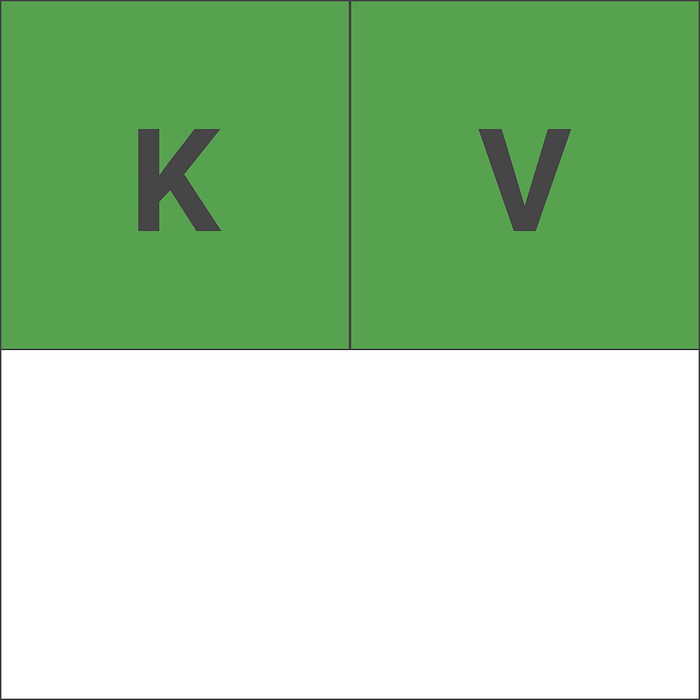
- 循环变量
j = 1 ... T_c。从慢速 HBM 将 K_j, V_j 块一次性加载到片上 SRAM; - 此时片上 SRAM 约占用 50% 容量,剩下的 50% 留给 Query 和 Output。
Step 7 & 8:内层循环(遍历行,即遍历 Query / Output 块)
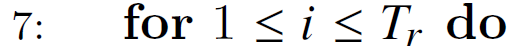
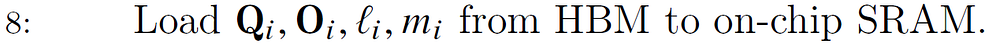
- 循环变量
i = 1 ... T_r。从 HBM 将 Q_i, O_i 以及对应的局部统计量 l_i, m_i 加载到 SRAM 中。
Step 9:局部注意力打分矩阵点积
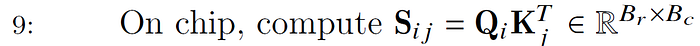
- 在片上 SRAM 中,直接计算
S_ij = Q_i · (K_j)^T(尺寸为 B_r × B_c); - 关键里程碑:在此处,全量 N × N 的打分矩阵 S 从未在显存中物化!我们仅仅在极速 SRAM 中生成了一小块局部分数切片!
Step 10:计算当前块的局部 Softmax 统计量
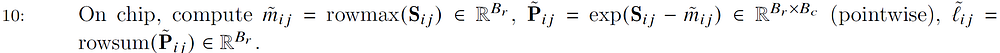
- 计算当前块的行最大值:
m_tilde_ij = rowmax(S_ij)(长度为 B_r); - 计算减去局部最大值后的指数打分:
P_tilde_ij = exp(S_ij - m_tilde_ij)(尺寸为 B_r × B_c); - 计算当前块的局部指数和:
l_tilde_ij = rowsum(P_tilde_ij)(长度为 B_r)。
Step 11:更新全局累积统计量
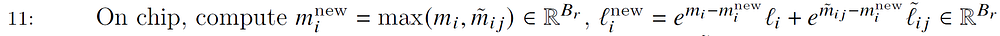
- 计算融合了当前块之后的最新行最大值:
m_i_new = max(m_i, m_tilde_ij) - 计算按新基准重标定后的最新行指数累加和:
l_i_new = exp(m_i - m_i_new) * l_i + exp(m_tilde_ij - m_i_new) * l_tilde_ij
Step 12:重标定历史输出并融合当前块(全算法最核心代数步!)
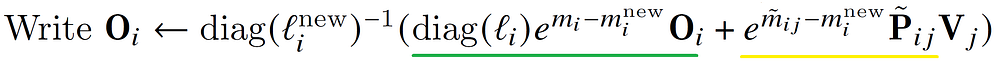
这是理解 FlashAttention 最硬核、但也最美妙的一步。我们来彻底拆解其代数表达式:
O_i ← diag(l_i_new)^(-1) * [ diag(l_i) * exp(m_i - m_i_new) * O_i + exp(m_tilde_ij - m_i_new) * P_tilde_ij * V_j ]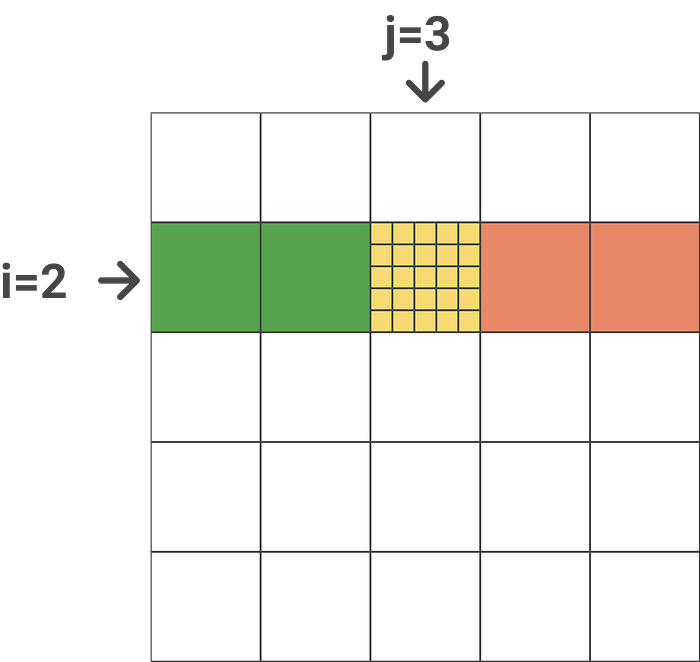
- 矩阵形式的
diag(l):本质上就是用对角阵表达“对每一行进行逐行标量缩放”; - 第一项(绿色下划线部分):
- 之前保存的累积输出 O_i 中,内部隐藏着上一轮的除法分母 l_i;
- 通过左乘
diag(l_i),精准抵消并撤销了旧分母; - 再乘上
exp(m_i - m_i_new),使历史的未归一化加权累加值自动更新为以最新全局最大值m_i_new为底的新刻度!
- 第二项(黄色下划线部分):
- 当前块新算出来的注意力加权值
P_tilde_ij * V_j; - 同样乘上
exp(m_tilde_ij - m_i_new),与第一项对齐到同一个基准刻度;
- 当前块新算出来的注意力加权值
- 最外层的
diag(l_i_new)^(-1):- 两项加权相加后,整体除以最新的全局总分母
l_i_new,完成当前轮次严谨无损的重标定归一化!
- 两项加权相加后,整体除以最新的全局总分母
如果感觉文字抽象,我们来看作者手写推导前两轮迭代的具体代数展开过程:
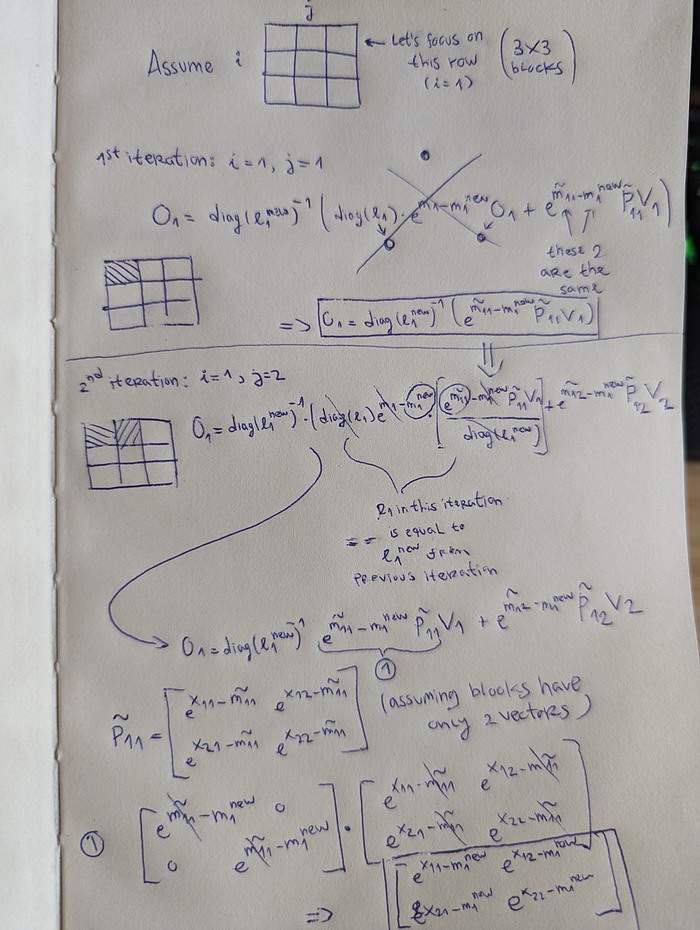
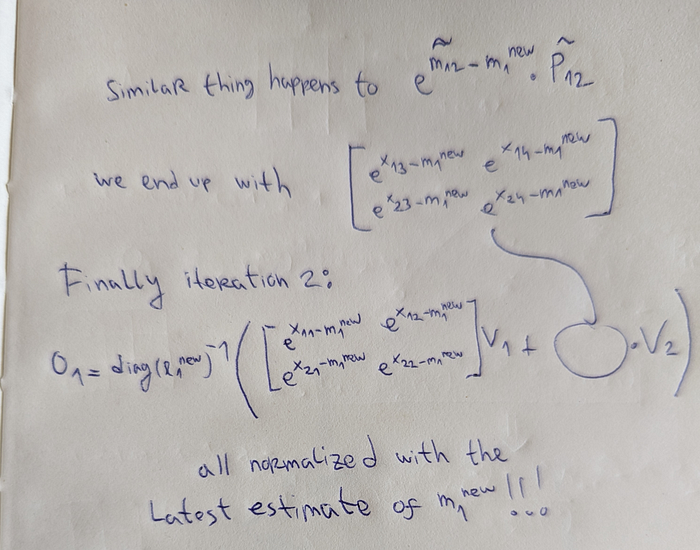
在代数展开中可以清晰看到,外部的指数因子与内部矩阵中的旧因子完美对消抵消,从而每一步都能严格保持数值等价性!
Step 13:写回统计量
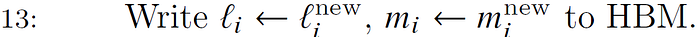
- 将本轮计算出的最新向量 l_i 与 m_i 写回 HBM。注意它们的尺寸只有 B_r,相比 N × N 的打分矩阵小了几个数量级。
Step 14~16:循环收敛与最终输出
- 当双层嵌套循环遍历结束时,矩阵 O(尺寸 N × d)中驻留的就是严格精确、完全等价于标准 Attention 的最终注意力输出结果!
第八部分:进阶扩展——Block-Sparse FlashAttention
在掌握了 FlashAttention 的分块循环模型后,将其扩展为**块稀疏注意力(Block-Sparse FlashAttention)**在工程上顺理成章:
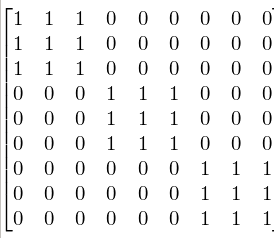
- 定义一个粗粒度的块级掩码矩阵(Block Form Mask Matrix);
- 在内层循环中,如果判断某个 (i, j) 块完全处于注意力遮掩区域(如因果因果掩码的右上三角区,或稀疏局部注意力窗口外部),直接在调度层跳过该块的加载与计算;
- 计算时间直接按稀疏比例进一步缩减 2~4 倍,使处理 64K 超长上下文变得轻而易举!
第九部分:显存与访存复杂度分析
显存空间复杂度(Space Complexity)
- HBM 中实际分配并物化的张量包括:Q, K, V, O(每个 N × d)以及统计量向量 l, m(每个 N);
- 总占用空间为:
4Nd + 2N。由于头维度 d 是固定常数(如 64 或 128),且远远小于序列长度 N; - 最终显存空间复杂度:严格的
O(N)(线性复杂度)!相比标准实现的O(N²),彻底解除了长上下文显存爆炸的枷锁。
访存复杂度(IO Complexity)
衡量算法执行快慢的核心指标是 HBM 访存次数(HBM Accesses):

标准 Attention 的访存复杂度为 `Θ(N d + N²);而 FlashAttention 的 HBM 访存复杂度为:
Θ(N² d² M⁻¹)其中 M 为片上 SRAM 物理容量。在典型的超参数设定下(如 d=64, M=100KB),FlashAttention 能够将 HBM 的物理读写总量降低 5 到 9 倍!这直接转化成了显著的物理运行加速。
第十部分:连接现实世界工程——多 Head、反向重计算与 Triton
1. 多 Batch 与多 Head 的并行调度
真实世界中 Batch > 1 且 Head 数量 > 1。算法如何映射到 GPU?
- 前述的完整双层循环算法,在 CUDA 架构中由一个独立的 Thread Block(线程块) 全权负责;
- 该 Thread Block 被分配到 GPU 上的一个 Streaming Multiprocessor(SM) 独占执行;
- 整个 Grid 会启动
Batch × NumHeads个并发的 Thread Blocks,完全平铺并发到所有物理 SM 上并发执行,获得极高硬件占有率。
2. 反向传播与零开销重计算(Recomputation)
在标准反向传播(Backward Pass)中,计算梯度需要用到前向传播存下来的激活值 S 与 P(N × N)。
FlashAttention 借鉴了**激活值检查点(Activation Checkpointing)**思想,但更进一步:
- 前向传播完全不存任何 N × N 中间矩阵,仅保存输出 O(N × d)和紧凑的统计量 l, m(N);
- 在反向传播中,直接将 Q, K, V 分块拉入片上 SRAM,以超高带宽当场重算局部打分 S 与 P!
- 传统 Checkpointing 是以算力换显存;而在 FlashAttention 中,由于省去了写入与重读 HBM 的巨大访存延迟,这种“片上重算”甚至比直接从 HBM 读取历史矩阵还要更快!实现显存
O(N)与速度提升的双赢。
3. CUDA 的工程苦旅与 OpenAI Triton 的崛起
原版 FlashAttention 需要用原生 CUDA C++ 编写深度优化的底层核函数:
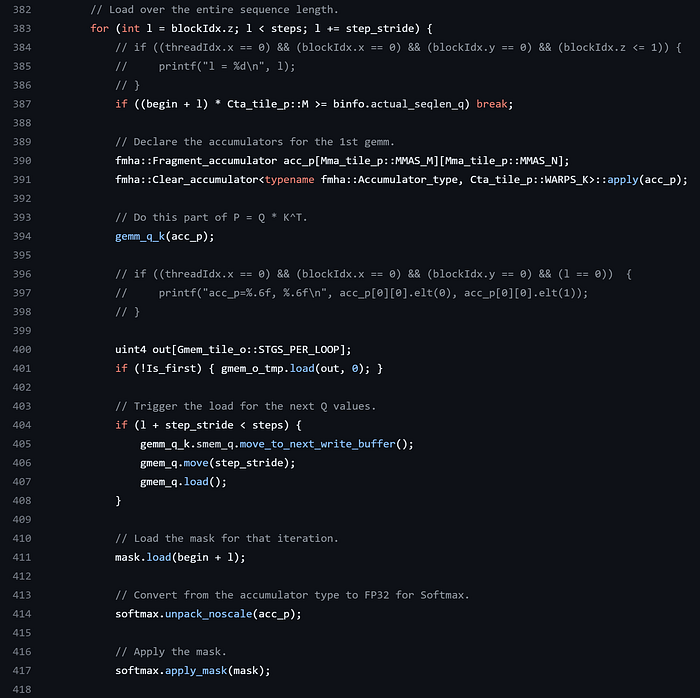
编写和维护原生 CUDA 代码极度晦涩复杂,且难以跨硬件架构迁移(例如初代 FlashAttention 无法在 Volta V100 架构上运行)。
这正是 OpenAI Triton 等现代专用语言大放异彩的舞台:开发者可以使用类似 Python 的高级语法编写兼具分块与流水线调度逻辑的高性能算子,编译器会自动将其下沉编译为极度高效的 IO 感知底层指令。
第十一部分:总结与第一性原理思考
为什么如此基础且关键的注意力优化,不是由拥有顶级编译器专家的芯片巨头提出,而是由斯坦福的一位博士生(Tri Dao)独立开创?
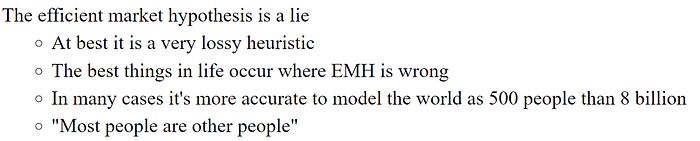
正如知名投资人 Nat Friedman 所言,这个世界的运转远不如人们想象的那样高效,到处都充满了等待被发现的巨大低垂果实。
当工业界的大多数人习惯了将硬件封装视为纯黑盒、在现有 PyTorch 算子框架下不断叠加有损的近似注意力算法时,坚持从第一性原理审视计算系统——回归内存墙、硬件层级与底层访存开销的本质——往往能诞生颠覆性的突破。
在大语言模型动辄数百万、上千万美元训练成本的今天,一个将核心计算提速数倍、将序列长度从 2K 扩展至几十万的优雅算法,为全球 AI 生态创造了无可估量的经济价值。
第十二部分:参考文献与拓展资料
- FlashAttention 官方论文:
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(Dao et al., NeurIPS 2022)
- FlashAttention 官方源码仓库:
- Tri Dao 的学术特邀报告:
- Online Softmax 原理论文:
- Online normalizer calculation for softmax (Milakov & Gimelshein, 2018)
- 算术强度与硬件瓶颈解析:
- FlashAttention-2 进阶演进: