 yuzheng
翻译与阅读笔记
Karpathy 加速本地大模型的秘诀,终于有了工程解法:Uzu 如何突破 Apple Silicon 访存墙
Karpathy 曾指出单批次自回归解码受制于内存带宽,而推测解码可利用闲置算力并行验证多个 token。Mirai 推出的开源引擎 Uzu 结合量化、Metal 算子、DFlash-Weaver 投机树与无回滚验证,在 M5 上将 9B 模型推到 92~117 tok/s。
2023 年,Andrej Karpathy 深入剖析了为什么在个人电脑上运行本地大模型(Local LLMs)会如此缓慢:当模型在你的芯片上生成单条文本流时,处理器绝大部分时间都在干等模型权重从内存搬运过来,而核心的算术计算单元却大部分处于饥饿闲置状态。
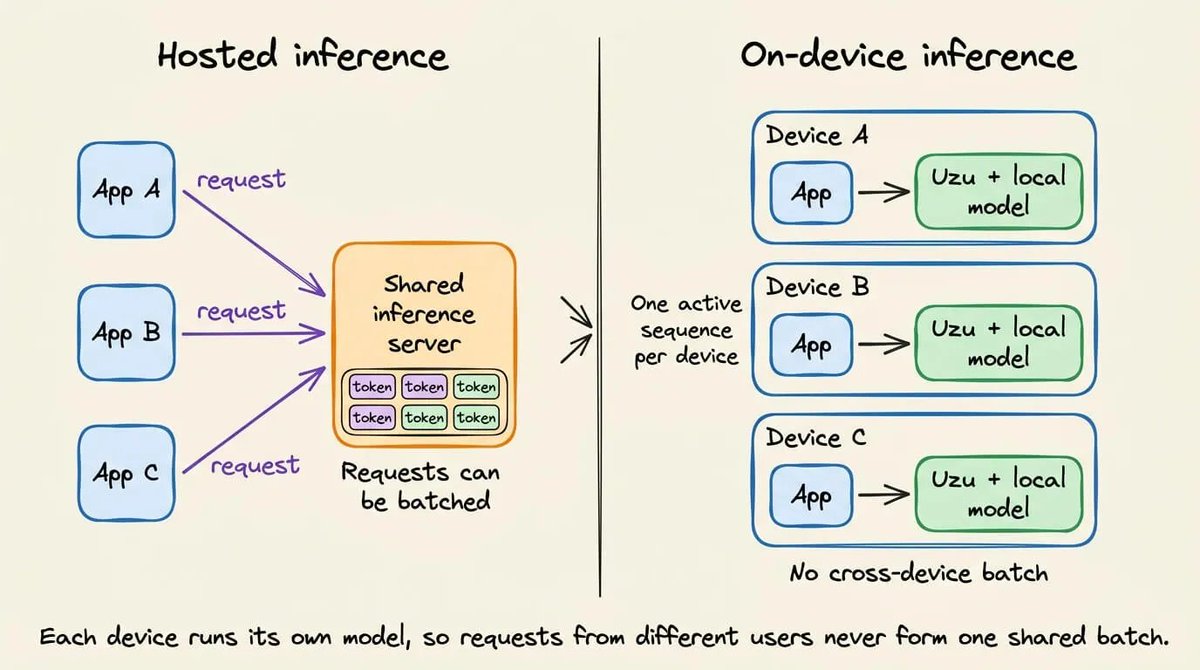
图 1:Karpathy 指出本地推理受限于内存带宽(Memory-Bound)。单批次自回归解码的本质是算力过剩、带宽见顶。
几周之后,他又指出了绕开该瓶颈的解法:在单次模型前向传播中同时检查多个 token,所消耗的访存与时间成本,与只检查单个 token 几乎完全相同。因此,我们可以让一个轻量的草稿模型(Draft Model)先行向前“盲猜”,再由庞大的主模型对这些猜测进行一次性并行验证。
然而,Karpathy 提出的第一点规律至今仍是物理层面的坚硬天花板。以基础款 Apple M5 芯片为例,其统一内存带宽为 153 GB/s;一个 4-bit 量化的 Qwen3.5 9B 模型体积约为 5.2 GB。若每次前向传播只能产出一个 token,无论 GPU 算力有多么充沛,该芯片的理论生成速度上限也仅有:
在面对同一段编程提示词时,llama.cpp 与 MLX 的实测速度分别为 22 tok/s 与 25 tok/s,恰好紧贴在这道物理上限的正下方。
第二点规律则是性能飞跃的真正潜力所在。然而,目前业界主流的本地推测方案(如 llama.cpp 的 MTP 模式)通常一次只能推测 3 到 4 个 token。
由 Mirai 推出的开源推理引擎 Uzu,在 Apple Silicon 平台上将这一思路推向了新的高度:它能向前推测多达 16 个 token,在候选猜测之间保持自回归语义连贯性,并通过专为 M5 芯片手写的 Metal 底层算子在单次前向中完成整体验证。
图 2:在相同 M5 芯片与相同提示词下,llama.cpp 为 22 tok/s,MLX 为 25 tok/s,而 Uzu 跑出了 92~117 tok/s。
在完全相同的 M5 芯片、相同模型与相同提示词下,Uzu 实现了 92 到 117 tokens/s 的惊人输出速度。
接下来,我们将系统拆解:这道内存带宽天花板究竟因何而生?Uzu 是如何突破限制的?最后,我们还将提供一个独立评测客户端,帮助你在自己的提示词上实测 Uzu、llama.cpp 与 MLX 的真实水准。
为什么单批次解码是极度访存受限的?
大模型推理包含两个截然不同的物理阶段:
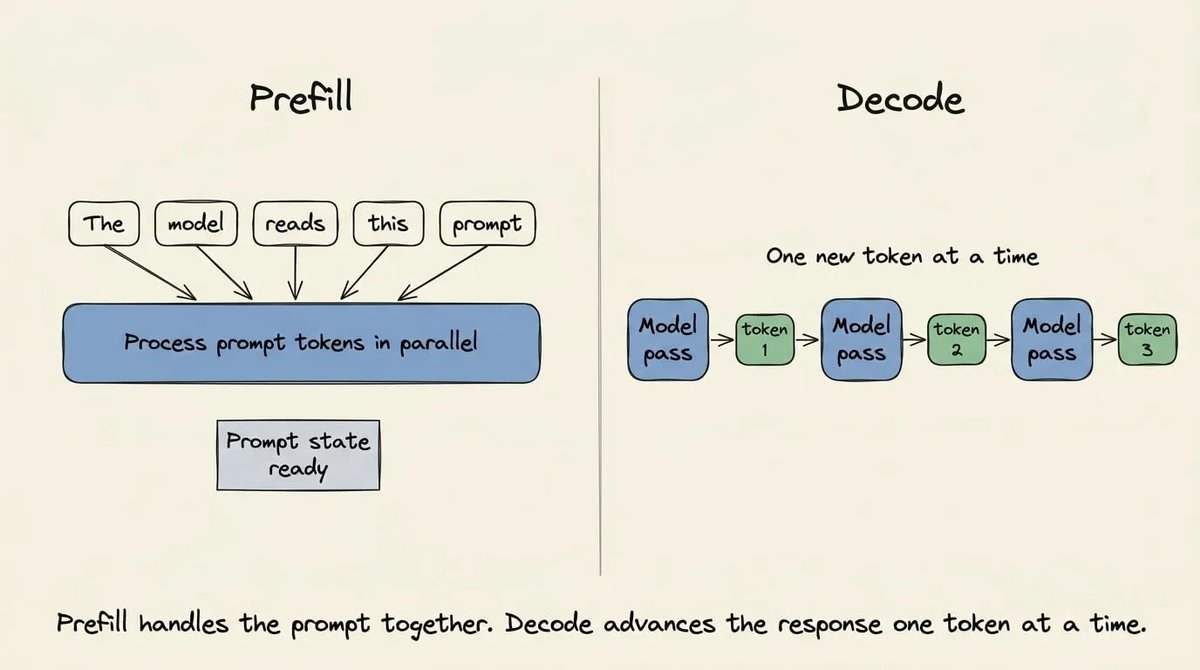
图 3:LLM 推理分为并行处理提示词的 Prefill 阶段,与逐步自回归吐字的 Decode 阶段。
- Prefill(预填充):高度并行地处理用户输入的所有提示词 token。
- Decode(解码):逐步生成回复内容,每次前向传播仅生成一个新 token。
解码是耗时最长且最关键的阶段。每产出一个新 token,运行时都必须启动一次完整的模型前向传播(Forward Pass),逐层流式读取庞大的权重矩阵并计算下一个词的概率得分。
在单用户本地运行(Batch Size = 1)时,每次前向传播仅仅服务于单条生成序列。
此时的算术计算密度极低,与所需搬运的庞大权重数据量形成了鲜明反差:为了产生短短 1 个 token,芯片必须将整个模型的数十亿参数从内存完整流式读入 GPU 核心一次,而每个权重参数大致只参与一次乘加计算。
GPU 核心完成这区区几次乘加运算的速度,远比内存总线搬运下一块权重数据的速度要快得多。因此,整个芯片的运行节拍被彻底锁死在内存带宽上。
这构成了不可逾越的物理上限:基础款 M5 拥有 153 GB/s 的内存带宽,4-bit Qwen3.5 9B 模型约占 5.2 GB。若每次前向只前进一步,该芯片每秒最多只能生成 个 token。实际引擎的表现还会略低于该天花板,因为每次计算还需要额外读取先前上下文的 KV Cache 等状态数据。
权重量化(Quantization)是缓解这一问题的常规战术——通过压缩每个权重参数的比特数,减少每次前向读取的总字节数。
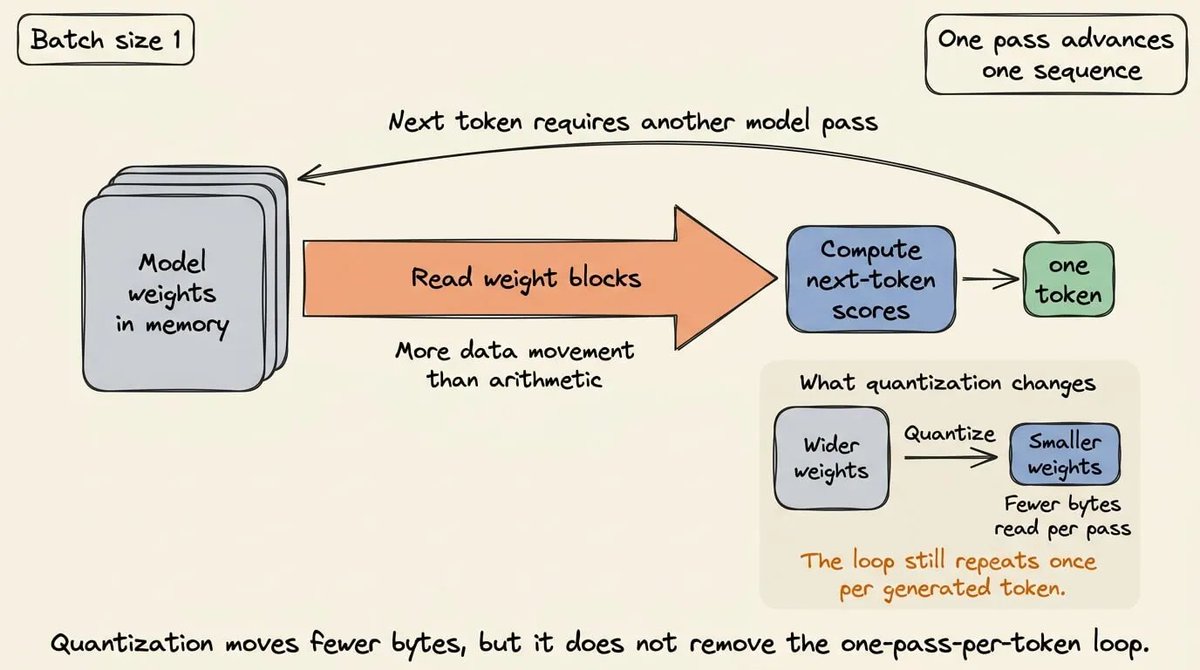
图 4:权重量化将浮点权重压缩至低比特(如 4-bit),成倍减少单次搬运的数据量。
但量化本质上依然受制于“单步吐一字”的自回归死循环:每生成一个 token,庞大的主模型依然得跑一遍。
既然低比特量化早已成为行业标配,那么 Uzu 究竟是如何打破这道物理枷锁的?
Uzu 的破局双杠杆:压缩字节量与倍增每步 Token 数
Uzu 在自回归解码循环中同时瞄准了两个物理变量:降低单次前向搬运的数据字节量,以及提高单次前向成功采纳的 Token 数。
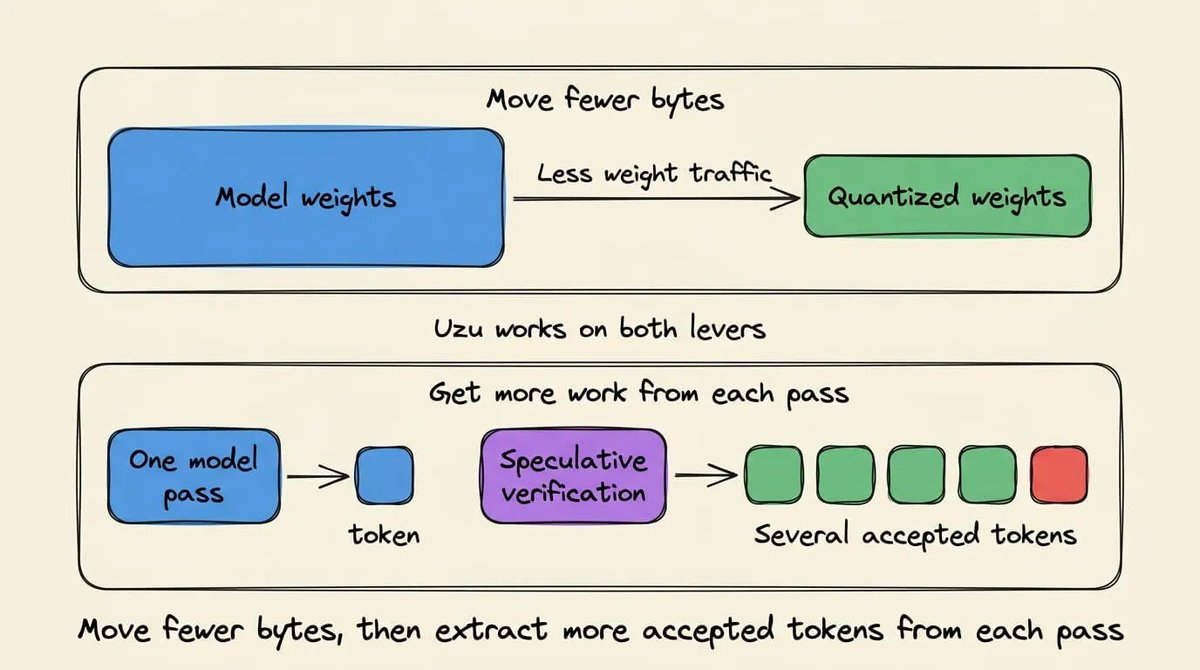
图 5:Uzu 的双重杠杆:量化压缩每次前向的数据流,推测解码提升每次前向的有效产出。
- 权重量化攻克第一个变量:以更低比特存储权重。更小的 Checkpoint 显著减少访存流量,并为上下文与应用程序留出更多宝贵的统一内存。
- 推测解码攻克第二个变量:在单次前向中一次性验证多个候选 token。若多个候选被同时核验通过,序列即可单步跳进多个 token。
许多本地引擎早已支持 4-bit 权重,Uzu 的与众不同之处在于专为该格式打造的整套硬件加速路径。
Mirai 为同一个基座模型发布了不同精度的 Checkpoint,并按体积层级进行标记(M 代表 Medium,L 代表 Large)。这些标签代表量化方案的层级,而非改变了网络架构:
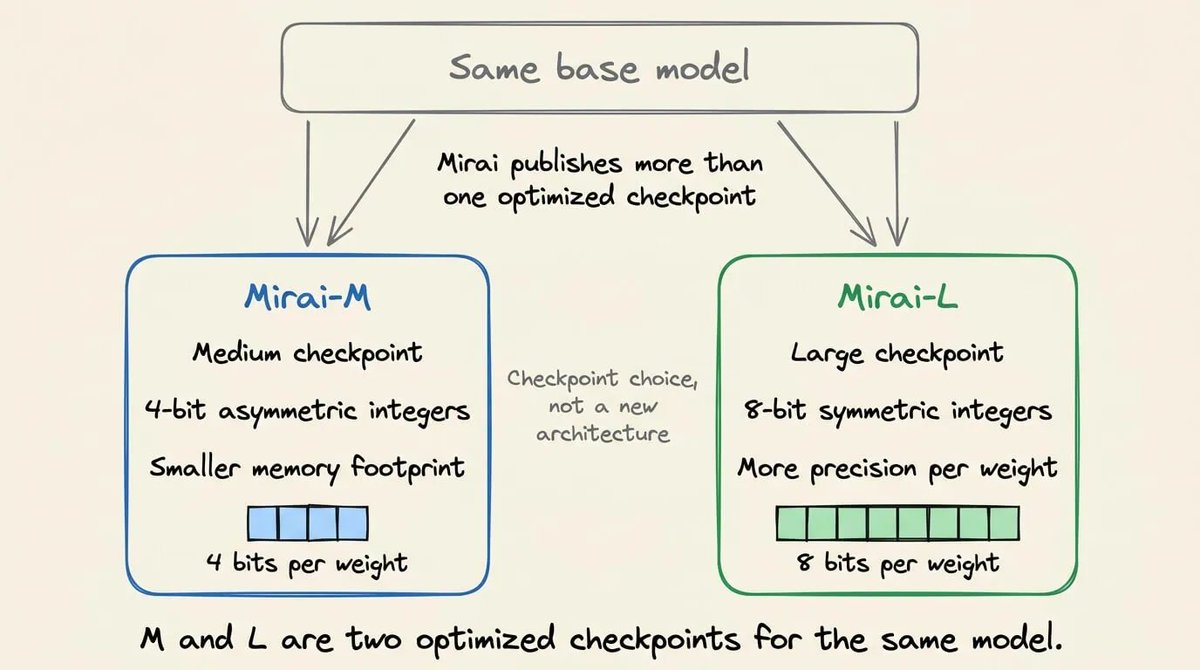
图 6:Medium 采用 4-bit 非对称整数格式,Large 采用 8-bit 对称整数格式。
- Medium 采用 4-bit 非对称整数(int4 asymmetric)量化。
- Large 采用 8-bit 对称(int8 symmetric)量化。
Medium 偏向极限内存节省,Large 则保留更多比特精度。Mirai 的量化技术报告详细介绍了他们如何将训练后量化(PTQ)与量化感知蒸馏(QAT Distillation)紧密融合。
采用整数格式绝非偶然,它同时兼顾了硬件执行效率与压缩比。
与早期的 Apple GPU 不同,M5 架构在 int8 精度下能够达到其顶峰算术吞吐量。因此,Uzu 会在推理过程中动态(on the fly)将层间传递的激活值(Activations)量化为 8 位整数。当矩阵乘法两端的权重与激活全部规整为整数时,后续的推测验证步骤即可全速狂奔在 M5 硬件加速的 int8 矩阵单元流水线上。
然而,更低精度不可避免地引来了另一个顽疾:异常离群值(Outliers)。
在分组量化(Group-wise Quantization)中,若某一组权重内包含极端的离群值,整个分组都会遭受严重的舍入精度损失。因为同组内所有数值共享同一个比例因子(Scale),该缩放尺必须向最大的极端值妥协。组内其余的大量正常小数值便只能委身于极少数的离散刻度中,导致精度严重劣化。
为了根治这一痛点,Uzu 在量化前引入了块对角随机哈达玛变换(Block-Diagonal Random Hadamard Transform,RHT):
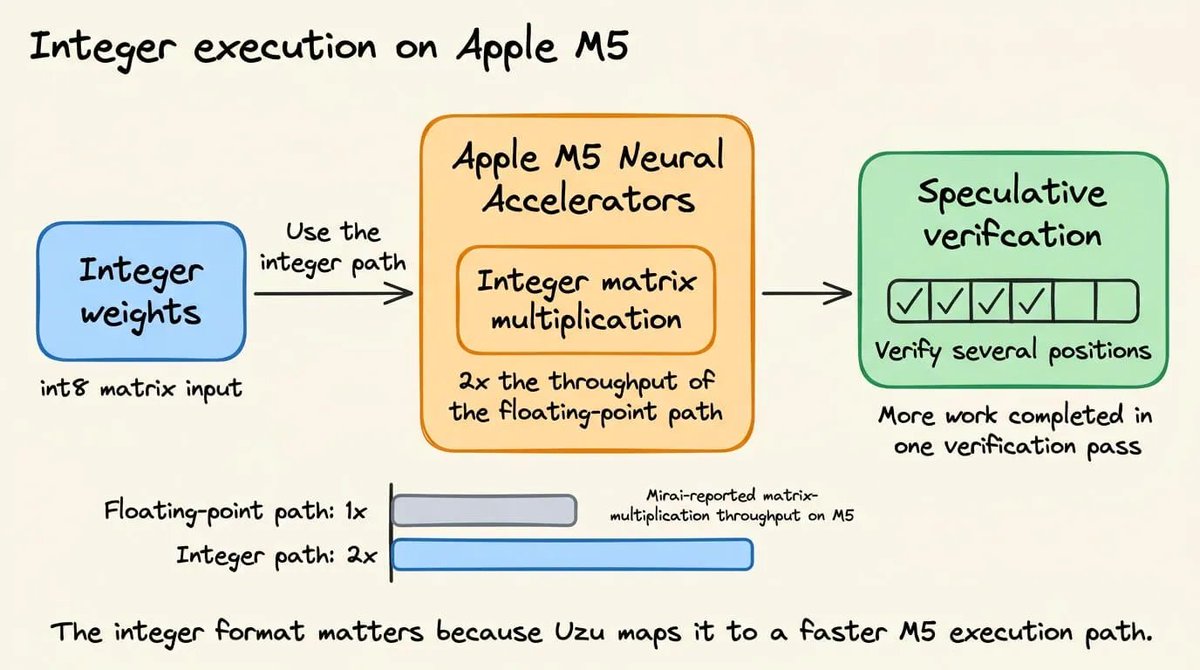
图 7:通过块对角随机哈达玛矩阵变换,原本突兀的极端离群值被均匀混合稀释到各个维度中。
哈达玛矩阵内部仅包含 +1 和 -1 元素以及一个全局缩放因子。将权重块与该矩阵相乘,能把局部维度的数值能量均匀搅拌到整个块内,从而将破坏力极强的孤立尖峰抚平成起伏平缓的中等数值。
“随机(Random)”指的是在混合前施加的随机符号翻转;“块对角(Block-Diagonal)”意味着每 32 个数值构成一个独立块分别进行变换。该数学变换完全正交可逆,除了微小的浮点舍入外,丝毫不改变模型原有的数学表达。
Mirai 精准挑选 32 个元素作为块大小,是为了严丝合缝地对齐 Apple GPU 底层的 SIMD 线程束宽度(32 线程并发)。这意味着单条 GPU 指令即可跨 32 个线程瞬间完成整个数据块的变换,没有任何跨线程通信冗余。
变换块与量化分组分别承担着截然不同的职责:
- 变换块决定了哈达玛矩阵混合哪些维度的数值。
- 量化分组决定了哪些数值共享同一套量化比例因子。
这两个几何尺寸完全不需要强行绑定一致。
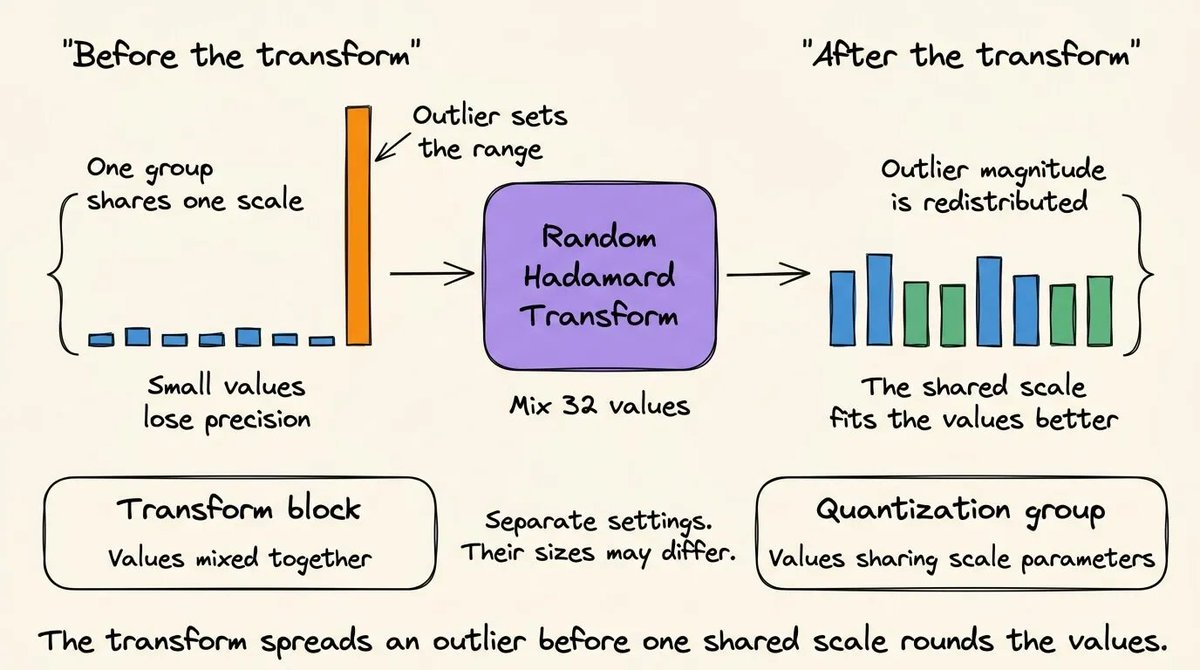
图 8:变换块(32 元素对齐 SIMD)与量化分组(如 128 元素)各自发挥最大能效。
Uzu 的核心竞争力正在于数值格式、数学变换算法与 Metal 硬件 Kernel 的三位一体深度协同。量化显著斩断了单次前向的数据搬运负荷。
然而,常规解码依然卡在“前向一次只吐一字”的旧轨道上。推测解码正是它用来实现质的飞跃的第二条战线。
单次前向如何实现“一网打尽”输出多个 Token?
推测解码在主模型身旁安排了一个轻快的“草稿模型”(Draft Model)。
草稿模型以微不足道的开销抢先猜出未来的候选序列;主模型则在单次前向传播中,将这些推测词与现有上下文一并塞入网络并行验证。主模型采纳有效的最长前缀,并从第一个被驳回的位置重新采样纠偏。
假设草稿模型一口气猜了 5 个 token,主模型认可了前 4 个。那么这一次主模型前向计算就直接向前推进了 5 个 token(4 个采纳的草稿词 + 主模型在第 5 个位置纠正生成的自身 token)!
换作常规解码,要生成这段完全相同的内容,主模型必须老老实实执行 5 次漫长的前向搬运与计算。
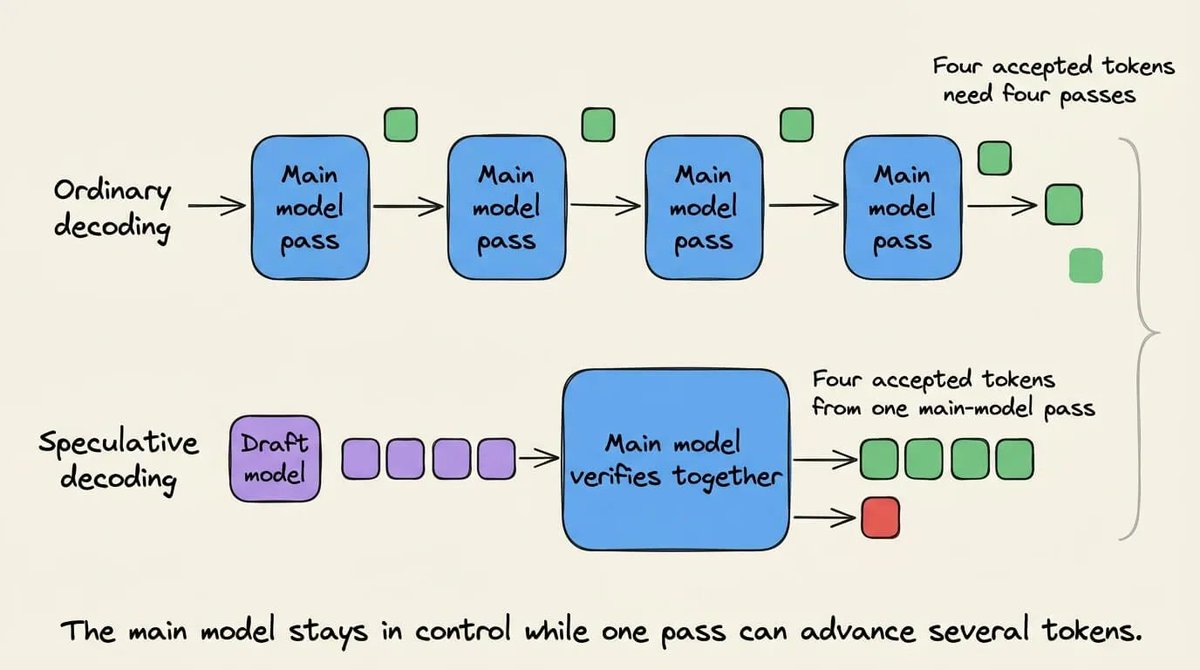
图 9:推测解码工作流。草稿模型提出 5 个候选,主模型单次前向验证通过前 4 个,并在第 5 位纠偏,单步跃进 5 个 token。
最终文本的质量仍然由大参数量的主模型牢牢把控。草稿模型仅仅充当“探路者”;严密的拒绝采样(Rejection Sampling)算法在数学上证明能够百分之百保持目标模型的原本概率分布。
不可否认,单次多 token 验证前向所需的浮点计算量确实略高于单 token 解码。
但这笔交易极其划算:因为在本地 Batch=1 场景下,当权重数据还在内存总线上龟速移动时,GPU 强大的矩阵计算单元原本就在大面积旷工。推测解码巧妙地调动了这部分沉睡的过剩算力,换取了主模型昂贵访存次数的大幅骤降。
这种权衡的核心取决于接受率(Acceptance Rate)。猜测序列越长,验证的并发批次越大,能够喂饱更多算力;但与此同时,越靠前的位置猜错,整条后续链条全盘报废的风险也就越高。
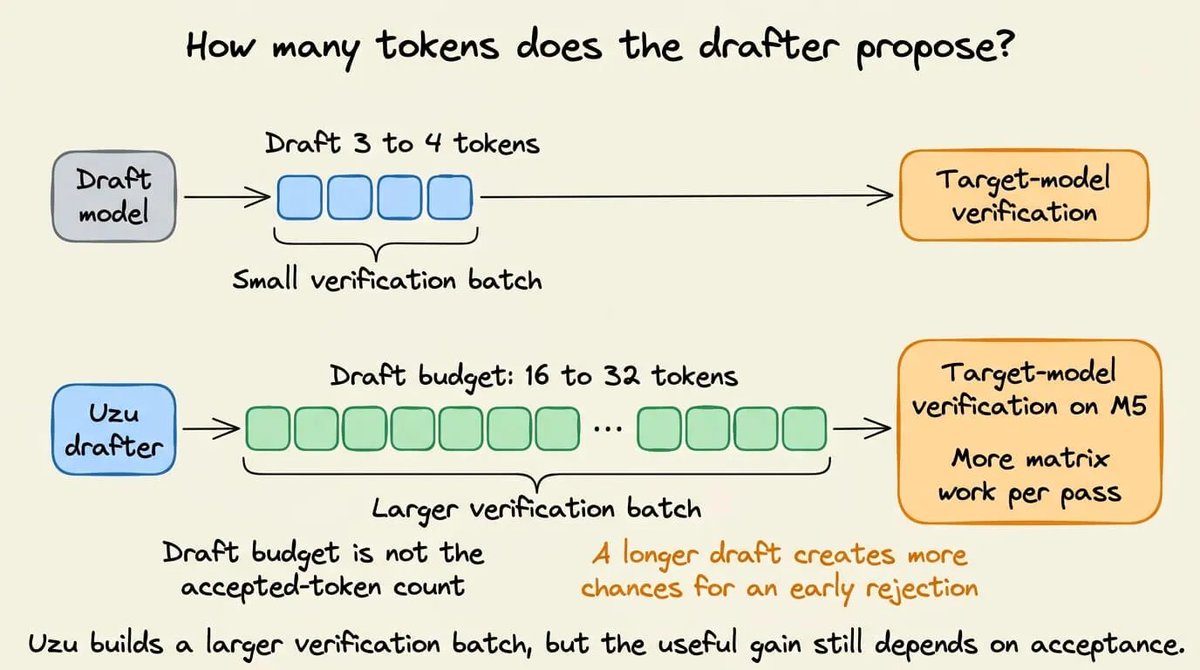
图 10:推测深度越大,硬件利用率越高,但早期错误连带作废后续 token 的概率也成倍上升。
多数模型原生方案通常只敢保守猜测 3 到 4 个 token,典型代表是多 Token 预测(Multi-Token Prediction,MTP)——在模型主干末尾额外训练几个轻量预测头来猜测紧邻的未来词。
而 Uzu 在 M5 架构上大刀阔斧地将推测预算放宽到了 16 到 32 个 token。本文评测所用的 Qwen3.5 9B Checkpoint 在 M5 系列芯片上默认直接拉满了 16-token 的树状推测预算。
如此充裕的批量,终于喂饱了 M5 的神经加速单元(Neural Accelerators)。这些嵌在每个 GPU 核心内的专用矩阵计算单元,唯有在矩阵乘法拥有足够多的行(Token 数量足够多)时才能全力释放峰值吞吐。一次性并行校验 16 个候选 token,为它们奉上了整整 16 行 GEMM 工作负载,彻底告别了以往面对单行(1 token)时的算力饥饿。
然而,更长跨度的并行推测立刻撞上了一堵严重的新墙:自回归语义连贯性失真(Coherence Issue)。
并行草稿生成的语义“脱节”危机
一个速度极快的并行草稿模型往往会单步直接预测未来多个位置的词汇。
不可避免地,每个未来位置虽然看得到历史提示词上下文,但彼此之间却看不到其他草稿位置刚刚挑选了什么词。
例如,对于一句以 “She went to the store to buy” 结尾的提示词,各独立预测位置可能会分别给出 “a”、“few”、“of” 和 “milk”。拆开来看,每个词在局部似乎都成立;但串在一起,却拼凑出了荒谬怪异的语法错误:“a few of milk”。
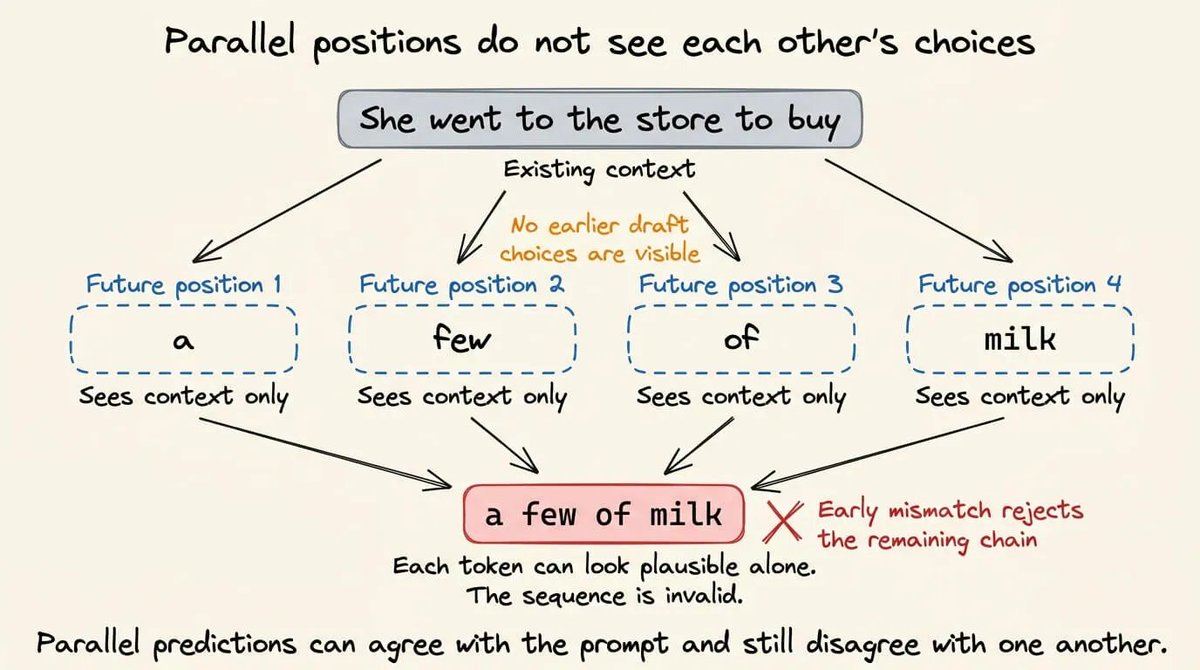
图 11:并行独立推测由于缺乏前序上下文约束,极易生成局部合理但整体脱节的错误组合(如 “a few of milk”)。
只要较早的位置出现词义偏差,整条后续链条就会被主模型无情砍断。这就是为什么随着推测长度增加,传统并行草稿的接受率往往会断崖式暴跌:位置越多,拼凑出语法灾难的概率就呈指数级攀升。
论文《Trees from Marginals》(arXiv:2607.06763)提出的 Weaver 彻底逆转了这一被动局面。在论文设定中,Weaver 是一个仅有 56.7M 参数的极轻量自回归适配器。它不需要在浩瀚的数万全词表上进行昂贵投影,而是专门在草稿模型预先筛选出的候选候选集(Candidate Shortlists)上精细运作。
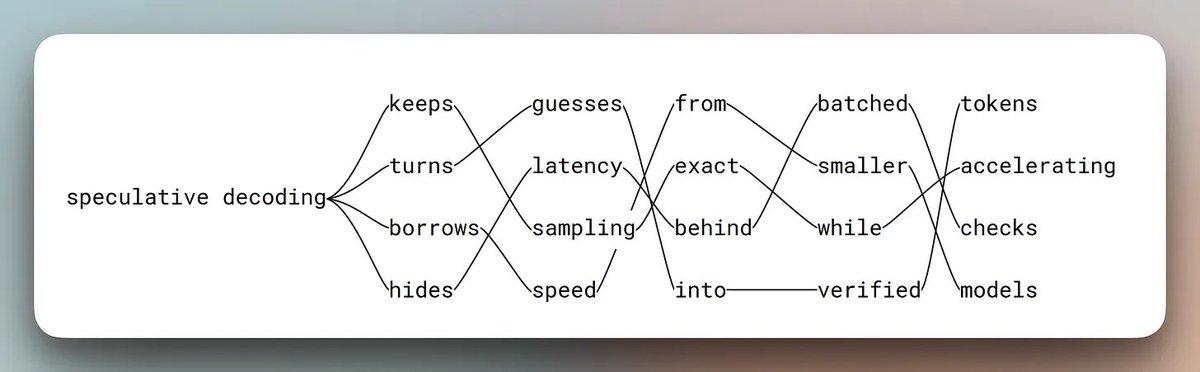
图 12:DFlash 单步快速预测各位置高概率候选集,Weaver 自回归挑选连贯词条,构建出语法严谨的推测树。
其协作流程极其优雅:并行 DFlash 草稿器首先单步预测未来每个位置的高置信度候选池;随后,Weaver 自回归地依次从这些候选词中挑选组合,每个位置的选择都严格建立在先前位置已选定词的基础上。
前面的离谱错误被瞬间纠偏为通顺连贯的 “a gallon of milk”。
更强大的是,Weaver 能够同时维护多条彼此连贯的语义路径,构建出一棵茂密的推测树(Speculative Tree):一条分支可能是 “a gallon of milk”,另一条分支可能是 “a bottle of juice”。主模型随后对整棵树进行一次性全局验证,并采纳其中最长的一条正确路径。
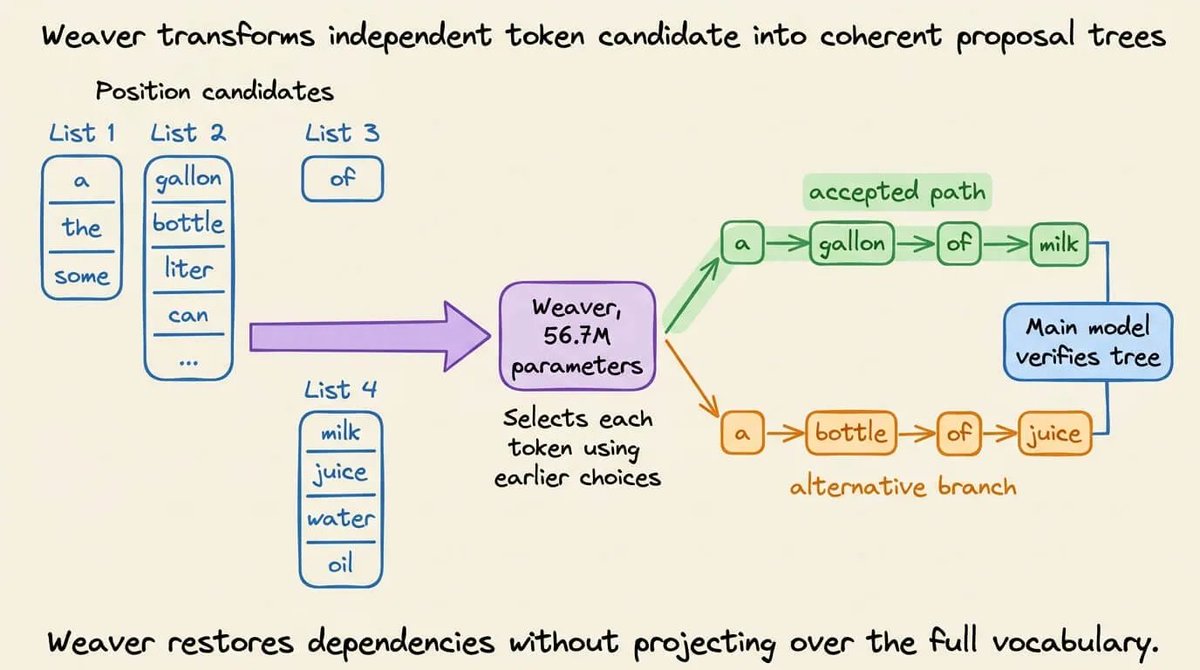
图 13:Weaver 在单次验证中同时维护多条语义连贯的备选分支,显著提升了最长有效前缀的命中率。
推测树的形态还能根据具体任务智能自适应:面对模式严谨、确定性极高的代码生成,它可以收拢为一条狭长深邃的单一分支;而面对发散性极强的创意写作,它则自动展开为多条浅层宽分支以捕捉多样语义。
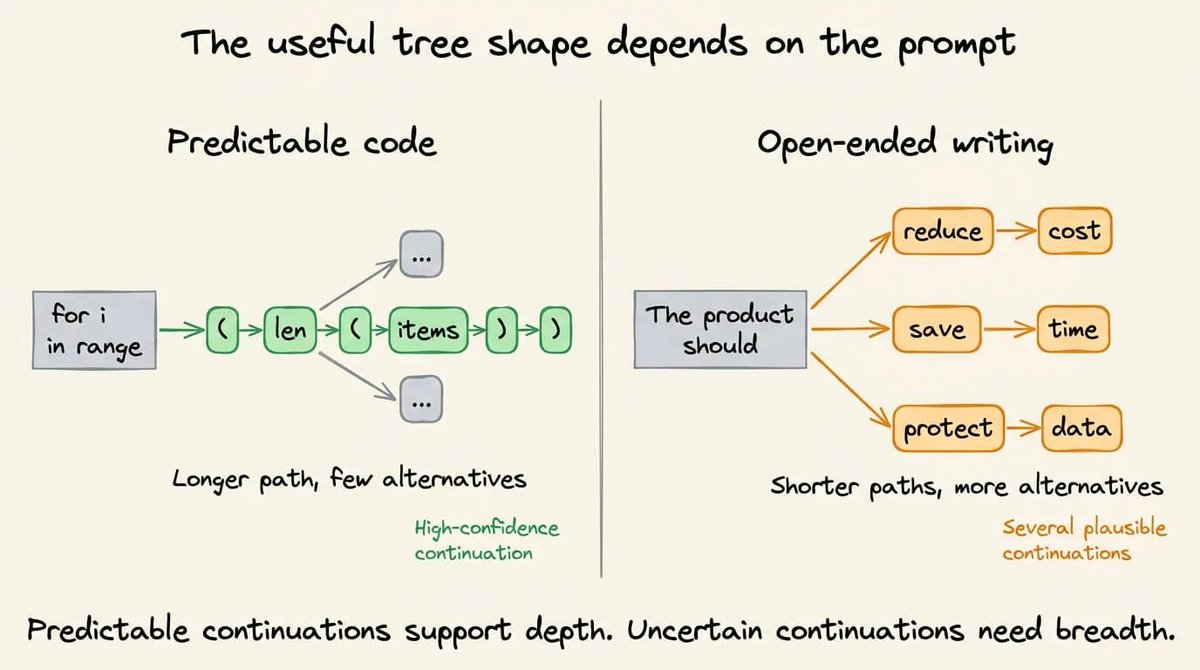
图 14:树形态根据工作负载自适应调整:代码场景深且窄,发散对话宽且浅。
该论文报告,相比于优化后的 DFlash 基线,Weaver 带来了 24.7% 的净增益;相比传统自回归解码,实现了高达 4.37 倍的加速(基于 CUDA 与 SGLang 平台)。
Uzu 将这套前沿的推测生成范式完整复刻并深度定制到了面向 Apple Silicon 的专属运行时中。但剩下的最后一个硬核工程难关依然横亘眼前:面对一棵复杂的推测树,主模型究竟该如何高效验证?
突破状态墙:无需回滚的树状无循环验证
现代语言模型中的许多层往往带有动态变化的内部循环状态(Running Internal State)。每流入一个新 token,模型都会读取该状态并立即就地更新。在单序列生成中,运行时只需按步就班依次更新即可。
然而,推测树分叉出了多条并行的未来可能性,每个候选分支都会试图将内部状态修改为不同的版本。如果推理引擎在验证一条分支时直接修改了全局活跃状态,那么在转去验证另一条分支之前,就必须把状态**完全回滚(Rollback / Restore)**到分叉点。在一棵动辄数十节点的复杂推测树上反复执行状态保存与回滚,会引发海量的数据搬运与重复计算。
Qwen3.5 与 Qwen3.6 内部包含了大量被称为 门控 DeltaNet(Gated DeltaNet) 的有状态层。常规注意力层维护的是随长度不断追加的线性 KV Cache;而 Gated DeltaNet 层则把全部历史信息压缩到一个固定维度的循环状态中,每一个新 token 都会改写该状态。
在 Qwen3.5 9B 模型中,全部 32 层网络里有整整 24 层 都属于这种 Gated DeltaNet 状态层!
Uzu 的神来之笔在于彻底将候选分支的验证计算与**最终状态的提交生效(State Commit)**完全解耦:在验证阶段,它在完全不破坏全局活跃状态的前提下,一次性并发计算出所有候选分支所需的输出值;待主模型完成仲裁并锁定采纳的最长路径后,Uzu 仅仅沿着胜出的这一条路径提交最终的状态更新。
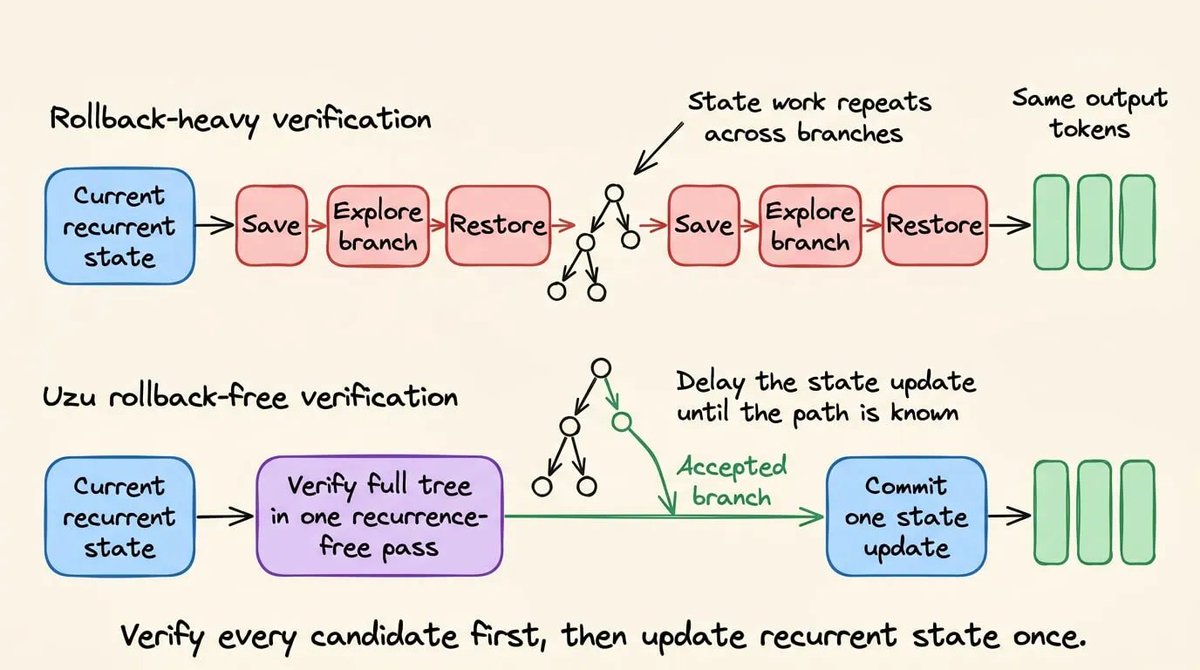
图 15:无回滚树状验证机制。整树并发计算,状态单向提交,彻底消除传统分支回滚的显存与计算开销。
Mirai 在其底层实现技术笔记中将该创新定义为无回滚树状验证(Rollback-Free Tree Verification)。其底层的 Metal 算子直接在单次无循环的前向传播中并行算完整棵树的 DeltaNet 输出,完全免去了逐 token、逐分支循环推进的陈旧逻辑。
状态更新仅沿选定分支一次性写入,从根本上杜绝了错误分支的状态污染与回滚惩罚。
这项优化决定了推测解码的生死:推测解码能够产生正收益的唯一前提,就是验证开销必须显著低于逐步自回归解码。反复折腾状态回滚必然会侵蚀掉推测解码带来的全部加速红利。
Weaver 连贯推测树与无回滚验证的深度结合,使得 Uzu 能够肆无忌惮地抛出极长的推测序列,并在零回滚惩罚下完成闪电般的校验。
基础款 M5 上的实机速度直击
为了直观见证常规解码、传统推测解码与 Uzu 全新范式之间的巨大鸿沟,我们在配备基础款 M5 芯片、16 GB 统一内存的 MacBook Pro 上,对同一个 Qwen3.5 9B 模型进行了三路硬核实测:
- llama.cpp:关闭推测解码(标准基线)
- llama.cpp (MTP):开启模型原生 MTP 预测头,向前推测 3 个 token(常规推测解码配置)
- Uzu:启用 DFlash + Weaver 投机树与专用 Metal 算子
三者均采用 4-bit 权重,输入完全一致的提示词:“Write a python function to merge two sorted lists.”
视频 1:Base M5 上三套推理路径的实测录屏对比(llama.cpp 无推测 vs llama.cpp 3-token MTP vs Uzu DFlash+Weaver)。点击观看高码率实测视频(MP4)
实测录屏清晰展现了三者的节奏差异:llama.cpp 步步为营,MTP 略有提速,而 Uzu 则如水银泻地般瞬间刷出完整回复。
官方公布的基准测试数据
除了上述实测,Mirai 官方还公布了涵盖吞吐量、上下文处理、内存占用与量化精度的全面基准测试。
在更庞大的 Qwen3.6 27B Mirai-M(权重占用 15.6 GB,实测于 128GB 内存的 M5 Max)上:
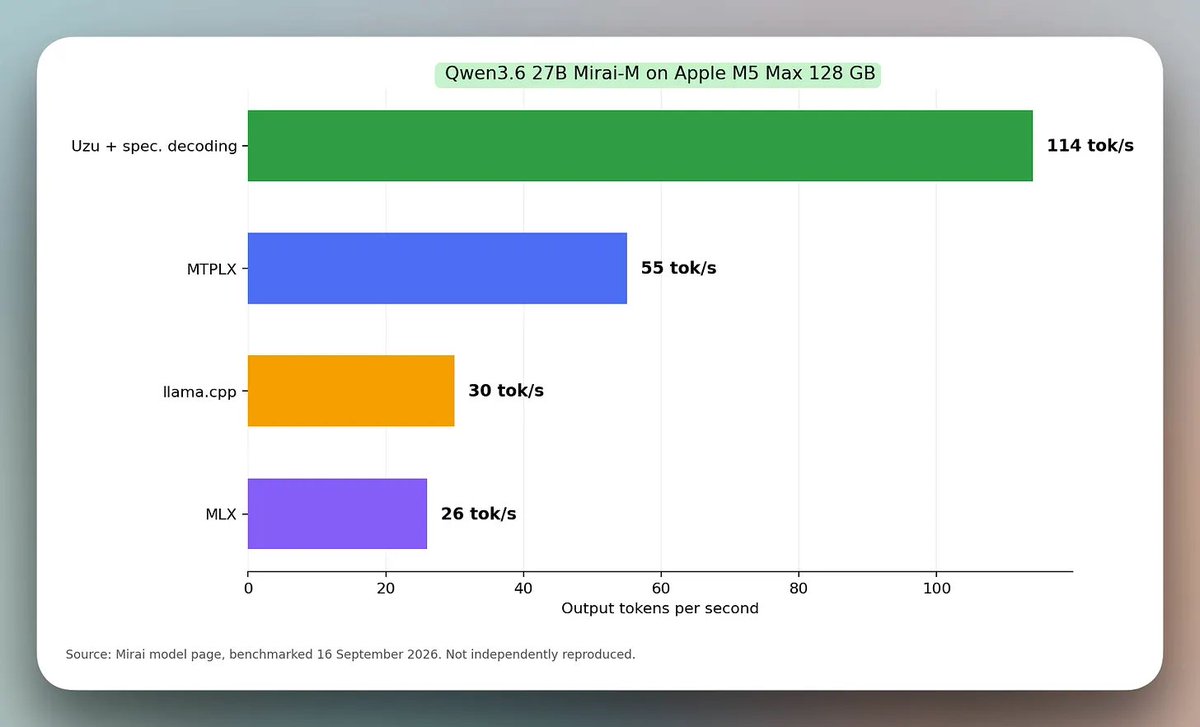
图 16:Qwen3.6 27B 在 M5 Max 上的测试成绩。Uzu 推测解码达到 114 tok/s,大幅碾压 MTPLX、llama.cpp 与 MLX。
测试数据显示,Uzu 的推测生成速度达到了:
- MTPLX 的 2.1 倍
- llama.cpp 的 3.8 倍
- MLX 的 4.4 倍
更值得注意的是,未开启推测时,Uzu 原生速度为 35.54 tok/s;而开启推测解码后直接飞跃至 114 tok/s,推测路径带来了高达 3.2 倍的纯性能净收益。
此外,官方还测试了不同生成任务下的速度表现:
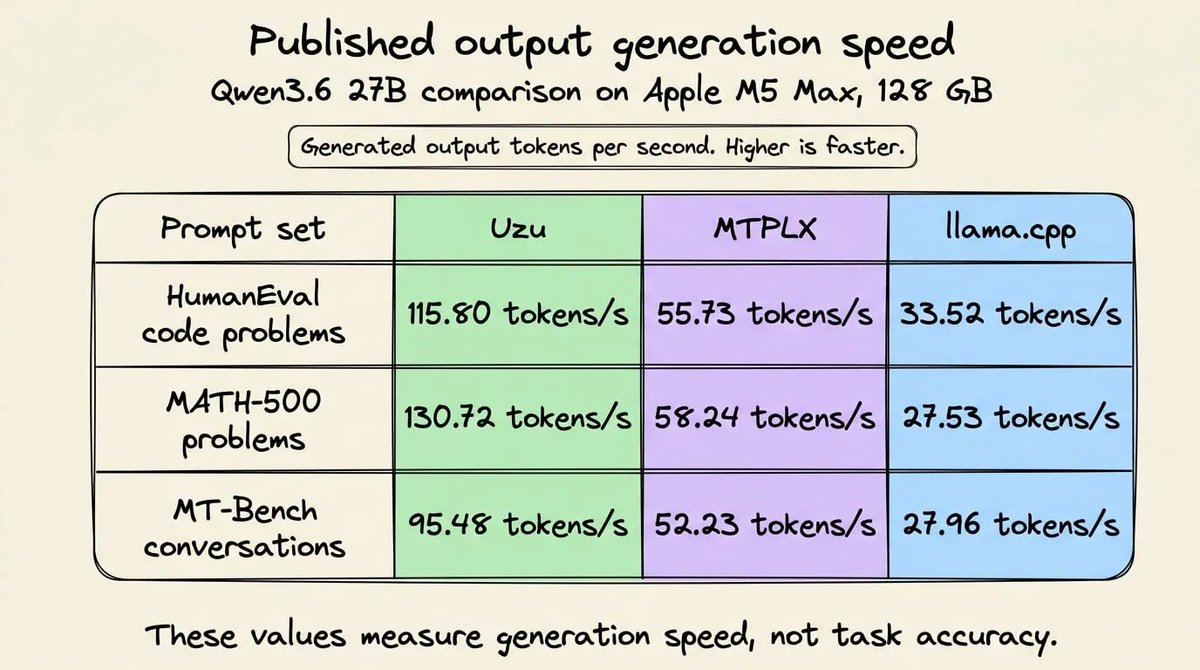
图 17:不同工作负载下的生成速度。代码与数学由于逻辑连贯确定性高,速度超过 114 tok/s;而开放式对话发散度高,速度为 83 tok/s。
代码与数学推导包含大量确定性的逻辑延续,草稿命中率极高(分别达到 114 tok/s 与 117 tok/s);而开放式日常对话给草稿器留下的确定性较少(83 tok/s)。这也再次印证了推测解码的核心法则:推测速度是工作负载的动态属性,而非一个永恒不变的静态数字。
本地极速上手与运行时指标探秘
体验 Uzu 最快捷的方式是其官方命令行工具。通过 Homebrew 即可一键安装,首次运行会自动拉取对应模型:
brew install mirai

mirai --model trymirai/Qwen3.5-9B-M \
  -m "Write a python function to merge two sorted lists"
我们在 macOS 26.6.2、配备基础款 M5 芯片与 16 GB 统一内存的 MacBook Pro 上使用 Mirai CLI 0.6.1 进行了实测:
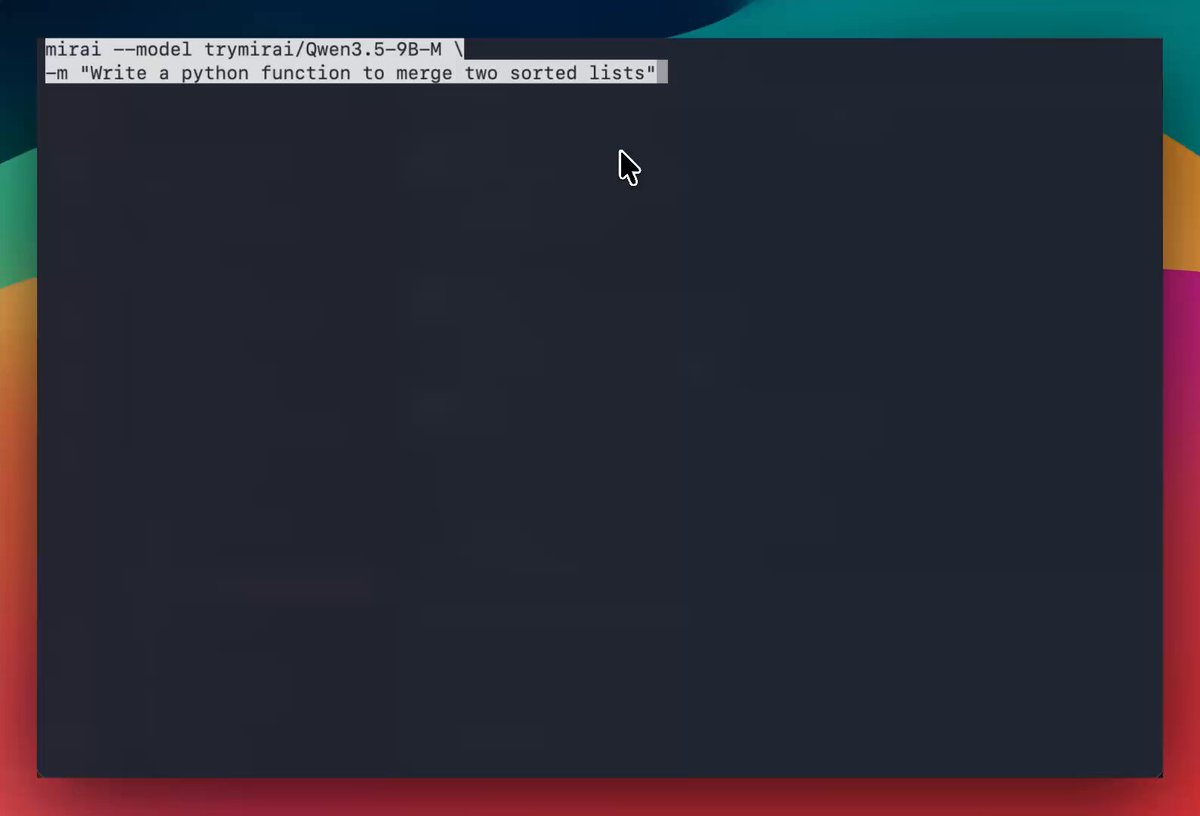
视频 2:Mirai CLI 终端下实时生成录屏演示。点击观看高清实录视频(MP4)
在输出完整回复后,CLI 终端打印出了极其详尽的性能统计面板:
time to first token: 0.12 s
prefill speed: 161.11 t/s
generation speed: 98.10 t/s
tokens per forward pass: 8.39 t/f
memory used: 5.77 GB
total energy: 114.90 J
input energy per token: 0.11 J/tok
output energy per token: 0.16 J/tok
duration: 7.36 s
这些关键指标蕴含着极其关键的物理意义:
- Time to first token (0.12 s):首字延迟(TTFT),即发出请求后到第一个 token 打印在屏幕前的等待时间。该开销绝大部分用于 Prefill 提示词。
- Prefill speed (161.11 t/s):预填充吞吐率。当前测试提示词仅约 20 个 token,规模较小;在长提示词场景下该吞吐会进一步攀升。
- Generation speed (98.10 t/s):端到端生成吐字速度。这正是前文重点讨论的、传统方式被内存带宽死死卡在 29 tok/s 的解码阶段。
- Tokens per forward pass (8.39 t/f):每次前向传播产生的有效 Token 数。在传统逐步解码中,该数值在数学上恒等于严格的 1.00。而在 Uzu 中,该数值高达 8.39!
- Memory used (5.77 GB):占用的统一内存总量,主要包含 9B 主模型权重、草稿模型及 KV Cache。
8.39 t/f 这一数字正是整个推测奇迹的核心密码:在 9B 模型单次前向传播中,平均每次前向能直接产出 8 个以上的有效 token。这正是它能在一块物理上限仅 29 tok/s 的芯片上狂飙到近 100 tok/s 的根本原因!
注:各次运行之间速度会有轻微波动。在我们进行的多次实测中,生成速度在 92 到 117 tok/s 之间浮动,平均每次前向有效产出在 7.5 到 9.6 个 token 之间。
推测加速针对芯片硬件精细开启。当前 Checkpoint 的推测配置原生覆盖了 M5、M5 Pro 与 M5 Max;若在 M1 至 M4 系列的旧款 Mac 上运行,CLI 会自动降级为无草稿的纯原生解码(指标显示 1.00 t/f)。
将 Uzu 作为本地 API 服务接入应用
Uzu 原生内置了完全兼容 OpenAI 标准协议的本地 HTTP 服务。模型完全在本地离线运行,所有的 HTTP 请求仅仅走本机回环地址(Loopback Interface):
mirai server --model trymirai/Qwen3.5-9B-M --port 8000 --no-prefix-cache服务加载本地 Checkpoint 并监听在 127.0.0.1:8000。任何现有的基于 OpenAI SDK 编写的应用、Agent 或工作流均可无缝切换:
- 默认情况下,Uzu 会开启前缀缓存(Prefix Cache),保存先前提示词的处理状态,使重复上下文直接跳过 Prefill。
- 在上述命令中加入
--no-prefix-cache是为了在基准评测时关闭这一特性,迫使每一次请求都老老实实执行完整的运算,确保多次对比结果的严密客观。
现有程序只需将请求端点指向 http://127.0.0.1:8000/v1 即可享受毫秒级疾速推理。
一套客户端同台压测:Uzu、MLX 与 llama.cpp
为了彻底排除客户端网络层与业务逻辑的干扰,我们在同一台纯净的基础款 M5 MacBook Pro 上,使用统一的压测客户端对三大主流引擎进行了严密对比:
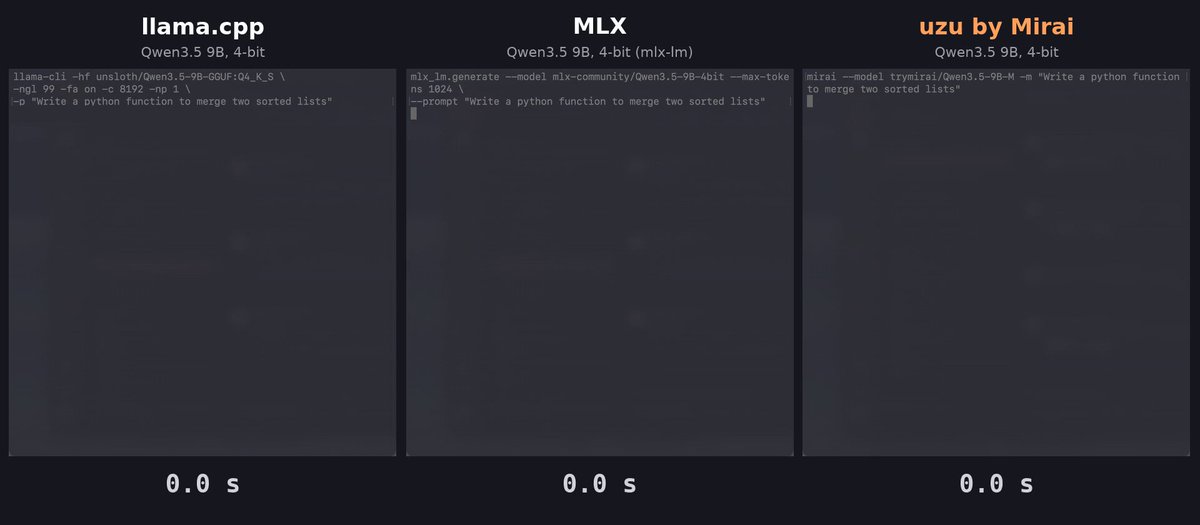
视频 3:使用同一 Python 压测脚本,依次对 Uzu、MLX 与 llama.cpp 进行基准测试。点击观看完整录屏(MP4)
实测数据显示:llama.cpp 与 MLX 均受制于每次前向产出 1 个 token 的铁律,双双停留在 29 tok/s 物理红线之下;而 Uzu 在相同芯片上的输出速度达到了 MLX 的 3.7 倍。
部署三大本地服务
为了确保公平,建议依次单独启动各引擎服务,避免内存与带宽竞争。
1. 启动 Uzu(端口 8000)
加载 Mirai 优化的 4-bit Medium Checkpoint:
mirai server --model trymirai/Qwen3.5-9B-M --port 80002. 启动 MLX LM(端口 8001)
加载同源基座模型的 4-bit MLX 官方转换版本:
brew install uv
uv tool install mlx-lm
uv tool update-shell
打开新终端后启动服务:
mlx_lm.server --model mlx-community/Qwen3.5-9B-4bit --port 80013. 启动 llama.cpp(端口 8002)
加载同源的 Q4_K_S GGUF Checkpoint:
brew install llama.cpp
llama-server --version

llama-server \
  -hf unsloth/Qwen3.5-9B-MTP-GGUF:Q4_K_S \
  --alias qwen3.5-9b-q4-k-s \
  -ngl 99 -fa on -c 8192 -np 1 \
--port 8002参数说明:
-c 8192限制了上下文长度,防止 llama.cpp 在 16GB 内存设备上预先分配满全部 262K 上下文导致 OOM;-np 1设定单并发槽位。如需开启 llama.cpp 的 MTP 推测,只需追加参数--spec-type draft-mtp --spec-draft-n-max 3。
关于量化版本的说明:这三个 Checkpoint 源自同一个 Qwen3.5 9B 模型,但使用了各自生态专用的量化算法(Uzu 为 Mirai-M,MLX 为 MLX-4bit,llama.cpp 为 Q4_K_S)。因此,这是一场开发者真实体验的完整端到端推理栈对比,而非单一纯算子测试。
编写独立基准评测客户端
以下是用纯 Python 标准库编写的测试脚本 compare_client.py,无需安装任何第三方库:
import json, os, sys, time, urllib.request

PROMPT = "Write a Python function that merges two sorted lists."

body = json.dumps({
    "model": os.environ["MODEL"],
    "messages": [{"role": "user", "content": PROMPT}],
    "temperature": 0,                                    # 固定输出结果,保证每次运行确定性
    "max_tokens": 1024,
    "stream": True,                                      # 流式接收 token
    "stream_options": {"include_usage": True},           # 获取服务端的 token 统计
    "chat_template_kwargs": {"enable_thinking": False},  # 关闭 thinking 模式,直接输出正文
}).encode()
request = urllib.request.Request(os.environ["ENDPOINT"], body, {"Content-Type": "application/json"})

start = time.perf_counter()
first = last = None
usage = {}

with urllib.request.urlopen(request, timeout=600) as response:
    for line in response:
        line = line.decode().strip()
        if not line.startswith("data:"):
            continue
        data = line[5:].strip()
        if data == "[DONE]":
            break
        event = json.loads(data)
        usage = event.get("usage") or usage
        for choice in event.get("choices") or []:
            delta = choice.get("delta") or {}
            text = delta.get("content") or ""
            if text or delta.get("reasoning_content") or delta.get("reasoning"):
                last = time.perf_counter()
                first = first or last
            print(text, end="", flush=True)

if first is None:
    sys.exit("未收到任何 token,请检查服务日志。")

tokens = usage.get("completion_tokens", 0)
print(f"\n\ntime to first token: {first - start:.2f} s")
print(f"end-to-end time:     {time.perf_counter() - start:.2f} s")
if tokens > 1 and last > first:
    print(f"decode speed:        {(tokens - 1) / (last - first):.1f} tok/s")
if usage.get("spec_verify_ct"):  # 仅 Uzu 会在统计中返回主模型实际执行的前向次数
    print(f"tokens per pass:     {tokens / usage['spec_verify_ct']:.2f}")
规范执行测试
重要测试准则:
- 每次仅启动一个服务,避免双模型争抢统一内存与显存带宽。
- 每个引擎各执行两次客户端请求:第一次作为预热丢弃,记录第二次的稳定测速值。
- 严格保持机器供电模式、采样温度、输出上限与提示词一致。
测试 Uzu:
# 终端 1
mirai server --model trymirai/Qwen3.5-9B-M --port 8000 --no-prefix-cache

# 终端 2
ENDPOINT=http://127.0.0.1:8000/v1/chat/completions \
MODEL=trymirai/Qwen3.5-9B-M \
python3 compare_client.py
测试 MLX:
# 终端 1
mlx_lm.server --model mlx-community/Qwen3.5-9B-4bit --port 8001

# 终端 2
ENDPOINT=http://127.0.0.1:8001/v1/chat/completions \
MODEL=mlx-community/Qwen3.5-9B-4bit \
python3 compare_client.py
测试 llama.cpp:
# 终端 1
llama-server -hf unsloth/Qwen3.5-9B-MTP-GGUF:Q4_K_S --alias qwen3.5-9b-q4-k-s -ngl 99 -fa on -c 8192 -np 1 --port 8002

# 终端 2
ENDPOINT=http://127.0.0.1:8002/v1/chat/completions \
MODEL=qwen3.5-9b-q4-k-s \
python3 compare_client.py注:客户端测得的解码速度包含了 HTTP 传输流解析开销,通常会略低于引擎核心日志内打印的原生速度。评测时应当使用客户端数字相互对比。
总结
将模型量化压缩装入显存,仅仅是本地推理万里长征迈出的第一步。
在端侧个人设备、Batch=1 的严苛现实下,真正的工程艺术在于:如何打破访存墙的铁律,让芯片的计算潜能充分变现。
Uzu 给出了教科书般的体系结构破局范式:
- 数值与计算协同:低比特量化降低访存带宽压力,结合 RHT 变换抹平离群值;
- 硬件底层定制:专为 Apple M5 架构编写的高能效 int8 Metal 矩阵算子;
- 前沿算法工程化:引入 DFlash-Weaver 架构,克服传统并行草稿的连贯性硬伤,构建深度自适应推测树;
- 状态无损校验:针对有状态 Gated DeltaNet 架构设计无回滚树状验证,彻底免去回滚与数据冗余拷贝。
在最普通的基础款 M5 设备上,这套组合拳硬是将 4-bit 9B 模型的实际生成速度从传统方案的 22 tok/s 推升到了惊人的 92~117 tok/s。
推测加速并非一成不变的魔法,具体的加速比会随着硬件架构、量化水平、上下文长度与任务发散度而动态演变。最严谨的检验,始终是在你自己真实的业务提示词上亲自实测。
图 18:Uzu 开源推理引擎,提供 Rust、Swift、Python 与 TypeScript 语言绑定。
如果你想深入探究其底层实现,Uzu 已经在 GitHub 上完整开源,包含了完整的引擎核心、本地服务端及多语言绑定:
👉 点击访问 GitHub: trymirai/uzu (别忘了给项目点个 Star ⭐️)