 yuzheng
翻译与阅读笔记
图解大模型推理:从 Prefill 到 Decode
沿分词、注意力、KV Cache 和解码的执行路径,理解推理延迟与吞吐瓶颈。
沿一次请求理解推理开销
一次大模型生成请求可以拆成输入处理、Prefill、逐步 Decode 和输出采样。它们共享模型权重,却有不同的数据规模和计算特征。本文依据已有图解译稿整理,沿这条执行路径说明 KV Cache、注意力架构、量化和服务调度分别影响哪些开销。
Prefill 常呈现较高的计算密度,小批量 Decode 则经常受权重与 KV 的读取带宽限制。这是分析的起点,而不是所有模型和批大小下都成立的固定分类;实际瓶颈仍需要测量。
1. 分词与向量嵌入
BPE(字节对编码,Byte Pair Encoding)等分词器负责将原始文本转换为词表中的整数 ID。词表大小由模型与分词器决定,下面用 50,000 作为示例。
# 1. 文本输入:原始自然语言提示词 Prompt
prompt = "How does inference work?"

# 2. 分词编码:BPE 分词器将文本子词切分为离散词表中的整数 Token ID
# 词表规模约为 50,000,每个子词对应唯一的一个整数标识符
ids = tokenizer.encode(prompt)  # 输出示例 -> [2437, 1374, 32278, 670, 30]
每个 Token ID 对应嵌入表(Embedding Table)中的一行。嵌入表是一个形状为 [vocab_size, hidden_dim] 的可学习矩阵。以隐层维度为 4,096 的模型为例,每个 Token 均映射为一个 4,096 维的连续稠密向量。
# 1. 嵌入表规格:形状为 [vocab_size, hidden_dim],存储各 Token 的稠密语义特征
# 对于 hidden_dim = 4096 的大模型,嵌入表为 50000 x 4096 的大型权重矩阵

# 2. 向量检索:通过整型索引直接从嵌入表中切片提取对应行向量
# 单次查表将 [num_tokens] 的 ID 列表映射为二维浮点张量 [num_tokens, 4096]
vectors = embedding_table[ids]   # 输出张量形状: [num_tokens, 4096]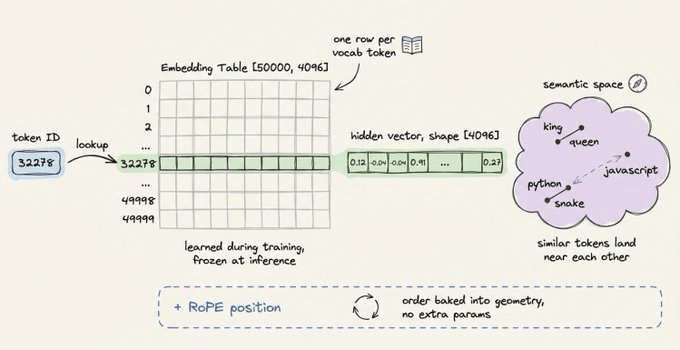
图 1 Token ID 通过嵌入表映射为固定维度的稠密向量序列
模型还需要位置信息。采用 RoPE(旋转位置编码) 的 Transformer 会在注意力层中对 Query 和 Key 应用与位置相关的旋转;它不等同于直接旋转词嵌入表中的向量。
2. Transformer 计算层
完成嵌入的序列将依次穿过多层堆叠的 Transformer 结构(通常为 32 到 80+ 层,具体取决于模型规模)。
每一层顺序执行以下两项核心操作:
1) 自注意力机制
通过可学习的权重矩阵,为每个 Token 分别计算 Query(Q)、Key(K)和 Value(V)三组投影向量。
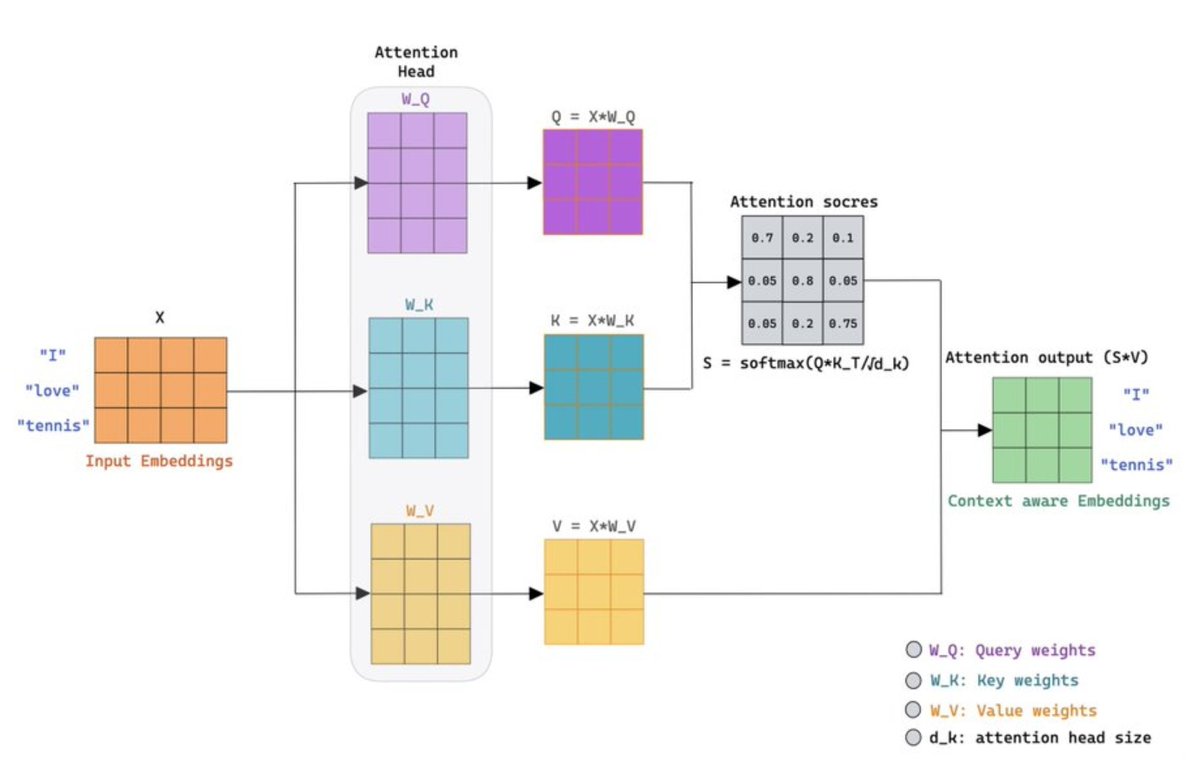
图 2 每个 Token 投影生成 Q、K、V 向量并计算注意力打分矩阵
每个 Token 的 Query 会与其余所有 Token 的 Key 进行点积打分。这些分数经过除以 sqrt(d_k) 缩放并经 Softmax 归一化后,决定了各个 Token 的 Value 参与融合的权重比例:
# 1. Q、K、V 投影:利用可学习权重矩阵完成线性映射
# x 为输入特征序列,Wq, Wk, Wv 分别为主注意力投影矩阵
Q, K, V = x @ Wq, x @ Wk, x @ Wv

# 2. 注意力打分:计算 Query 与 Key 之间的点积相似度,并除以 sqrt(d_k) 缩放防止梯度爆炸
scores = (Q @ K.T) / sqrt(d_k)

# 3. 权重归一化:Softmax 作用在最后一维,每一行权重之和严格等于 1
weights = softmax(scores)        # 形状: [num_tokens, num_tokens]

# 4. 加权聚合:依据注意力权重将各个 Token 的 Value 向量加权混合
attn_output = weights @ V        # 最终产出融入上下文关联的新表征向量
2) 前馈神经网络
通过两层 MLP 对每个 Token 的向量独立进行非线性变换。一句话概括二者分工: Attention 负责在不同 Token 位置之间传递信息,FFN 负责在位置内部完成高阶特征变换。
通过最后一层 Transformer 后,模型将序列末位 Token 的隐藏状态重新投影回词表维度([hidden_dim, vocab_size]),经过 Softmax 转换概率后采样生成首个输出 Token。
3. Prefill 阶段:计算受限
处理输入 Prompt 是推理的第一阶段。在该阶段中, 所有输入 Token 均被并行处理 :模型同时计算全部 Token 的 Q、K、V 投影,注意力运算表现为高密度的大规模矩阵相乘(GEMM)。
该阶段属于典型的 计算受限(Compute-bound) 任务。此时 GPU 的算术吞吐单元是主要性能瓶颈,算力利用率通常维持在高位。衡量该阶段性能的核心指标是 TTFT(Time to First Token,首字时延) ,即自发送请求起至产生首个输出 Token 为止的延迟。
在 Prefill 过程中,模型还会建立 KV Cache :每一层生成的 K 和 V 张量均会被持久存储在显存中以备后续解码复用。
# ==============================================================================
# Prefill(预填充)阶段:一次性并行计算整个输入 Prompt(计算受限 Compute-Bound)
# ==============================================================================

# 1. 嵌入与位置编码:查表获取 Prompt 全部 Token 的向量表示,并注入 RoPE 旋转位置信息
hidden = embed(prompt_tokens) + positions

# 2. 逐层前向传递:遍历模型所有 Transformer 层(通常 32~80+ 层)
for layer in model.layers:
    # 步骤 ①:同时并行计算当前层所有 Token 的 Q、K、V 投影矩阵
    Q, K, V = project(hidden)             # 矩阵规模: [num_prompt_tokens, hidden_dim]

    # 步骤 ②:多头自注意力计算并叠加残差连接
    hidden  = attention(Q, K, V) + hidden

    # 步骤 ③:FFN(前馈网络双层 MLP)非线性变换并叠加残差
    hidden  = feedforward(hidden) + hidden

    # 步骤 ④【核心机制】:将当前层计算的全部 K、V 写入 GPU 显存中的 KV Cache 供后续复用!
    cache_kv(layer, K, V)

# 3. 首字采样:仅提取序列末位 Token 的隐藏状态,投影至词表空间并采样得到第 1 个输出 Token
first_token = sample(project_to_vocab(hidden[-1]))
4. Decode 阶段:访存受限
首个 Token 生成完毕后,模型转入自回归解码循环,每次迭代仅生成 1 个新 Token。对于每一个新生成的 Token,模型仅需为其自身计算单步的 Q、K、V 向量,而所有历史 Token 的 K 和 V 已经存在于 KV Cache 中。
# ==============================================================================
# Decode(解码)阶段:逐字自回归迭代生成(访存受限 Memory-Bound)
# ==============================================================================

token = first_token
steps = 0

# 自回归生成循环:一次循环产出 1 个 Token,直至遇到结束符 STOP 或达到最大步数
while token != STOP and steps < MAX_STEPS:
    # 1. 仅为当前这单个最新 Token 进行嵌入与位置编码
    x = embed(token) + position(steps)

    # 2. 逐层前向传播:
    for layer in model.layers:
        # 步骤 ①:仅计算当前单 Token 的投影向量 q, k, v(计算量极小)
        q, k, v = project(x)

        # 步骤 ②【核心机制】:将当前步的 k, v 增量追加至历史缓存,直接获取完整上下文历史
        K_all, V_all = caches[layer].append(k, v)  # 拼接历史已缓存的所有 Token K/V

        # 步骤 ③:当前单个 q 与整段历史 K_all 做点积注意力,计算 FFN,累加残差
        # 硬件瓶颈:计算量虽小,但每一步都必须完整从显存重新加载全部模型权重与全部 KV Cache!
        x = layer.forward(q, K_all, V_all, x)

    # 3. 采样并流式吐字:
    token = sample(project_to_vocab(x))
    steps += 1
    yield token  # 立即流式返回给用户界面
在 Decode 单步中,算术计算量极小(仅计算单个 Query 向量与历史 Key 矩阵的矩阵向量乘,而非大矩阵乘法)。然而,GPU 依然必须从高带宽显存(HBM)中完整读取整套模型权重矩阵以及累积的全部 KV Cache 数据。 此时系统瓶颈由算力翻转为显存带宽(Memory Bandwidth)。
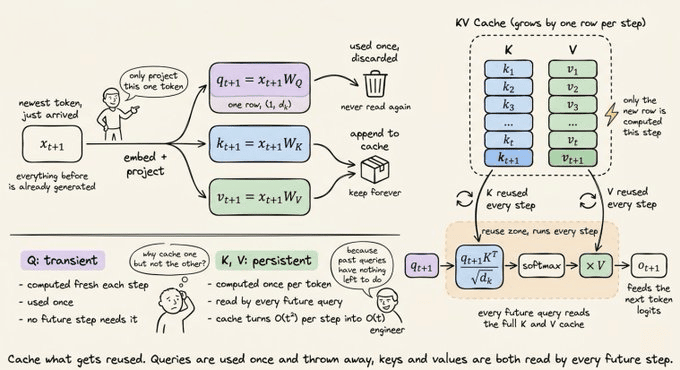
图 3 Decode 阶段仅做少量矢量运算,却需频繁从显存搬运庞大权重与 KV Cache,导致带宽成为瓶颈
衡量该阶段的核心性能指标是 ITL(Inter-Token Latency,Token 间延迟) ,即连续两个输出 Token 之间的时间间隔。保持较低的 ITL 是保证流式打字效果流畅的关键。
5. KV Cache:原理与显存代价
若不采用 KV 缓存,每生成 1 个新 Token 都需要对整个逐步增长的历史序列重新计算注意力,生成 1,000 个 Token 将引发二次方级()的巨大算力浪费。
KV Cache 将每一层计算过的 K 和 V 状态保存于显存中,后续步骤仅需增量追加。在长文本生成场景下,KV Cache 可带来 5 倍以上的端到端推理提速 。
视频 开启与未开启 KV Cache 时的大模型推理速度直观对比(速度差异超 5 倍)
但这种加速并非毫无代价: Cache 显存占用随序列长度呈线性增长,且在每一层均独立分配 。以 13B 参数量模型为例:
- 每个 Token 平均消耗约 1 MB 显存;
- 一个 4,000 Token 的上下文,仅 KV Cache 就需独占 4 GB 显存。
这正是长上下文成本昂贵的核心原因: KV Cache 显存与 Batch 并发请求直接争抢物理显存 。单个请求占用的 Cache 越多,单张 GPU 允许同时处理的并发请求数就越少。
🤔 经典面试思考题:
使用 vLLM 部署推理模型时,遇到长推理序列频发 OOM(显存溢出)。若此时引入 KV Cache 压缩算法并驱逐了 90% 的缓存 Token,却发现物理显存占用未见下降且依然发生 OOM,原因何在?
(提示:vLLM 的内存管理采用预分配机制,物理 Block 在释放后可能仍保留在预分配池中,或由于激活值峰值内存与分页碎片引发 OOM)
业界主流缓解策略包括:
- Cache 量化 :将 KV 精度压缩至 INT8 或 INT4;
- 滑动窗口注意力(Sliding Window Attention) :丢弃超出固定窗口的历史缓存;
- GQA(分组查询注意力,Grouped-Query Attention) :多个 Query 头共用一组 K/V 头,大幅精简缓存张量数量;
- PagedAttention :类似操作系统虚拟内存分页机制,以 Block 为单位动态分配 Cache,彻底消除了显存碎片。
6. 围绕 Cache 重新设计注意力架构
量化与分页主要是将 KV Cache 视为“固定成本”来进行工程调度管理。而 DeepSeek 在其架构设计中采取了全新路径: 直接重构注意力机制,使 Cache 在模型结构层面原生缩减。
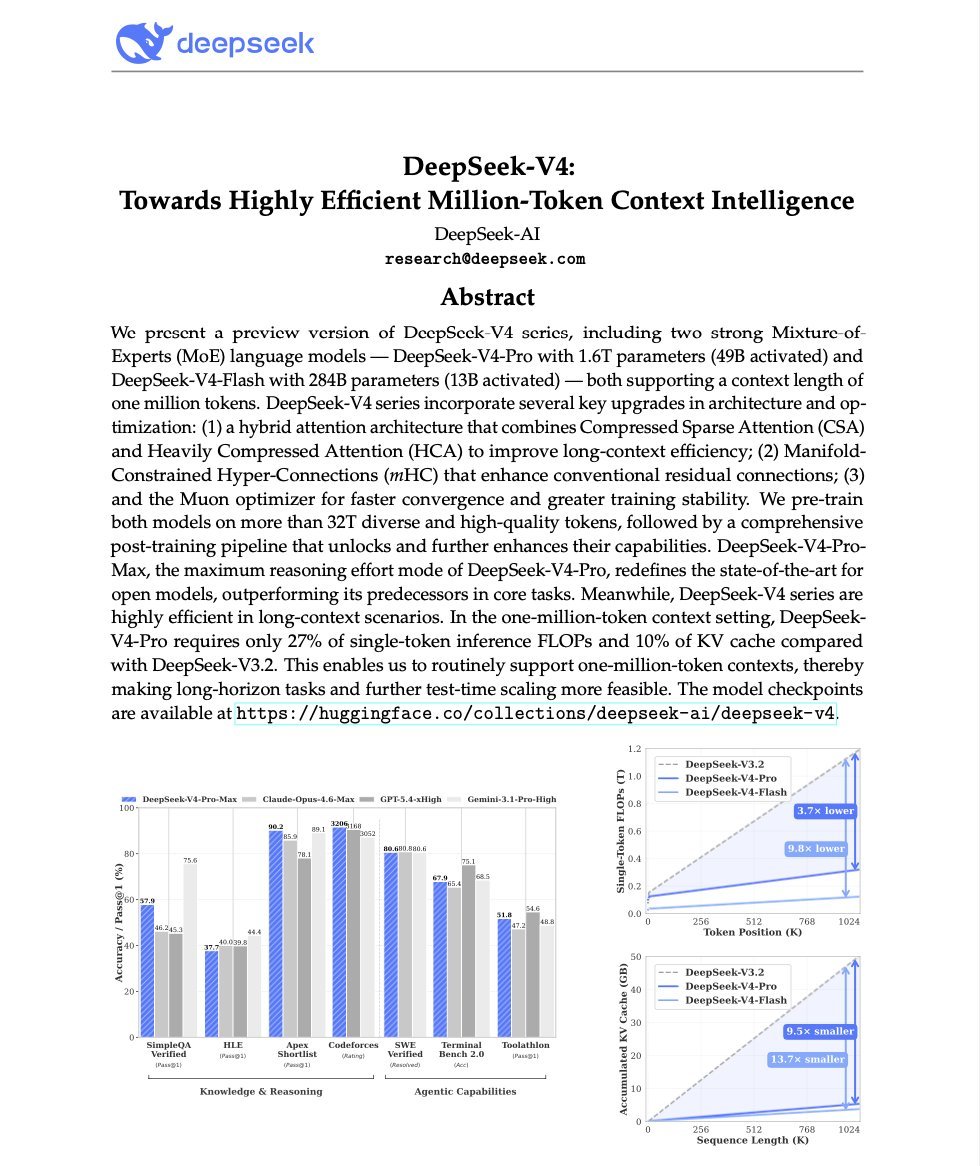
图 4 采用结构级压缩注意力机制原生缩减 KV Cache 体积
该类方案通常采用两类压缩注意力的混合架构:
- CSA(压缩稀疏注意力,Compressed Sparse Attention) :通过 Softmax 门控池化将 KV 状态压缩 4 倍,并在压缩后的 Token 上施加稀疏注意力;
- HCA(高压缩注意力,Heavily Compressed Attention) :更为激进,将连续 128 个 Token 的 KV 状态聚合成单个压缩表征,在此之上执行密集注意力计算。
在 1M 上下文长序列下,采用该架构的单 Token 推理 FLOPs 仅需 27%,而 KV Cache 占用仅为传统架构的 10%。单序列 KV Cache 从 83.9 GiB 锐减至 9.62 GiB(BF16 精度)。若进一步叠加 FP4/FP8 量化,显存占用还可再降低一半。
KV Cache 已经成为当前大模型架构演进中最核心的约束条件。
7. 权重量化
模型训练时必须依赖 FP32 或 BF16 保证梯度数值稳定性,但在推理阶段则完全不需要如此高的数值位宽。位宽压缩带来的显存收益严格呈线性比例:
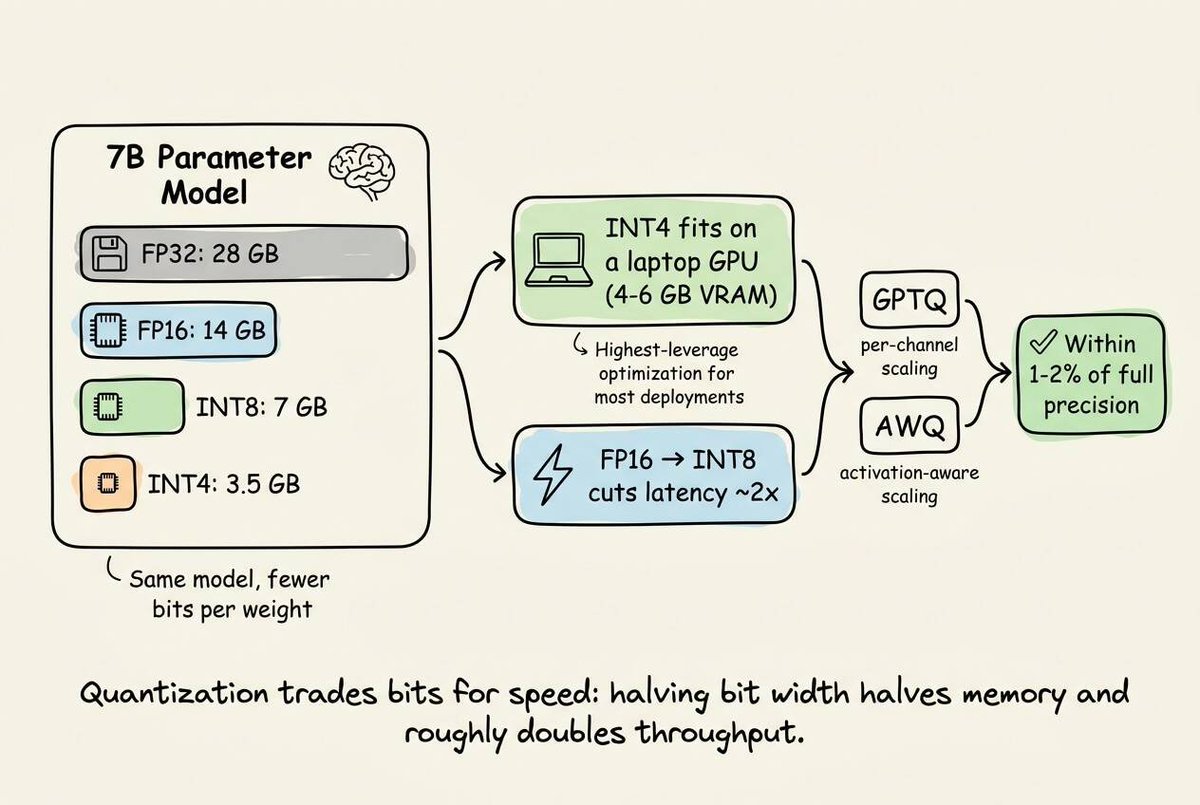
图 5 7B 参数量模型在不同精度下的显存占用对比
| 精度格式 | 单参数位宽 | 7B 模型显存占用 | 适用场景 |
|---|---|---|---|
| FP32 | 32-bit (4 Bytes) | 28 GB | 模型预训练与全精度基准校验 |
| FP16 / BF16 | 16-bit (2 Bytes) | 14 GB | 标准微调与数据中心级原生部署 |
| INT8 | 8-bit (1 Byte) | 7 GB | 主流服务端高性价比部署(几乎无损) |
| INT4 | 4-bit (0.5 Byte) | 3.5 GB | 端侧/笔记本 4~6GB 显存设备轻量运行 |
现代量化方案(如 GPTQ、AWQ)引入逐通道缩放因子(Per-channel Scaling Factors),将有损压缩带来的准确率下降控制到极低。高质量的 INT4 模型在主流基准测试上与全精度模型差距通常仅在 1%~2% 以内。从 FP16 转为 INT8 通常可在基本无损的前提下使推理延迟减半,是部署中 收益率最高的优化手段 。
8. 推理服务架构
现代推理服务框架(如 vLLM、TensorRT-LLM、TGI)围绕 Prefill-Decode 循环,引入了多项关键工程优化:
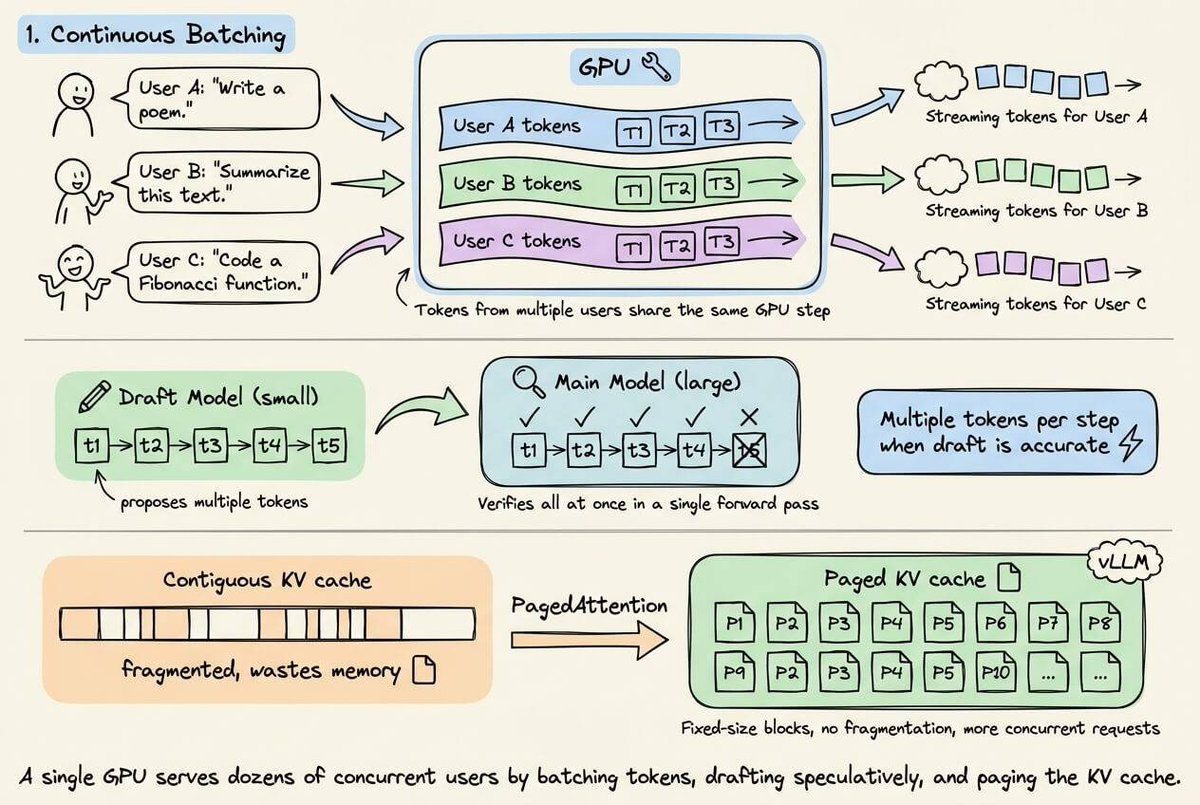
图 6 连续批处理(Continuous Batching)在同一个计算调度步内交织不同请求的 Token
- 连续批处理(Continuous Batching) :在同一个 GPU 调度步内交叉执行多个请求的不同 Token,在访存受限的 Decode 阶段充分利用空闲算力。
- 推测解码(Speculative Decoding) :利用轻量小草稿模型先行投机生成多个候选 Token,再交由大模型单次前向并行校验。当命中率高时,可将多次串行 Decode 转化为单次并行验证。
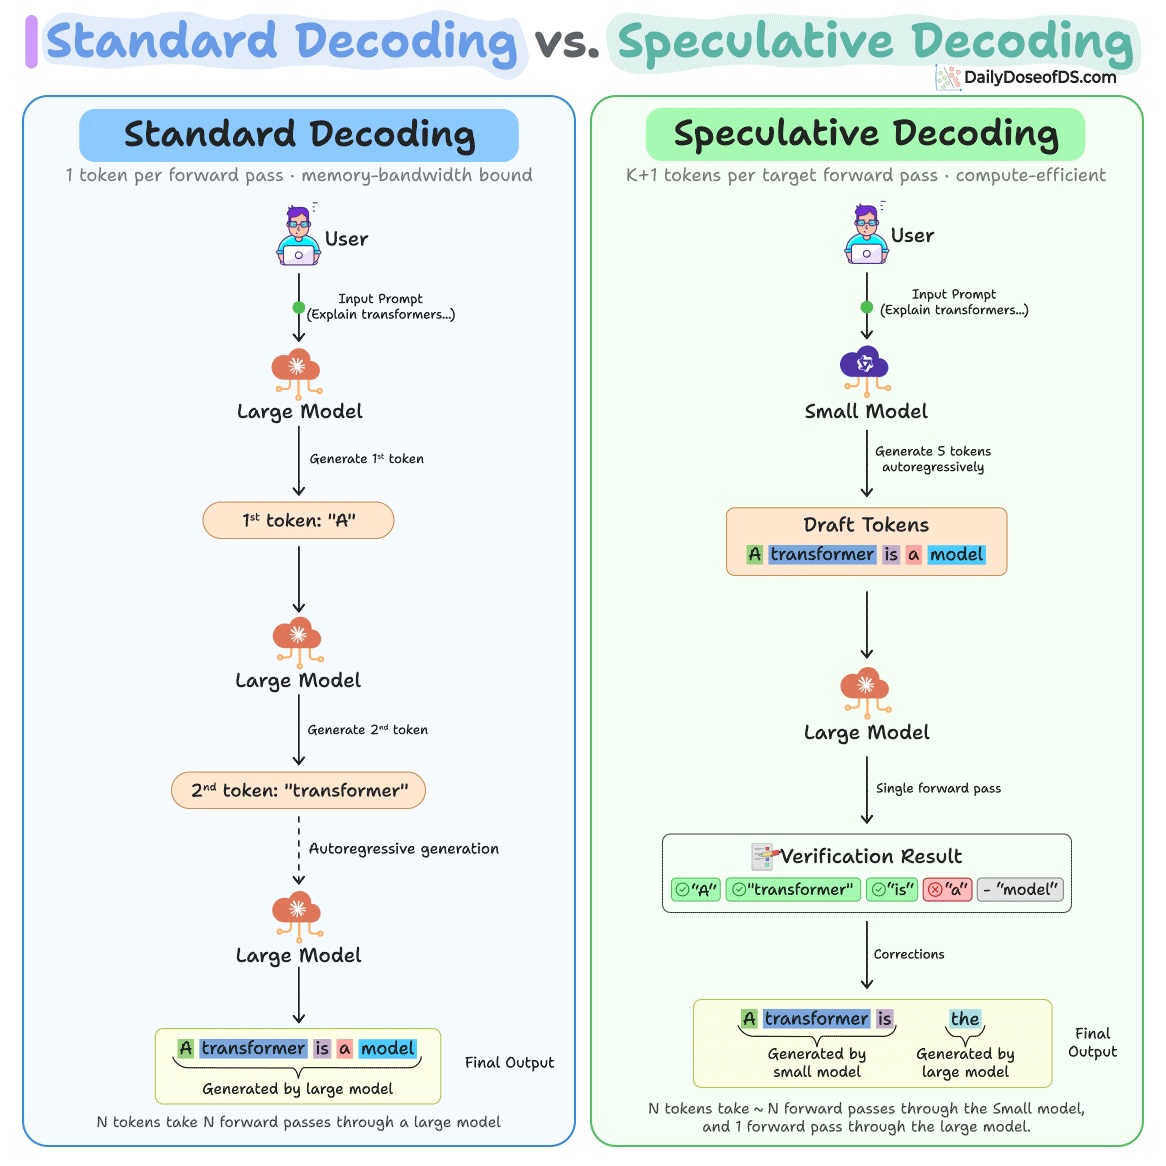
图 7 推测解码:小模型快速生成候选项,大模型单次批量并行验证
- PagedAttention :以固定大小的虚拟内存块管理 KV Cache,消除碎片,使得单卡并发请求容量大幅扩充。
上述技术使单张 GPU 能够轻松服务数十个并发用户:Decode 阶段让大量算术计算单元闲置,而 Continuous Batching 恰好将其他请求的计算负载填入这些空闲空间中。
9. 完整推理链路流程梳理
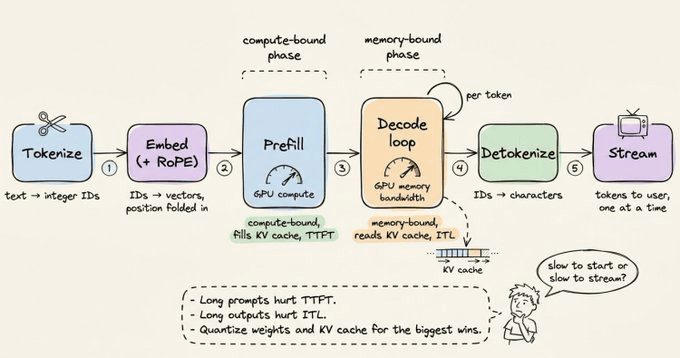
图 8 大语言模型端到端推理数据链路完整示意图
- Tokenize(分词) :文本通过 BPE 转换为整型 Token ID 序列。
- Embed(向量嵌入) :Token ID 查表转为连续向量,RoPE 注入旋转位置特征。
- Prefill(预填充) :一次性并行穿过所有网络层,计算受限,构建初始 KV Cache 并产出首个 Token。
- Decode 循环(自回归解码) :单步迭代:为新 Token 投影 Q 向量,在缓存的 K/V 上做注意力,经过 FFN 与采样,将最新 K/V 写入 Cache。访存受限。
- Detokenize(逆分词) :将生成的 Token ID 反查还原为文本字符并以流式方式返回。
10. 工程落地实践启示
- 长 Prompt 消耗 TTFT(Prefill 耗时) ; 长 Output 消耗 ITL(Decode 耗时) ,两者压迫完全不同的硬件单元。
- 上下文长度并不廉价 :它会急剧膨胀 KV Cache 并直接扼杀系统批处理并发能力。
- 警惕算力利用率陷阱 :满载服务时 GPU 计算单元利用率可能仍跌至 30%,因为真实瓶颈在显存带宽。盲目提升算力徒劳无功,加速显存、压缩 Cache 和改善批调度才是根治之道。
- 核心诊断法则 :当用户反馈模型缓慢时,第一步先判定是 响应首字慢(Prefill 受限,优化 TTFT) ,还是 流式输出慢(Decode 受限,优化 ITL) 。