 yuzheng
翻译与阅读笔记
Mooncake:以 KV Cache 为中心的解耦推理架构
围绕 Prefill / Decode 分离、分布式 KV Cache 存储池与请求调度的论文中文精读。
问题:如何让计算靠近可复用的 KV
长输入和共享前缀让 KV Cache 不再只是单次请求的临时状态,也成为集群调度需要考虑的数据。Mooncake 将 Prefill、Decode 和 KV 存储分开组织,让计算任务与已有缓存的位置共同决定请求的执行路径。
本文依据已有论文精读稿重新整理,围绕工作负载、架构、数据流和调度展开。实验数字保留原稿引用的语境;文末单独说明它与个人项目之间的联系和边界。
1. 工作负载:长输入与不均匀的缓存热度
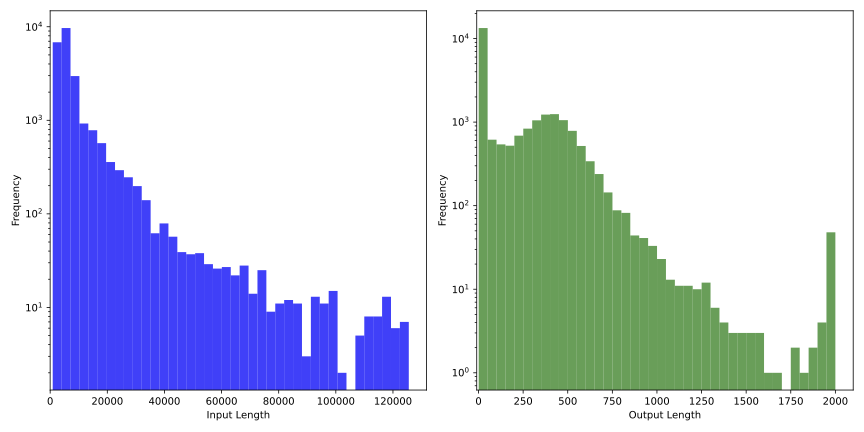
图 1:论文 Figure 4,展示输入与输出长度的分布。
精读稿记录的生产轨迹中,平均输入长度为 7,590 tokens ,平均输出长度为 182 tokens ,两者相差约 40 倍。这个比例提示我们关注输入处理成本,但不能直接换算为 Prefill 占用的 GPU 时间或 FLOPs 比例。
如果多个请求共享一段有效前缀,复用对应 KV 就有机会减少重复计算。问题在于,不同前缀的复用频率并不均匀。
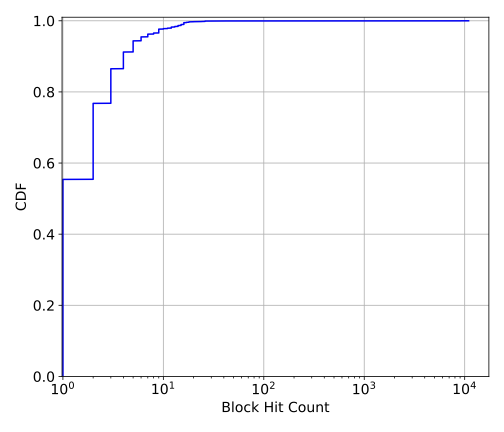
图 2:论文 Figure 5,展示缓存块的访问热度差异。
大量块只被访问少数几次;另一些共享文档或系统提示词却可能成为热点。把热点缓存固定在一个节点上,会将请求、数据传输和计算压力集中到该节点。因此,“是否命中”之外,还需要考虑“在哪里命中”以及“取到它需要多久”。
2. 为什么分开 Prefill 与 Decode
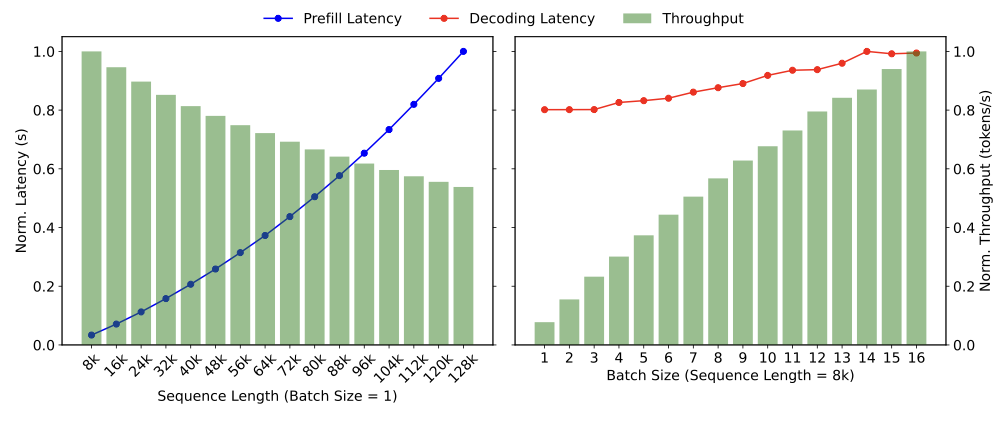
图 3:论文 Figure 2,比较两阶段在测试设置下的性能特征。
Prefill 一次处理多个输入 token,通常具有较高的计算密度;Decode 则逐步产生输出,小批量时经常受内存带宽限制。实际瓶颈与模型、上下文和批大小有关,不能只凭阶段名称判断。
| 观察维度 | Prefill | Decode |
|---|---|---|
| 工作内容 | 处理输入并生成 KV | 利用已有 KV 逐步生成输出 |
| 常见性能关注点 | 输入规模与计算吞吐 | 权重、KV 的读取和批处理效率 |
| 用户侧延迟指标 | 首 token 延迟 TTFT | token 间延迟 TBT |
两者混部时,长 Prefill 可能打断 Decode 的执行节奏。分离部署可以独立配置资源和调度策略,但也引入 KV 传输与集群协调开销。Mooncake 的架构围绕这项取舍展开。
3. 架构:计算池与 KV 存储池
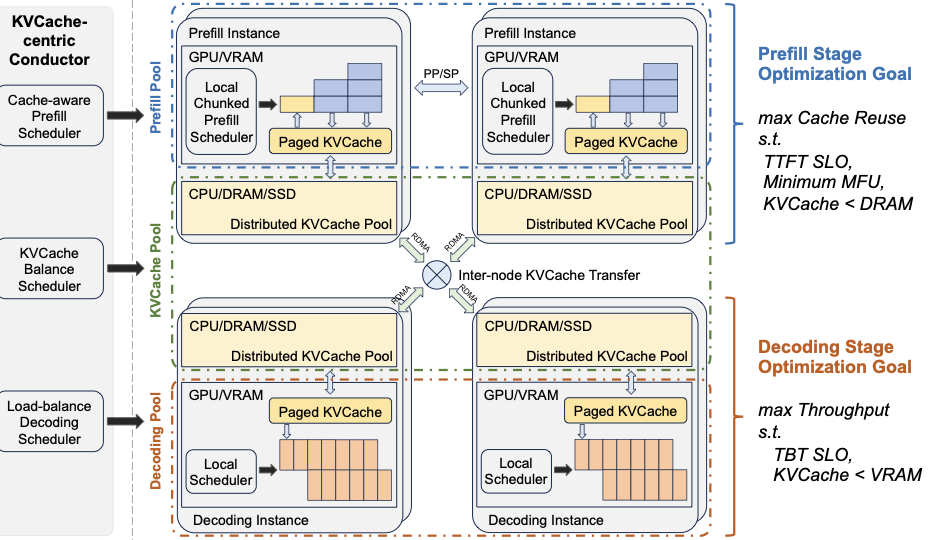
图 4:论文 Figure 1,展示调度器、Prefill / Decode 计算池与 KV 存储。
可以把系统按职责理解为四部分:
- 调度器 Conductor :综合缓存位置、可复用前缀、计算负载和延迟目标,为请求选择执行位置。
- Prefill 计算池 :处理尚未缓存的输入,生成后续 Decode 所需的 KV。
- Decode 计算池 :承接生成阶段,通过连续批处理推进活跃请求。
- KV 存储与传输组件 :组织分布式缓存,支持跨节点数据获取和层间传输。
这不是简单地把一个推理引擎拆成两台机器。缓存目录、状态有效性、传输和请求调度必须协同工作,才能让复用节省的计算超过额外的数据移动成本。
4. 数据流:复用、增量计算与传输重叠
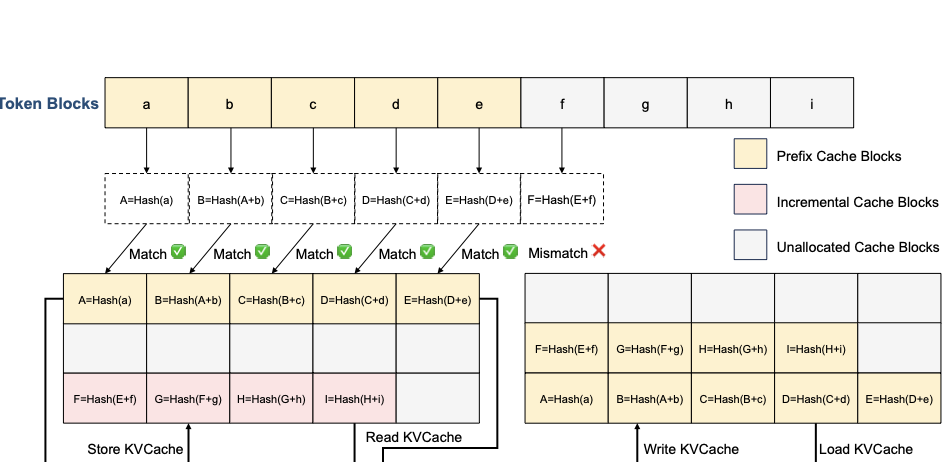
图 5:原精读稿保留的论文图,说明 KV 的存储与流转。
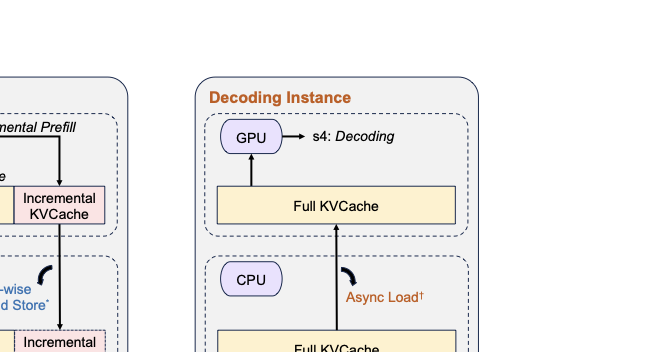
图 6:原精读稿保留的论文图,说明计算与数据传输之间的配合。
一个请求的处理过程可以概括为:先查找可用前缀,再获得对应 KV,随后计算缺失的输入部分,最后把完整状态交给 Decode。
- 查找与获取缓存 :调度器确认可复用的前缀及其位置,权衡本地计算与远端获取的代价。
- 增量 Prefill :对未缓存的 token 继续计算,而不是无条件重算整个输入。
- 分层传输 :尝试让已完成层的 KV 传输与后续层计算重叠。
- 进入 Decode :在所需状态就绪后加入生成调度。
传输重叠的效果取决于数据量、网络带宽和各阶段的依赖,不能把“可以重叠”理解为传输开销总能被完全隐藏。
5. 调度:命中更长的前缀不一定更快
缓存命中长度是重要信号,但它不是唯一目标。一个拥有长前缀的节点如果已经排满队,可能比另一个需要多算一些 token 的节点更慢。
下面是帮助理解取舍的简化成本分解,不是论文算法的逐行复现:
这几项分别对应数据传输、排队与剩余输入计算。真实执行中还可能存在重叠和额外开销,因此应将它作为分析框架,而不是精确计时公式。
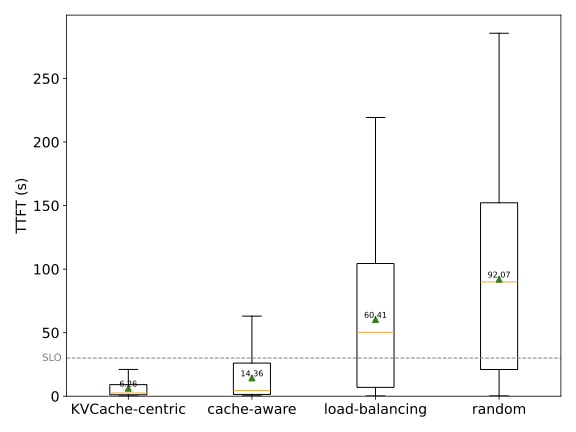
图 7:论文 Figure 7,比较负载与缓存感知策略。
热点迁移也可以从这个角度理解:当持有热点缓存的节点排队过长时,将部分请求转移到其他节点,并通过传输或计算形成新的副本,可能改善整体等待时间。它仍然需要付出复制和存储成本。
6. 实验:同时看吞吐与延迟约束
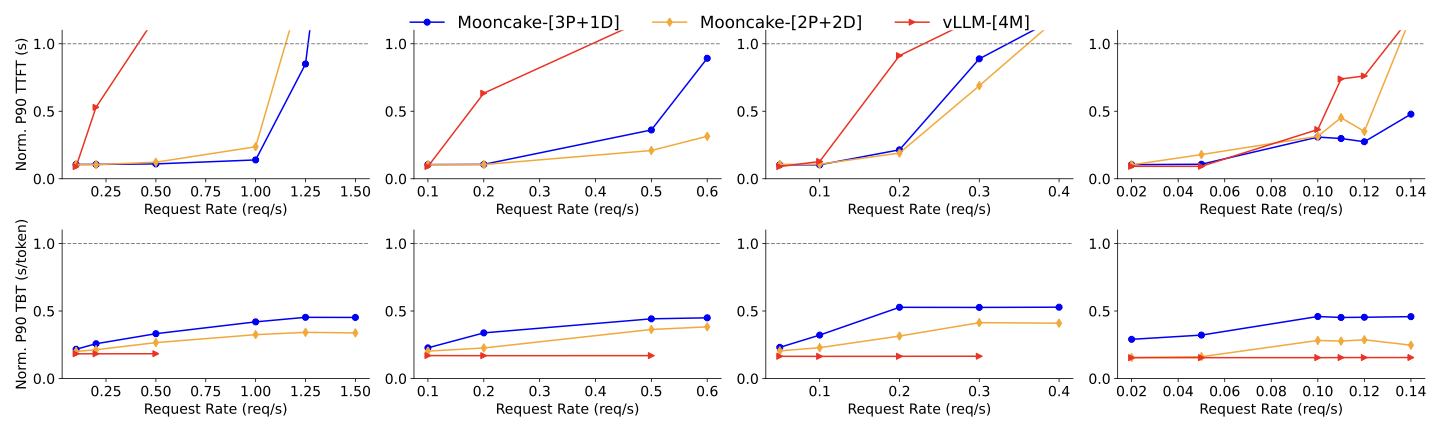
图 8:论文 Figure 9。重点指标是满足服务目标的有效吞吐,而不只是原始 token 吞吐。
已有精读稿记录,在 16k–128k 的长输入测试中,相对所比较的 vLLM 基线,吞吐提升范围为 50%–525% 。不同输入长度和请求速率对应不同结果,不应把这个范围视为对任何部署都成立的收益。
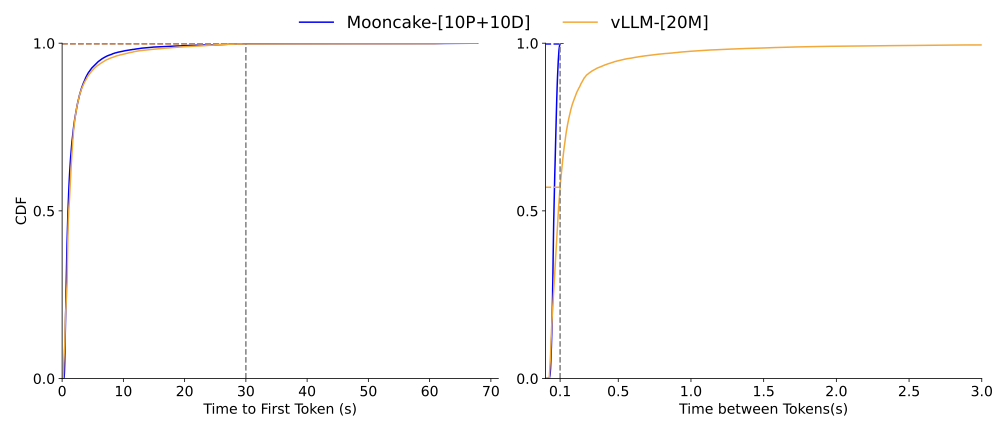
图 9:论文 Figure 10,比较真实轨迹回放中的延迟分布。
精读稿还记录了同等 20 卡资源下,Mooncake 的 10P+10D 与 vLLM 的 20M 配置比较:TTFT 达标率均接近 100%,TBT 达标率从基线的约 57% 提高到接近 100%;满足服务目标时,承载请求量提高约 75%。这些数字应结合论文的模型、硬件、请求轨迹和 SLO 定义阅读。
分离架构的价值不仅在于增加吞吐,也在于减少长输入对生成阶段的干扰。但在短输入、低并发或网络受限的环境中,仍需重新评估分离带来的成本。
7. 个人思考:缓存生命周期是共同问题
以下是个人理解,不属于论文原文。
Mooncake 提醒我,把 KV 当作能够复用的数据之后,系统就需要明确它的身份、有效范围、位置、保留时间和回收规则。只保存数据而不管理生命周期,不能保证后续请求一定能够复用。
Qwen3 Runtime 关注单 GPU Agentic Rollout 中的会话状态保存、前缀校验与增量恢复。它与 Mooncake 有缓存生命周期上的联系,但没有因此具备论文中的分布式存储池、集群调度或对应的实验收益。
具体实现与实验边界见 Qwen3 Runtime 项目记录。