 yuzheng
翻译与阅读笔记
Ultra-Scale Playbook:在 GPU 集群上训练大语言模型
覆盖显存核算、数据并行、张量并行、流水线并行、上下文并行与 GPU 性能分析。
先明确瓶颈,再选择并行方式
将训练扩展到多张 GPU,并不只是把模型切成几份。参数、梯度、优化器状态和激活值占用不同类型的显存;每一种切分方式又引入不同的通信与同步开销。
本文依据 Ultra-Scale Playbook 的中文译稿整理,从单卡显存预算出发,依次讨论数据、张量、上下文、流水线和专家并行,最后回到配置选择与算子优化。阅读重点是各方案节省了什么、增加了什么,以及它们适合什么样的硬件和工作负载。
阅读方式与配套资料
本书建立在以下三大坚实支柱之上:
1. 直观清晰的理论与概念拆解
在直接深入复杂代码和分布式实验之前,我们希望你先从高层视角透彻理解每种方法的工作原理、核心优势与物理边界。 例如:你将掌握语言模型的哪些组成部分在疯狂吞噬显存?这些显存消耗分别发生在训练的哪一个具体阶段?你还将理解如何通过模型并行绕过单卡显存墙,以及如何通过扩展 GPU 数量来提升系统吞吐。
除了理论计算分解之外,我们还配套开源了 显存预测专用工具 ,帮助工程师在开机前快速估算训练各阶段显存峰值:
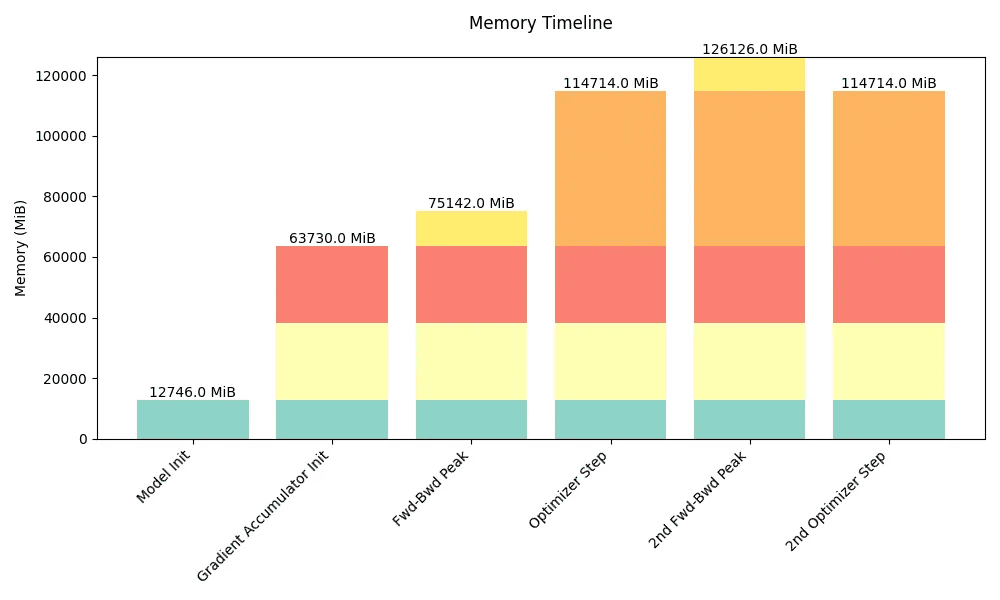
▲ 点击访问配套开源工具:Hugging Face 在线大模型训练显存预测器 (Predict Memory Tool)
2. 结构明晰的代码实现
理论是一回事,但在动手落地实现时,你会遇到各种工程边界情况和难以预料的细节陷阱。因此,我们在书中尽可能附上了代码实现索引。依据场景不同,我们分别提供了两个层次的参考代码库:
- Picotron :专为 教学与理解设计 的极简代码库。它通常将核心并行概念浓缩在单文件、短小且自包含的代码中,便于学习和隔离剖析。
- Nanotron :面向 工业生产级训练 的代码库,是 Hugging Face 内部实际用于预训练大模型的分布式代码底座。
🎥 视频课程参考
如果你更习惯通过视频来学习分布式训练,可以观看核心作者 Ferdinand 的 YouTube 分布式训练系列视频专栏。
3. 真实的训练效率基准测试
在现实中,大模型分布式训练究竟该如何选型扩展,极大地取决于你的 底层基础设施 (例如 GPU 芯片类型、网卡互联带宽与拓扑结构等),业界绝不存在一套放之四海而皆准的“万能模板”。
我们为你提供的不是生搬硬套的固定配方,而是一套 科学评测与配置选型的方法论 。我们在真实的超算集群上完成了 超过 4,100 次分布式训练实验 (算上调试运行累计超过 16,000 次),最高扩展至 512 张 GPU ,对海量模型尺寸与分布式并行拓扑进行了全景扫描与基准评测。
1. 高层概览
本书所涵盖的所有技术,本质上都是在解决以下 三大核心挑战 中的一个或多个。在后续的所有章节中,你会反复与它们正面交锋:
分布式大模型训练的「核心不可能三角」
- 显存占用(Memory usage) :这是最严苛的 物理硬限制 ——如果单个训练步(包含权重、梯度、优化器状态和激活值)无法完整放入 GPU 显存,训练就会因 CUDA OOM (Out Of Memory) 而直接中断崩溃。
- 计算效率(Compute efficiency) :我们希望昂贵的硬件算力核心(Tensor Cores)绝大部分时间都在进行高强度的有效矩阵乘法计算,因此必须竭尽全力减少数据在显存层级间无效搬运的时间,并消减等待其他卡执行完同步的空转气泡。
- 通信开销(Communication overhead) :通信会阻塞计算流水线,导致 GPU 陷入闲置等待。为了克服这一瓶颈,我们必须精准调度通信流量:充分榨干 节点内极高带宽通道(如 NVLink) 与 节点间相对较慢的集群网络(如 InfiniBand / RoCE) ;同时通过异步非阻塞机制,将 卡间通信与内核计算最大限度地重叠(Overlap) 。
在接下来的各个章节中,你会清晰地看到: 我们经常需要在这三者(计算、通信、显存)之间进行权衡与置换(Trade-offs) :
- 通过 激活值重计算(Recomputation) ,我们可以牺牲约 33% 额外的浮点计算量来大幅节省显存;
- 通过 张量并行(Tensor Parallelism) 或 ZeRO 显存切分 ,我们通过增加高速通信开销来打破单卡的显存壁垒;
- 通过 异步通信重叠(Async Overlap) ,我们让计算引擎和通信引擎同时运转,尝试用计算覆盖通信,能隐藏多少取决于二者的时长和依赖。
超大规模分布式训练全景速查思维导图
鉴于全书涵盖的技术跨度非常广阔,作者团队专门精心绘制了一份 全景速查思维导图(Cheatsheet) ,将各大分布式并行方案的核心逻辑、显存切分方式、通信模式与选型原则浓缩在一张图中。
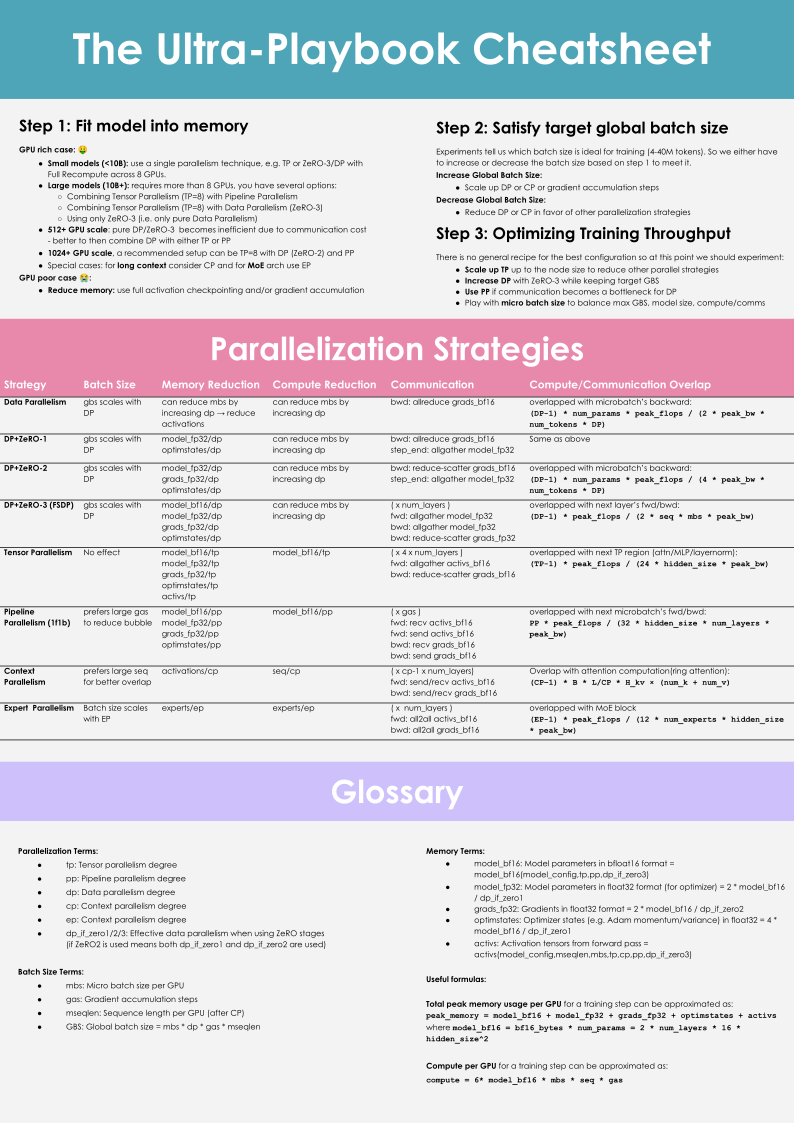
▲ 点击上方图片或 点击此处打开官方高清矢量原图(SVG 格式)。建议右键保存随身查阅。
全景速查核心技术矩阵
| 技术方案 | 核心解决矛盾 | 单卡显存影响 | 卡间通信特征 | 物理网络拓扑建议 |
|---|---|---|---|---|
| 单卡基础优化 (重计算 + 梯度累积) | 单卡显存不足、单步 Batch 偏小 | 重计算大幅降低激活值;梯度累积不增加模型状态 | 无跨卡通信 | 单卡内部层级访存 |
| 数据并行 (DDP) | 横向扩展样本吞吐量 (GBS) | 各卡保留完整模型参数、梯度与优化器副本 | 反向传播时梯度 AllReduce | 节点内或跨节点(对延迟容忍度较高) |
| ZeRO-1 / 2 | 消除数据并行中的模型状态冗余 | ZeRO-1 切分优化器状态(降至 4P+12P/N);ZeRO-2 增加梯度切分 | 通过 ReduceScatter 替代部分通信,通信量与 DDP 相同 | 节点内或跨高带宽网络 |
| ZeRO-3 (FSDP) | 模型参数完全无法放入单卡 | 模型参数、梯度、优化器全部被 张卡等分,显存降至 | 前向/反向均需 AllGather 权重,通信量增至 DDP | 依赖高带宽互联网络 |
| 张量并行 (TP) | 单个矩阵乘法权重太大超出单卡 | 权重与激活值按列/行切分为 | 每层 Transformer 产生 4 次高频 AllReduce | 严格限制在节点内 NVLink |
| 序列并行 (SP) | 消除 TP 遗留的 LayerNorm/Dropout 激活副本 | LayerNorm 与 Dropout 的激活值进一步切分至 | 将 AllReduce 替换为 ReduceScatter + AllGather | 节点内 NVLink |
| 上下文并行 (CP) | 长文本(32K~1M)激活值爆炸 | 激活值显存沿序列维度降为 | Ring Attention 环状传递 Key/Value 块 | 优先节点内,或高速跨机网络 |
| 流水线并行 (PP) | 网络层数过多,单卡装不下 | 各 GPU 仅存储本 Stage 所包含的若干层参数 | 相邻阶段之间点对点(P2P)传递微批次激活与梯度 | 跨节点通信最佳搭档 |
| 专家并行 (EP) | MoE 混合专家稀疏超大参数扩展 | 专家权重分摊到各个卡上,显存大幅降低 | Token 路由与汇总需 2 次 All-to-All | 针对集群拓扑定制分发路由 |
| 5D 复合并行 | 千卡/万卡超大集群极限扩展 | 综合压缩显存: | 分层网络映射:高频通信走 NVLink,低频粗粒度通信走跨机网络 | 拓扑感知多层次混合映射 |
2. 初入篇:单 GPU 训练
在迈入千卡集群的宏大世界之前,我们必须首先在微观层面上彻底搞清楚: 单张 GPU 上究竟在发生什么? 训练一个 Transformer 大语言模型时,显存是如何一步步被消耗殆尽的?在算力与显存之间,单机又存在哪些核心杠杆?
2.1 Transformer 显存消耗构成
在深度学习训练过程中,单张 GPU 的显存占用主要由两大核心部分组成: 静态的模型状态(Model States) 与 动态的剩余显存开销(Residual & Activation States) 。
显存 Profiling 机制与 PyTorch 内存池
在排查显存问题时,首先要区分 PyTorch 中的两个关键指标:
torch.cuda.memory_allocated():PyTorch 当前张量实际占用的物理显存量。torch.cuda.memory_reserved():PyTorch 的 Caching Allocator 从操作系统预先向 GPU 申请并保留的显存池总量。
PyTorch 为了避免频繁调用昂贵的底层 cudaMalloc 和 cudaFree,设计了内存池机制。当大量小张量频繁分配和释放时,可能会造成 显存碎片化(Memory Fragmentation) ,导致即使 memory_allocated 远低于显存上限,程序依然会因为找不到连续内存块而抛出 OOM 异常。
权重、梯度与优化器状态(静态显存)
设模型参数量为 。在标准的混合精度(如 BF16/FP16 + AdamW)训练下,模型静态状态的显存占用如下:
-
模型权重(Parameters) :采用 16-bit 浮点数(FP16 或 BF16),每个参数占用 2 字节:
-
梯度(Gradients) :反向传播计算所得的梯度同样为 16-bit 浮点数,每个梯度占用 2 字节:
-
优化器状态(Optimizer States - AdamW) : AdamW 算法为了维持高数值稳定性,通常在 FP32 精度下维护状态:
- FP32 权重的主副本(Master Weights): 字节
- 一阶动量(Momentum): 字节
- 二阶方差(Variance): 字节
优化器状态合计占用 字节。
关键数字法则:16P 模型状态法则
在标准混合精度 AdamW 训练中, 模型状态总共需要 字节 的显存。
例如,一个 7B (70 亿参数) 的模型:
这意味着哪怕单张显卡只放模型自身的状态(不计算任何输入和激活值),一块拥有 80GB 显存的 A100/H100 GPU 也根本无法装下。这正是分布式模型并行的根本原因。
激活值显存(动态显存)
激活值(Activations)是指在前向传播过程中计算得到,并必须保存在显存中以便在反向传播时用来计算梯度的所有中间张量。 对于一个典型的 Transformer Block(包含 Self-Attention 与 MLP),激活值的显存消耗主要取决于 批大小(Batch Size, ) 、 序列长度(Sequence Length, ) 、 隐藏层维度(Hidden Size, ) 以及 注意力头数(Heads, ) :
| 网络模块 | 中间激活张量 | 单层激活值显存 (Bytes, 假设 16-bit) |
|---|---|---|
| Self-Attention 模块 | Q, K, V 投影输入与输出;注意力矩阵 ;Softmax 概率矩阵;Attention Context 输出与 Out-Proj | |
| MLP / FFN 模块 | LayerNorm 输入;Gate 投影与 Up 投影;激活函数(如 SwiGLU/GELU);Down 投影输入 | (以 SwiGLU 为例,包含 3 个线性层) |
当序列长度 较短时, 项占据主导;但一旦序列长度扩展至 8K、32K 乃至 128K, 注意力矩阵项将呈二次方增长,迅速反超静态模型状态,成为吞噬显存的头号杀手。
2.2 激活值重计算
为了破解激活值对显存的霸占, 激活值重计算(Activation Recomputation / 激活检查点) 成为了大模型训练的标准配置。
核心思想:以算力换显存 (Trade Compute for Memory)
在前向传播时,我们 不再保存每一层的全部中间激活值 ,而只保留每个 Transformer Block 边界处的关键张量(Checkpoint)。 在反向传播进行到该层时,GPU 重新执行一次局部的局部前向计算 ,当场重新生成该层反向求导所需的激活值,并在梯度计算完毕后立即丢弃。
- 全量重计算(Full Recomputation) :每个 Transformer 层只存输入,内部全部重算。激活值显存大幅降低至仅与单层相关,但需要额外增加约 33% 的前向 FLOPs 计算开销 。
- 选择性重计算(Selective Recomputation) :由于 FlashAttention 等新算子在 SRAM 内部通过 Online Softmax 在线计算注意力且反向重算极快,业界(如 Megatron-LM)通常采用选择性重计算:仅对显存占用巨大但计算量小的操作(如 Attention Softmax、Dropout 等)进行重算,而保留计算昂贵的矩阵乘法(GEMM)激活值。
2.3 梯度累积
在单卡显存受限的情况下,直接使用大批次输入会立即导致 OOM。然而,大语言模型的稳定收敛通常需要极大的全局批大小(Global Batch Size, 如数百万 Token)。
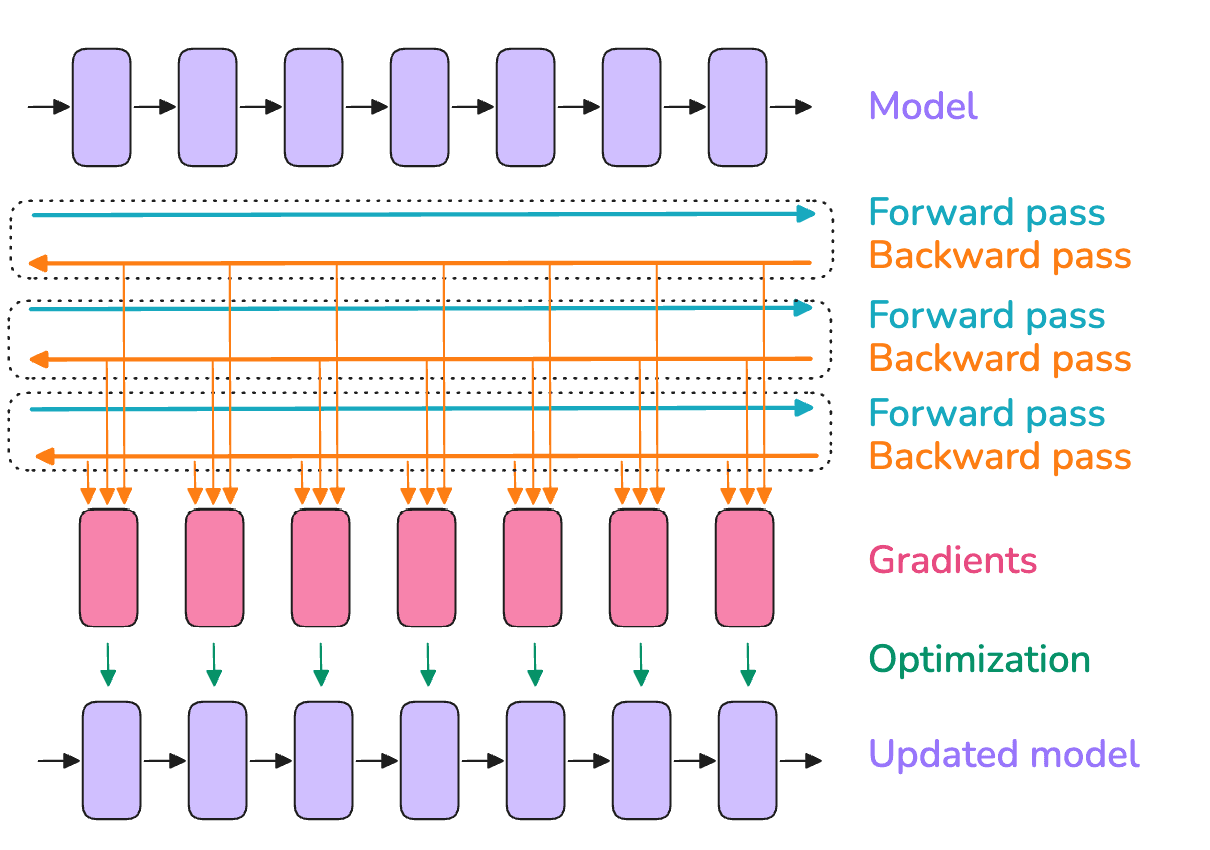
▲ 梯度累积:将大批次切分为多个微批次(Micro-batches),多次前向与反向累加梯度,最后统一更新参数
梯度累积(Gradient Accumulation) 将一个目标批次切分为 个微批次(Micro-batch Size, )。对每个微批次分别执行前向与反向传播,将计算出的梯度在显存中不断原地累加(grad += micro_grad),在累计达到 次之后,才执行一次 optimizer.step() 和 optimizer.zero_grad():
核心优势 :梯度累积 几乎不增加任何额外的模型状态显存 (因为梯度张量始终在原址累加),它成功将单步物理显存占用与全局有效 Batch Size 解耦。
3. 数据并行与 ZeRO 系列
当单卡通过重计算和微批次切分能够跑通单个微步后,扩展训练规模的第一直觉便是: 增加卡数,让每张卡分摊不同的训练样本——这便是数据并行(Data Parallelism, DP) 。
3.1 分布式数据并行 (DDP) 与三大核心重叠优化
在经典 PyTorch DDP 中,集群中的每一张 GPU 都拥有一份 完整的模型参数副本、梯度副本与优化器状态副本 。在每次迭代中:
- 各 GPU 加载不同的数据微批次,独立并行地执行前向传播并计算 Loss;
- 各 GPU 独立执行反向传播,计算出本地梯度;
- 各卡之间发起全局通信,通过 AllReduce 原语将所有 GPU 上的梯度进行求和平均;
- 各 GPU 使用平均后的全局梯度独立更新本地权重,保证所有卡上的参数在下一步开始前完全一致。
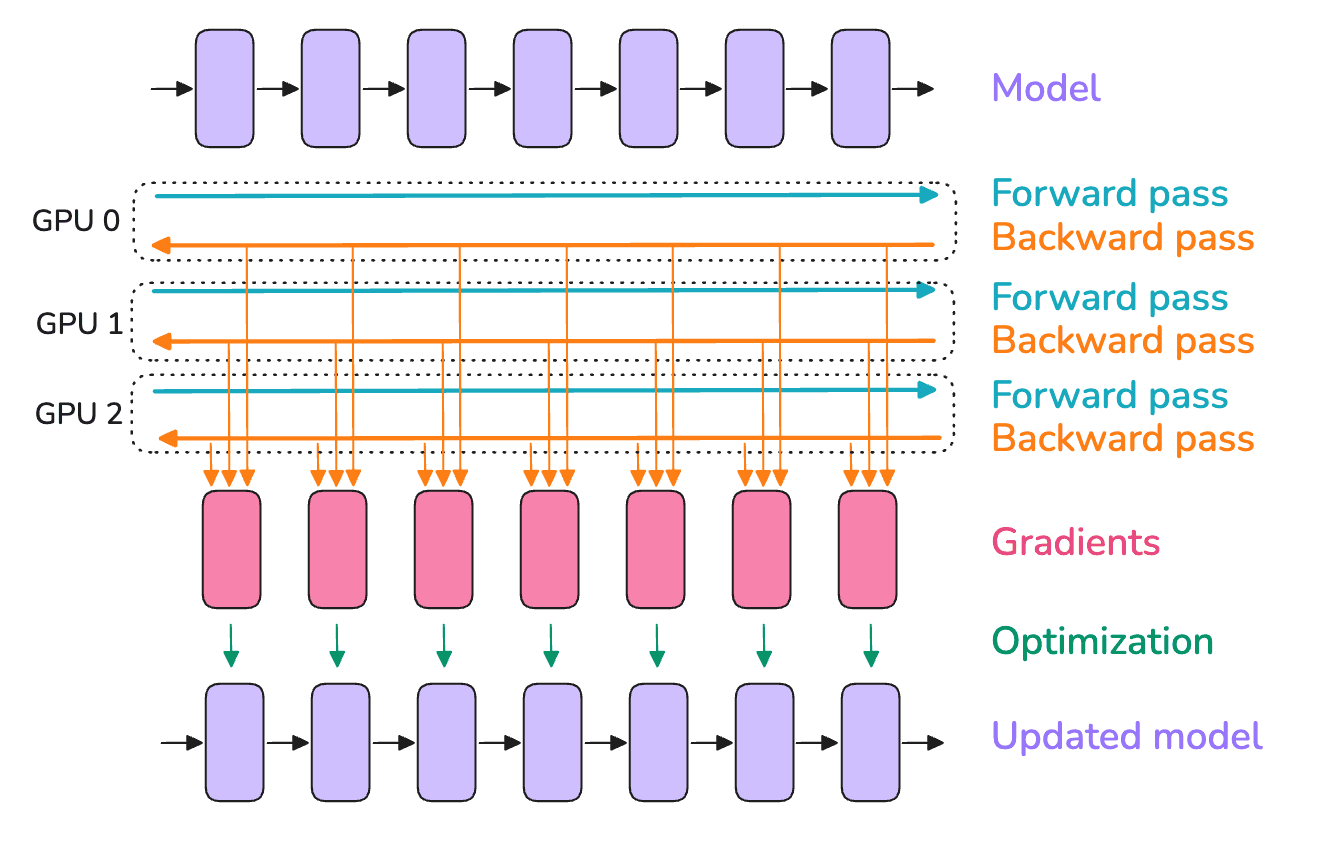
▲ 数据并行架构:多卡独立处理数据切片,反向传播后通过 AllReduce 保持模型参数强同步
DDP 的三大工程优化
如果等到反向传播完全结束才启动跨卡 AllReduce 通信,GPU 会陷入漫长的等待(卡间同步气泡)。现代高效 DDP 实现了三项关键优化:
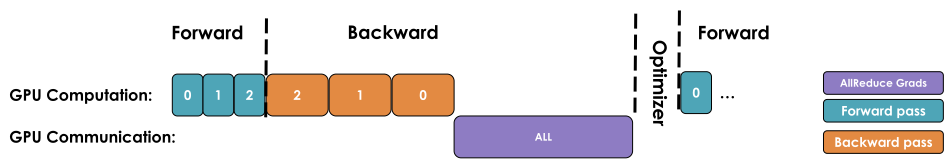
▲ 优化 1:反向传播与梯度通信的完全异步重叠(Overlap)。反向计算由顶层向底层推进,只要一层的梯度计算完成,立即在后台异步通信流中发起 AllReduce。
- 优化 1:反向计算与梯度 AllReduce 通信重叠 : 反向传播是按照网络层从输出向输入逆向执行的。当最后一层的梯度计算完毕时,DDP 会立即在独立的后台 CUDA Stream 中发起该层的异步通信,此时计算引擎继续计算上一层的反向梯度。通信时间被大量隐藏在计算耗时阴影之下。
- 优化 2:梯度分桶机制(Bucketing) : 如果每算出一个细小的参数张量就发起一次独立的 AllReduce,通信开销将被底层网络传输的建立延迟(Base Latency)彻底击垮。DDP 引入了梯度分桶(默认大小约 25MB),把多层的微小梯度打包放入同一个连续内存 Bucket 中,当桶填满后才触发一次大块连续的 AllReduce,最大化跑满物理网络带宽。
- 优化 3:与梯度累积的协同(no_sync 上下文) : 在使用梯度累积时,前 个微批次根本不需要跨卡同步梯度。通过 PyTorch 提供的
with model.no_sync():上下文管理器,可以彻底关闭前序微批次的通信,仅在最后一个微步触发 AllReduce,消除不必要的网络风暴。
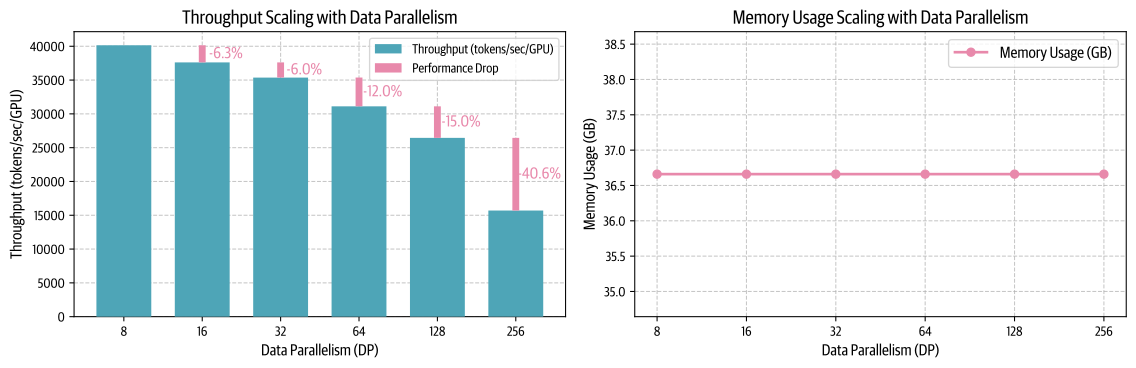
▲ 4100+ 真实基准测试中的数据并行扩展表现:在较小模型上,DDP 能展现出近乎线性的超强扩展效率
3.2 ZeRO:零冗余优化器
虽然 DDP 计算扩展效率极高,但它有一个致命弱点: 显存冗余极度严重 。每一张 GPU 都保存着完全相同的 16P 模型状态(权重 2P、梯度 2P、优化器 12P)。当模型膨胀到几十亿参数时,单卡显存甚至连静态参数都放不下。
微软 DeepSpeed 团队提出的 ZeRO(零冗余优化器) 以及 PyTorch 对应的 FSDP(Fully Sharded Data Parallel) ,彻底颠覆了数据并行的显存范式: 既然所有卡都需要协作,为什么不把这些模型状态打散平摊到各个 GPU 上,消除冗余?
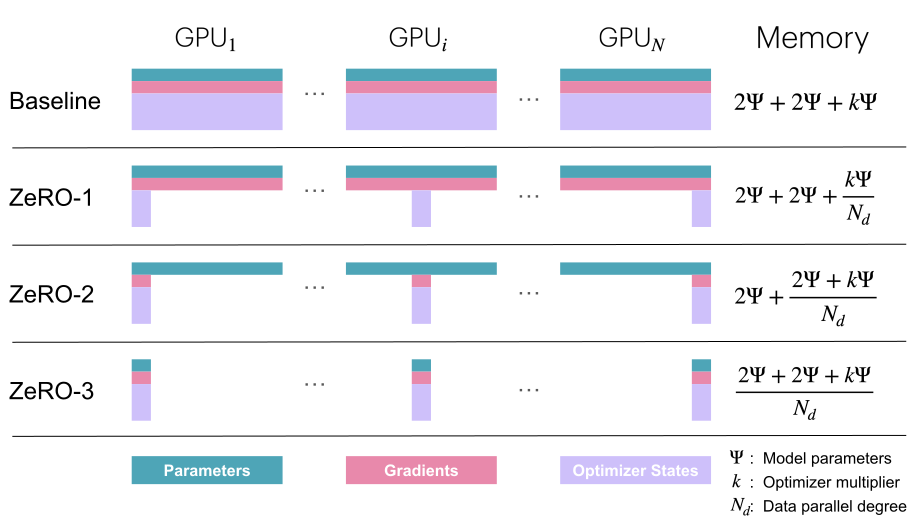
▲ ZeRO-1 / ZeRO-2 / ZeRO-3 显存切分全景对比:步步蚕食模型静态状态显存
ZeRO-1:优化器状态切分
-
核心机制 :将原本占用最大(12P 字节)的 AdamW 优化器状态,均匀切分到 张 GPU 上。每张卡只负责更新其中 的参数状态。
-
显存变化 :
单卡显存需求从 骤降至约 (节省近 4 倍显存。)。
-
通信开销 :完全不变。各卡梯度先通过
ReduceScatter汇聚到属主卡,属主卡更新后,通过AllGather把更新后的权重广播回所有卡。通信总量仍为 ,与经典 DDP 完全一致。
ZeRO-2:梯度切分
-
核心机制 :在 ZeRO-1 的基础上,进一步将梯度张量也进行切分。每张卡在反向传播时,只保留其负责更新的那 参数的梯度。
-
显存变化 :
单卡显存需求进一步削减至约 (节省近 8 倍显存。)。
-
通信开销 :依然保持为 。反向传播计算完毕后直接发起
ReduceScatter,只汇集对应分块的梯度,通信总量依然等于传统 DDP。
ZeRO-3 (FSDP):模型参数全切分
-
核心机制 :连那 2P 的模型权重也不再在各卡上完整常驻。每张卡只永久保存 的模型参数分片。
- 在前向传播计算到某一层时,该层发起 AllGather 通信从其他卡临时拉取完整的权重;
- 前向计算完成后, 立即释放临时权重 ,只保留激活值;
- 反向传播计算到该层时,再次发起 AllGather 重新拉取该层权重;
- 反向求导计算出梯度后,立即发起 ReduceScatter 将梯度回传给对应分片的属主卡,随后立即释放该层权重。
-
显存变化 :
模型静态显存随着 GPU 数量 严格线性递减。这使得训练万亿参数超大模型成为可能。
-
通信代价 : 因为在前向和反向中各额外增加了一次权重的
AllGather(每次传输 字节),通信总量从原来的 增加到了 (通信开销增加 50%)。
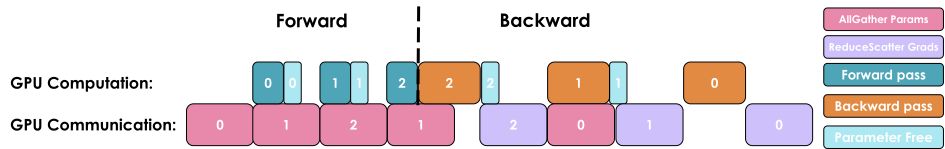
▲ ZeRO-3 / FSDP 的前向与反向通信计算重叠流水线:提前异步 Prefetch 下一层的参数,隐藏 AllGather 耗时
4. 张量并行与序列并行
当单个网络层的参数(例如拥有数万隐藏维度的线性投影层)庞大到哪怕经过 ZeRO 切分后依然在计算峰值时撑爆单卡显存,或者当我们需要降低单个样本的训练延迟时, 张量并行(Tensor Parallelism, TP) 便闪亮登场。
4.1 Transformer 块内的张量并行设计
NVIDIA 提出的 Megatron-LM 张量并行方案已成为现代大模型训练的工业事实标准。其核心精髓在于: 将线性变换(矩阵乘法 GEMM)内部的权重矩阵切分,并通过「列并行」与「行并行」的成对闭环设计,最大限度消减通信次数。
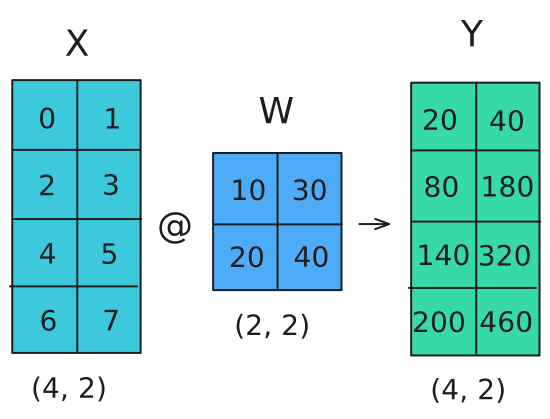
▲ Megatron-LM 经典张量并行切分:Self-Attention 与 MLP 均采用「列并行 + 行并行」结构,各仅需一次 AllReduce
1. 列并行线性层
设输入激活为 ,线性层权重为 。列并行将权重矩阵 沿着 列维度 均匀切分成 份:
输入张量 直接广播复用(各卡持完整 ),各卡独立执行局部矩阵乘法:
核心优势 :在得到输出 时, 根本不需要任何卡间通信 。输出结果直接作为后续逐元素激活函数(如 GELU、SwiGLU 或非线性操作)的输入,因为激活函数是 element-wise 的,具备天然的独立性:
2. 行并行线性层
列并行之后往往紧接着一个行并行线性层。行并行将权重矩阵 沿着 行维度 切分:
前一个列并行层输出的切分特征 正好与 的行数匹配。各卡执行局部矩阵乘法:
根据矩阵乘法的数学定义,全局最终输出是各卡局部结果的代数累加:
因此,只需在行并行输出后调用一次 AllReduce (Sum) 通信,所有 GPU 即可同步获得完整的输出张量 。
Transformer 层的成对优雅闭环
一个标准的 Transformer Block 可由两组「列并行 + 行并行」构成:
- Self-Attention 模块 : 投影采用 列并行 (多头注意力机制天然将 Head 平分到各卡),注意力计算在各卡局部独立执行;后续的 Output Projection 采用 行并行 ,最后执行 1 次 AllReduce 。
- MLP 模块 :Gate / Up 投影采用 列并行 ,无通信执行 SwiGLU 激活;Down 投影采用 行并行 ,最后执行 1 次 AllReduce 。
结论 :每个 Transformer Block 前向传播只需 2 次 AllReduce ,反向传播只需 2 次 AllReduce 。
张量并行的致命物理约束:严苛绑定 NVLink
由于 TP 的通信发生在 Transformer 的 每一层内部 ,且通信不完成就会彻底阻塞后续层的计算(属于同步前缀通信),因此 TP 产生了频繁的卡间通信。
黄金法则 :张量并行度 通常严苛限制在 单个机节点内部(通常 ) ,必须借助单机内部高达 900 GB/s 的 NVLink / NVSwitch 总线互联。一旦跨越网络交换机走 InfiniBand/RoCE,网络延迟将直接导致计算核心严重饥饿。
4.2 序列并行
在标准的张量并行中,研究人员发现了一个显著的痛点:虽然矩阵乘法(GEMM)被切分了,但 LayerNorm 和 Dropout 依然在所有 TP 卡上被完整复制执行 。 这意味着在 LayerNorm 和 Dropout 处,每张卡都必须维护一份完整序列长度的输入激活值,造成了显存浪费。
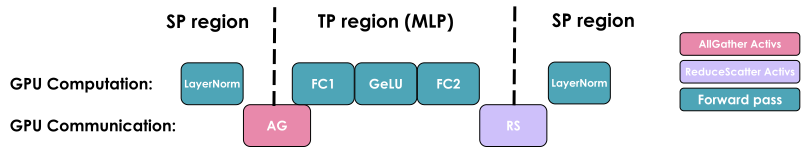
▲ 序列并行 (SP):在 LayerNorm 与 Dropout 处沿序列维度 切分为 ,用 ReduceScatter + AllGather 替代 AllReduce
Megatron-SP 提出了一种处理方式:
- 既然在行并行线性层输出后需要进行
AllReduce(实质为ReduceScatter+AllGather),我们何不 把这两步拆开 ? - 先执行 ReduceScatter :各个卡只获得属于自己的那一段序列切片(长度为 );
- 在 LayerNorm、Dropout 以及 Residual 处, 各个卡只计算自己负责的那 长度的序列 。显存开销直接降低为 ;
- 在进入下一个列并行线性层前,再执行一次 AllGather ,把序列拼回完整长度。
震撼结论 :通信数据总量 完全没有增加 (因为 ),但成功消除了 LayerNorm/Dropout 处的重复激活值, 将原本未切分的激活值显存彻底打散削减至 。
5. 上下文并行
在当今的大模型研发中,支持 32K、128K 乃至 1M 的超长上下文窗口已成标配。然而,随着序列长度 的拉长,激活值显存呈 二次方(甚至线性 FlashAttention 下也极为庞大) 爆炸:
此时,即便 加上序列并行,单机依然会瞬间因超长激活值而崩溃。 上下文并行(Context Parallelism, CP) 正是为了突破这一极限而诞生。
5.1 Ring Attention:环状通信注意力机制
UC Berkeley 提出的 Ring Attention 是上下文并行的核心理论基石。它将超长文本序列沿着 Sequence 维度切分成 块,均匀分布在参与上下文并行的 张 GPU 上:
每个 GPU 仅持有局部序列块 ,各块的序列长度为 。
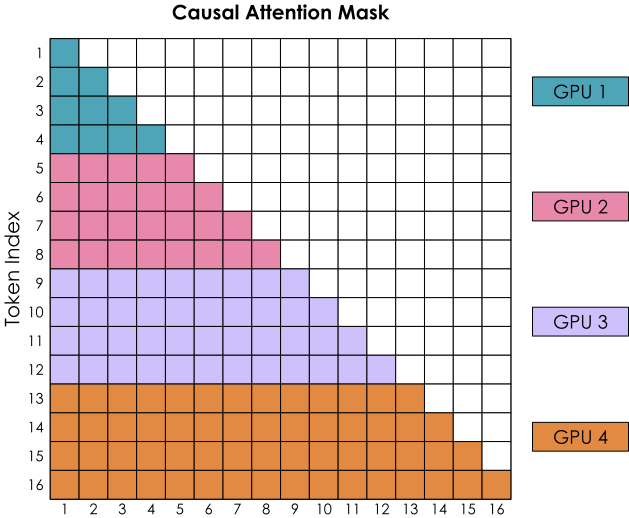
▲ 上下文并行注意力切分:将超长序列沿 Sequence 维度切分到各个 GPU
环状流水线双缓冲(Double Buffering Overlap)机制:
- 本地计算第一步 :GPU 使用自己本地的 与本地的 执行 FlashAttention 局部块计算;
- 环状传递(Ring Shift) :在计算的同时,GPU 通过非阻塞点对点通信(P2P
send/recv)将自身的 发送给下一个邻居 GPU ,同时接收上一个邻居 GPU 传过来的 ; - 增量在线累加 :借助 FlashAttention 著名的 Online Softmax 算法,每收到一块新的外部 ,立即在线动态修正归一化分母(Log-Sum-Exp),增量累加当前注意力输出;
- 在经过 步环状轮转后,所有 GPU 在不需要一次性容纳全局序列的情况下, 数学等价地完成了完整全局注意力的精确计算 。
5.2 Zig-Zag Ring Attention:负载均衡的高阶实现
在自回归因果语言模型(Causal LM)中,注意力矩阵受到下三角掩码(Causal Mask)的限制——后面的 Token 可以看前面的 Token,但前面的 Token 无法看后面的 Token。
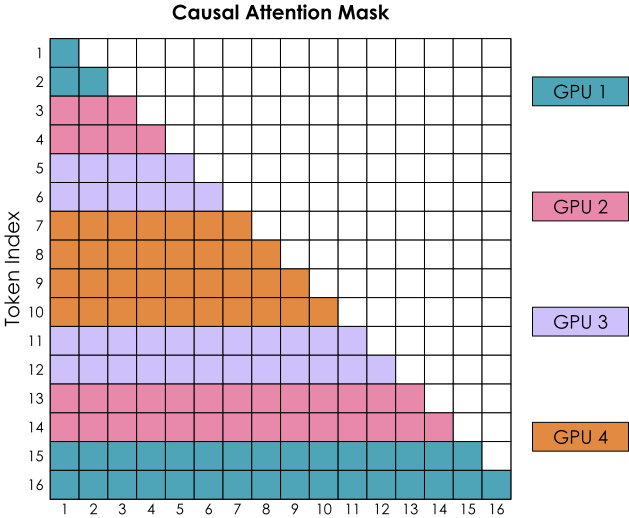
▲ Zig-Zag 锯齿切片重排:使处于不同环轮转阶段的 GPU 始终分摊均等的有效注意力计算面积
如果使用朴素的连续切片,排在前面的 GPU 会因为大量的无效 Mask 而无事可做,而后排 GPU 却算力拉满,产生严重的 算力负载失衡(Compute Imbalance) 。
Zig-Zag 锯齿切分算法 将输入序列进行前后折叠式的非均匀分块分配,使每个 GPU 分配到的有效下三角注意力面积几乎完全相等,在每一轮环传输中消除空转气泡,实现算力利用率的最大化。
6. 流水线并行
当模型的网络层数极深(如几十层甚至百层),且集群规模跨越成百上千个物理机柜时,我们无法在节点间使用对带宽要求较高的张量并行。此时, 流水线并行(Pipeline Parallelism, PP) 成为了跨节点切分模型的一种方案。
6.1 节点间层切分与经典调度机制
流水线并行将深度神经网络的 个层顺次切分为 个连续的阶段(Stages),每个 Stage 分配给集群中的不同 GPU 节点:
- Stage 0 负责第 层;Stage 1 负责第 层……以此类推。
- 巨大优势 :卡间通信仅发生在 Stage 边界,通信量 仅仅是微批次边界处的前向激活张量和反向梯度张量 ,通信量极小,非常适合跨越机架间的普通网络传输。
调度 1:AFAB (All Forward, All Backward) 的问题
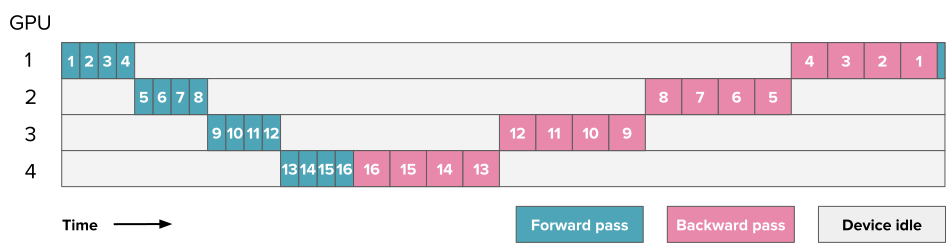
▲ AFAB 调度:先跑完所有微批次的前向,再跑所有微批次的反向,产生巨大的气泡与显存占用
在朴素的 AFAB 调度中,集群先连续执行所有微批次的前向传播,再逆向执行所有微批次的反向传播。 这带来两个严重后果:
- 流水线气泡巨大 :前排 GPU 在反向等待,后排 GPU 在前向等待,气泡率高达 (其中 为流水线段数, 为微批次总数);
- 激活值显存爆炸 :Stage 0 必须将所有 个微批次的激活值全部常驻显存,直到漫长的反向传播回来,极易瞬间 OOM。
调度 2:1F1B (One Forward, One Backward) 稳态调度
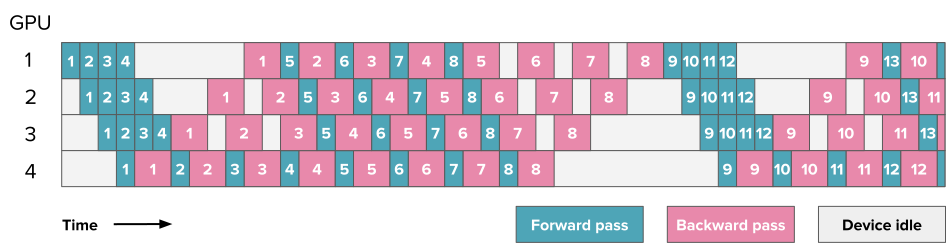
▲ 1F1B 调度机制:预热阶段后进入 1 前向 + 1 反向的稳定交替,成功将最大常驻激活值锁定在 个微批次内
PipeDream 提出的 1F1B 调度 是流水线并行的基石设计:
- 预热阶段(Warm-up) :Stage 0 连续启动若干个微批次的前向,直到流水线被充满;
- 稳态阶段(Steady State) :每个 Stage 严格 交替执行一个前向微批次和一个反向微批次 (1 Forward, 1 Backward)。每计算完一个反向微步,就立即释放该微批次的激活值,同时启动一个新的前向微步;
- 收尾阶段(Cool-down) :完成剩余反向微步的计算。
核心收益 :在整个稳态期间,任何阶段常驻显存的在途(In-flight)激活值微批次数量 严格被限制在 以内 ,彻底斩断了显存随总批次膨胀的风险。
6.2 交错式 1F1B 与 Llama 3.1 调度方案
标准 1F1B 的流水线空转气泡比例(Bubble Fraction)为:
当微批次数 不够大时,气泡比例仍然显著。为了进一步压缩气泡,Megatron-LM 提出了 交错式 1F1B(Interleaved 1F1B) :
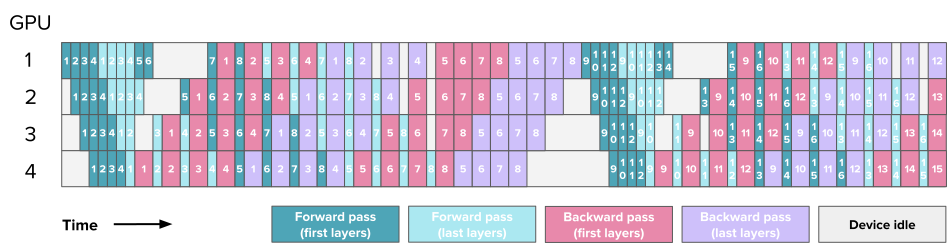
▲ 交错式 1F1B 调度:每张物理 GPU 承担多个虚拟阶段(Virtual Stages),将流水线气泡大幅缩小 倍
-
让每张物理 GPU 不仅负责 1 个 Stage,而是负责 个 虚拟阶段(Virtual Stages) 。例如 GPU 0 既负责 Stage 0(网络最底层),又负责 Stage 4(网络中层);
-
气泡比例被大幅稀释为:
-
代价值:每张物理 GPU 与邻居间的点对点通信次数增加了 倍。
6.3 Zero-Bubble 与 DualPipe:DeepSeek-V3 的流水线设计
流水线并行长期以来被认为不可避免地存在冷启动与收尾气泡。然而, Zero-Bubble PP 以及 DeepSeek-V3 提出的 DualPipe 调度打破了这一物理宿命。
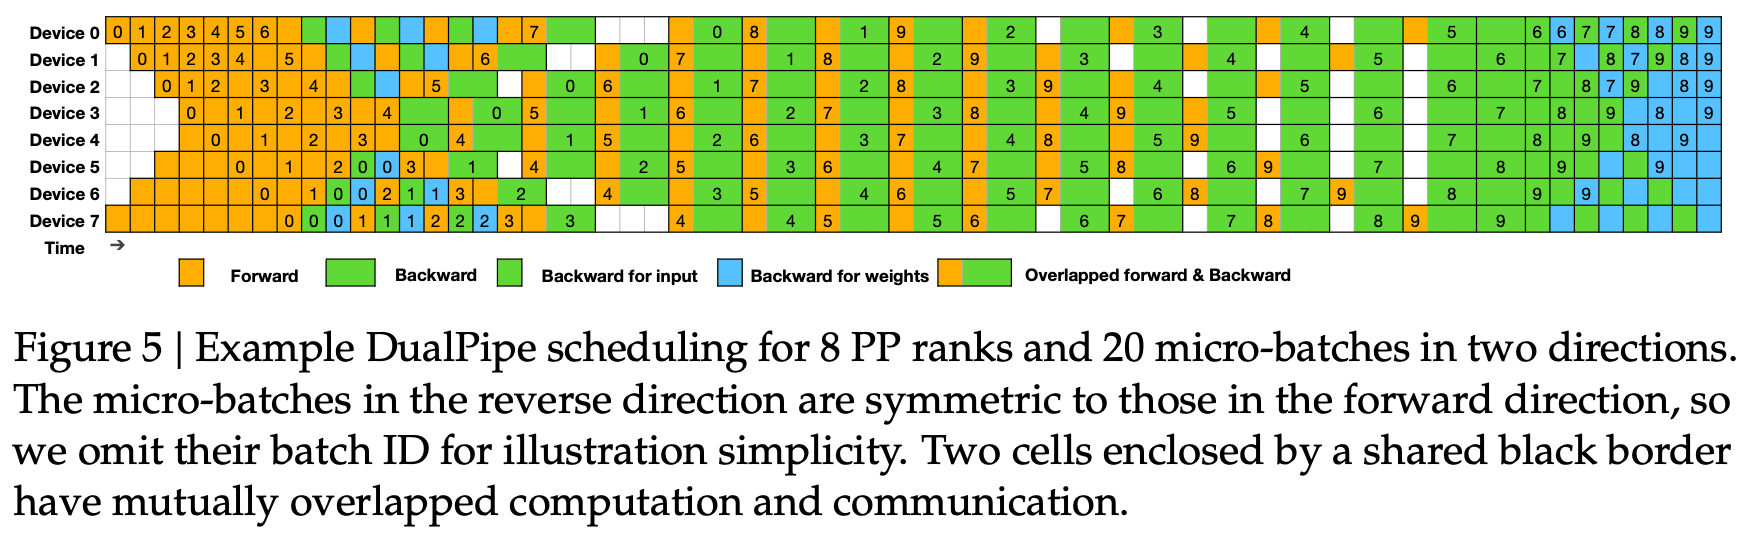
▲ DeepSeek-V3 DualPipe 架构:将反向拆解为 与 ,双向流水线并行,实现近乎零气泡。
DualPipe 核心绝技:反向求导的双向解耦
传统的反向传播 实际上由两部分截然不同的运算混合而成:
- (Activation Gradient) :计算关于输入激活值的梯度 。这是 流水线关键路径 ,必须立即通过网络传给上一个 Stage,否则上一级就会陷入停滞。
- (Weight Gradient) :计算关于模型权重的梯度 。这部分计算 完全是本地操作,没有任何跨阶段依赖 。它早算晚算对其他卡没有任何影响。
Zero-Bubble 调度 :将 优先调度执行,尽快送出关键通信张量;而把原本会形成空转气泡(Bubble)的空白时间段, 用 权重梯度计算全部填充塞满 。配合 DualPipe 的前向与反向双向交叉执行,最终达成了近乎 0% 气泡损耗 的流水线利用率。
7. 专家并行
在当今开源大模型的巅峰角逐中(如 DeepSeek-V3 671B、Mixtral 8x22B), 混合专家模型(Mixture of Experts, MoE) 以极高的参数总量和极低的有激活计算量(Active FLOPs)横扫业界。
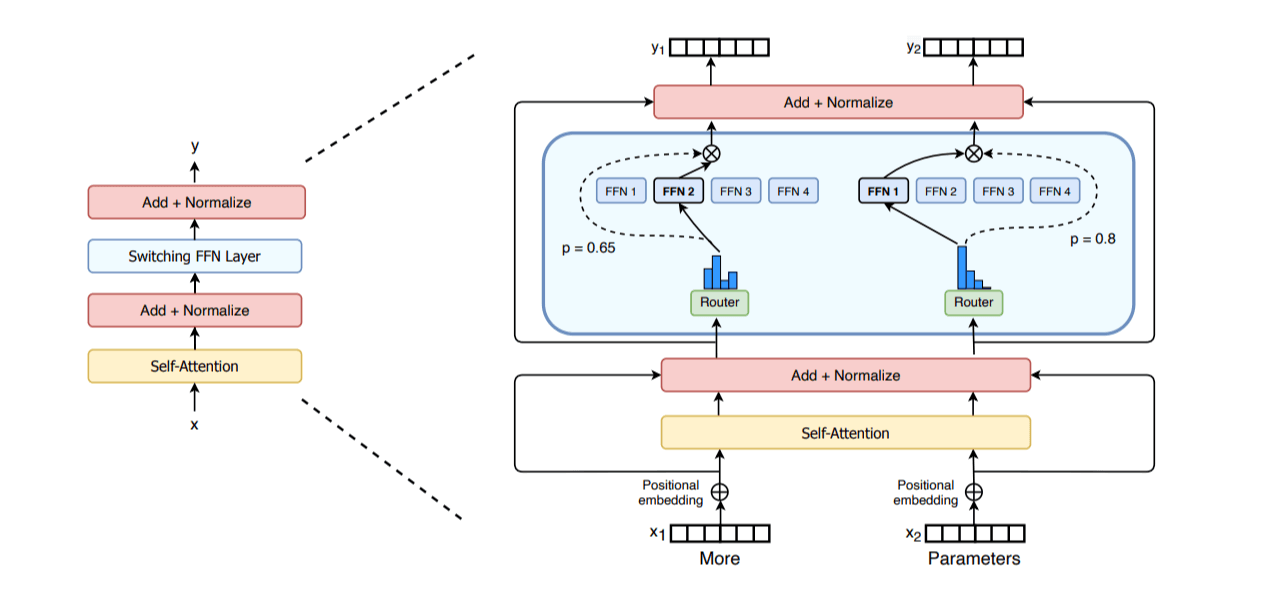
▲ MoE 架构:自注意力层共享,前馈网络切分为数十/上百个稀疏专家
在 MoE 模型中,传统的单一稠密 MLP 被替换为一组并列的独立专家网络(如 64 或 256 个专家),并由一个门控路由器(Router)为每个 Token 动态挑选最匹配的 Top- 个专家。
- 专家分布切分 :当参数量过大时,各个专家被均匀分配到不同的 GPU 卡上(每个 GPU 承载一部分专家权重)。
- 全交换通信(All-to-All Dispatch) : 每张卡上的 Token 经过 Router 预测后,需要被跨卡路由到它所指定的专家所在的 GPU 上。这需要触发一次高并发的 All-to-All 全交换通信。
- 专家计算与回传(All-to-All Combine) : 目标 GPU 上的专家计算完毕后,再次通过第二次 All-to-All 通信,把专家计算出的特征增量送回原始 Token 所在的 GPU。
优化重心 :在专家并行中,Token 在不同专家之间的分发极易受到语言语义分布的影响,造成“热门专家”算力拥堵。通常需要引入动态负载均衡辅助损失(Auxiliary Loss)或无损动态扩容调度,以消除长尾木桶效应。
8. 5D 复合并行全景速览 (5D Parallelism in a Nutshell)
行文至此,我们已经掌握了五大核心并行维度: 数据并行 (DP + ZeRO) 、 张量并行 (TP) 、 序列并行 (SP) 、 上下文并行 (CP) 、 流水线并行 (PP) 与 专家并行 (EP) 。 在真实世界中训练一个 405B 乃至万亿参数的巨兽模型,从来不是单选,而是 五维交织的统一架构(5D Parallelism) 。
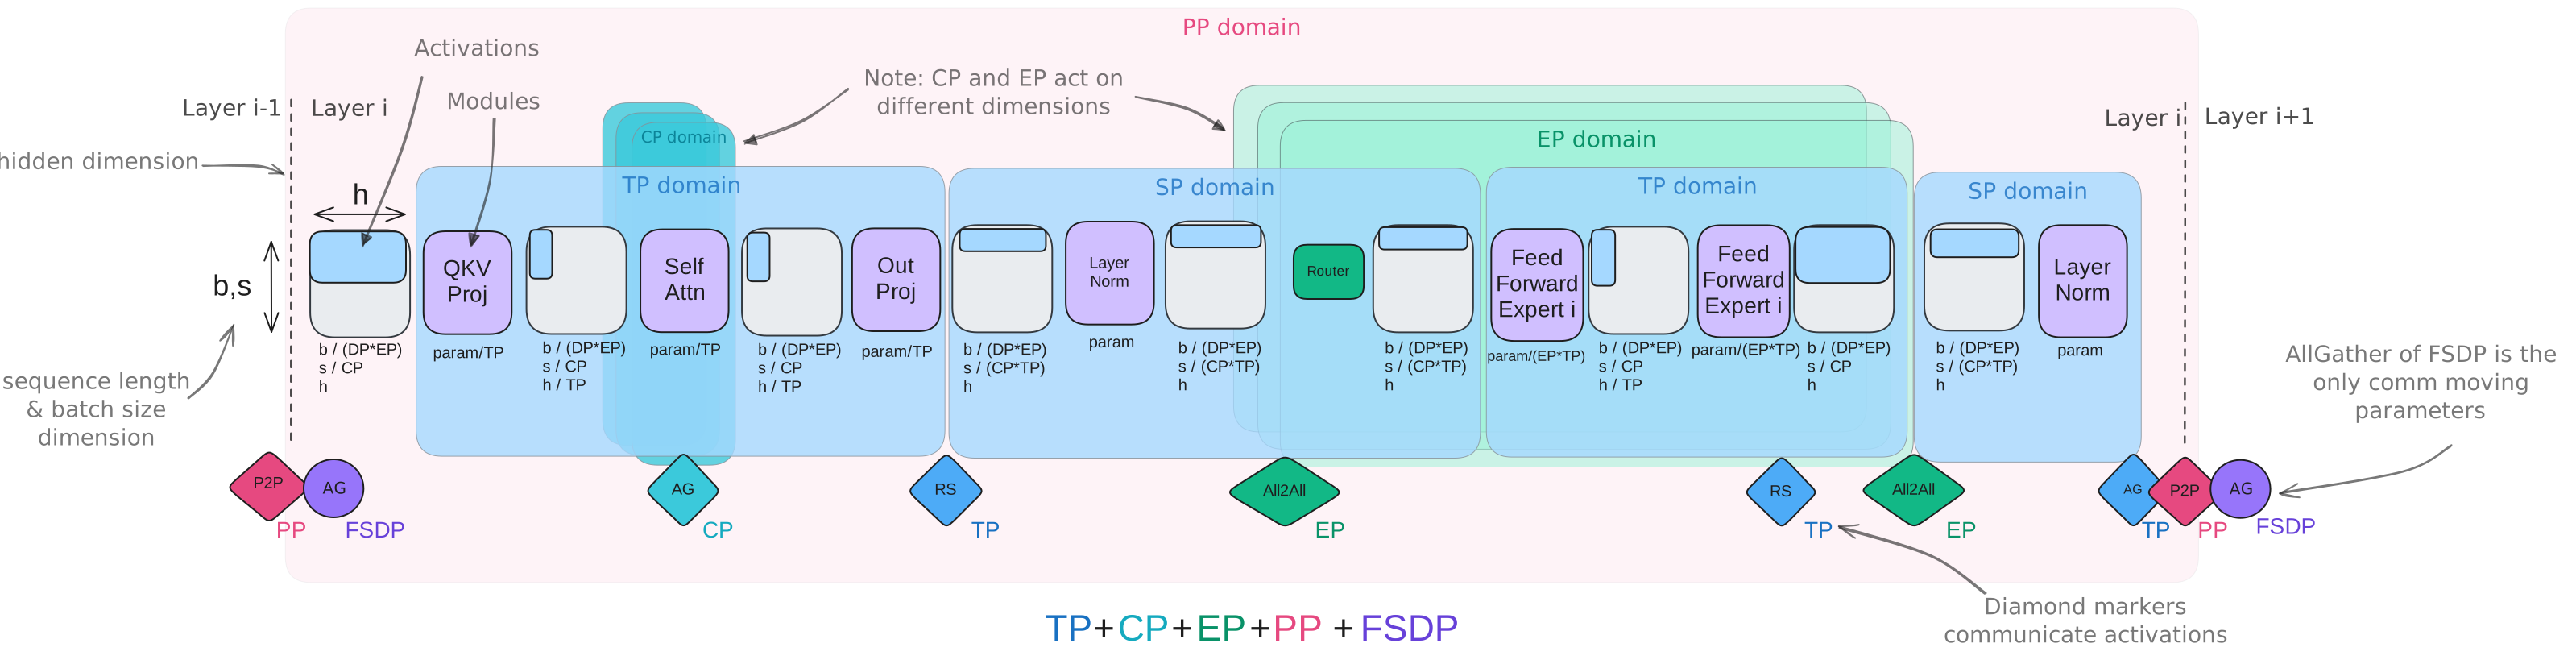
▲ 5D 并行全景拓扑映射:根据集群多级物理带宽,将不同并行策略分层对齐到硬件层级
拓扑感知映射的物理黄金法则 (Hardware Topology Affinity)
集群总卡数是各大并行维度的代数乘积:
如何将这五个维度与集群物理硬件的层次结构(单机 NVLink、机架内交换机、跨机架脊叶网络)合理对应,是提高 MFU 的关键配置问题:
- 第一层(单机 8 卡内部,NVLink ~900 GB/s) :
TP、SP 与 CP 必须锁死在单节点内。 这三者通信频次最高(每层都有)、对通信延迟最敏感,必须享有超高带宽与纳秒级通信延迟。通常取 。 - 第二层(机架内及跨机架网络,InfiniBand / RoCE 400~800 Gbps) :
PP(流水线并行) 跨机部署最为理想,因为 PP 仅在 Stage 边界发送单个微批次的激活值张量,通信量极小;
DP / ZeRO 跨机部署极为高效,因为其 AllReduce / ReduceScatter 梯度通信完全与反向计算重叠,拥有宽裕的计算时间来隐藏网络延迟;
EP(专家并行) 适合跨节点分配,借助全双工多轨 RDMA 网络执行大块 All-to-All 吞吐。
9. 寻找最佳训练配置
面对数十个自由调配的超参数与并行度组合,面对千变万化的集群硬件,我们到底该如何为手头的模型和集群挑选出 唯一最优的分布式训练配置 ? 基于我们在集群上执行的 4,100+ 次真实大规模评测 ,我们提炼出了一套科学严谨的 三步决策工作流 :
三步决策工作流 (The 3-Step Selection Recipe)
-
第一步:显存硬性容纳检验(Fitting a training step in memory)
首先排除所有会导致 OOM 的非法配置。计算单卡总显存需求:根据模型尺寸与单卡显存,确定出必须开启的最小 、 以及 ZeRO 级别。
-
第二步:匹配目标全局批大小(Achieving Target Global Batch Size)
模型科学收敛通常有其物理最佳全局批大小(,以 Token 或序列为单位)。利用约束关系反解调度:在保证微批次 足够大(通常设为 1、2 或 4,以喂饱 Tensor Core)的前提下,计算出所需的最小梯度累积步数 。
-
第三步:最大化硬件算力利用率(Optimizing Training Throughput / MFU)
在所有满足显存且匹配 GBS 的候选并行拓扑中,以 Model FLOPs Utilization (MFU) 为优化目标:- 优先让 留在节点内 NVLink;
- 优先采用 DP/ZeRO 扩展而非过大的 PP,降低流水线气泡比率;
- 如果必须使用 PP,选用交错式 1F1B 或 DualPipe,确保微批次数 。
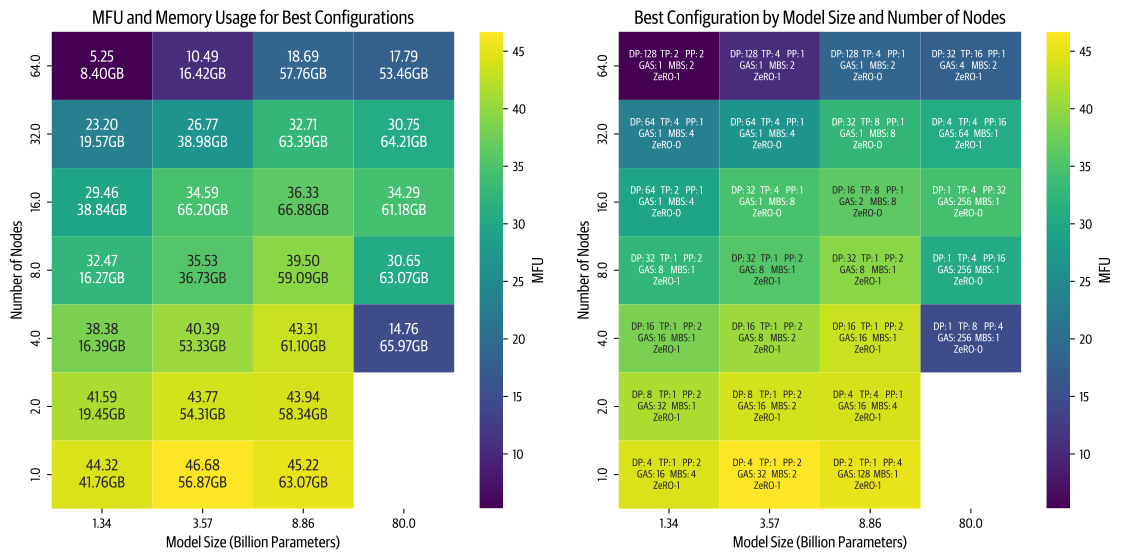
▲ 4100+ 次真实分布式实验全景热力图:不同模型尺寸与并行维度的吞吐与显存利用率边界扫描
10. 深入 GPU 底层:融合、线程与混合精度
当高层的分布式拓扑调度定型后,训练性能的胜负手便转移到了 单张 GPU 芯片的底层微架构与计算内核(Kernels)优化 之上。 为什么同样的算法,经过手写 Triton 内核或 FlashAttention 优化后,性能可以瞬间飙升数倍?
10.1 GPU 硬件微架构速成
现代 NVIDIA GPU(如 A100 / H100)本质上是一个 大规模高并发吞吐计算怪物 。其内部架构具备鲜明的层级特性:
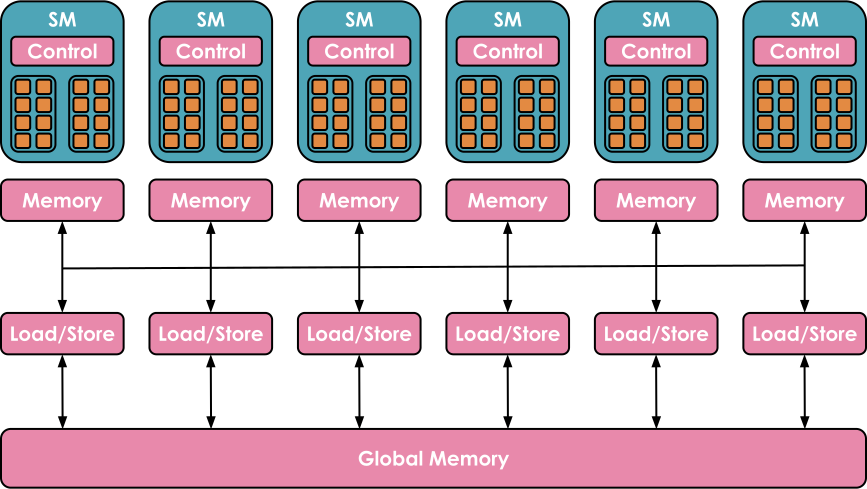
▲ GPU 核心层次结构:流式多处理器 (SM)、Warp 调度器、Tensor Cores、片上 SRAM 与外部 HBM 显存
- 流式多处理器(Streaming Multiprocessor, SM) :GPU 核心计算单元。每个 SM 包含大量 ALU、专用的 Tensor Cores 以及极高速度的寄存器堆和 片上共享内存(Shared Memory / SRAM) ;
- Warp 调度机制 :GPU 硬件以 32 个线程为一个 Warp 作为最小执行和调度单元。同一个 Warp 内的所有线程以 SIMT(单指令多线程)模式严格同步执行同一条指令;
- 显存访存金字塔与巨大延迟鸿沟 :
存储层级 物理位置 典型容量 访问延迟 聚合带宽 SRAM / Registers 芯片晶圆内部 (On-Chip) 数十 MB 仅需几个时钟周期 ~20 TB/s HBM3 / HBM3e (显存) 封装外片上堆叠 (Off-Chip) 80 ~ 141 GB 高达数百个时钟周期 2 ~ 3.35 TB/s
GPU 性能第一性原理:算力受限 vs 访存受限 (Roofline Model)
HBM 访问延迟比片上 SRAM 慢了 近百倍 。
在大模型训练中,绝大多数非矩阵乘法算子(如 LayerNorm、GELU、Softmax、Dropout、Residual Add)都是典型的 访存受限(Memory-Bound) 操作:GPU 的算力核心有 90% 的时间在发呆,苦苦等待数据从漫长迟缓的 HBM 搬运过来。
底层优化的最高纲领:竭尽一切全力,把数据留在片上 SRAM 中计算,消灭一切往返 HBM 的无效数据搬运。
10.2 底层算子性能优化四大法则
- 访存合并 (Memory Coalescing) :
确保同一个 Warp 内的 32 个线程,在访问 HBM 全局内存时访问的是一块连续对齐的 128 字节物理地址。这样 GPU 仅需触发一次 DRAM 事务即可喂饱整组线程,彻底消除无效的离散总线请求。 - 数据分块 (Tiling) :
对于超大矩阵乘法,将其拆分为能放入片上 SRAM 的小矩阵块(Tiles)。先从 HBM 将小块载入 SRAM,在高速片上内存中反复复用数据完成乘累加,使 HBM 访存次数降低数个数量级。 - 线程粗化 (Thread Coarsening) :
让每个线程负责计算多个连续的输出元素,以此提升寄存器局部性,并用算术计算掩盖内存加载指令的等待气泡。 - 消除分支发散 (Eliminating Branch Divergence) :
避免同一个 Warp 内部的线程走不同的if-else条件分支。一旦分支发散,GPU 只能将分支串行化执行,使执行效率暴跌 50% 以上。
10.3 FlashAttention 核心机理
传统的自注意力计算公式:
朴素实现必须将大小为 的庞大 Attention 矩阵写入 HBM,再从 HBM 读出做 Softmax,再写回 HBM,再读出来与 做乘法。不仅显存占用 ,而且 HBM 读写带宽被反复榨干。
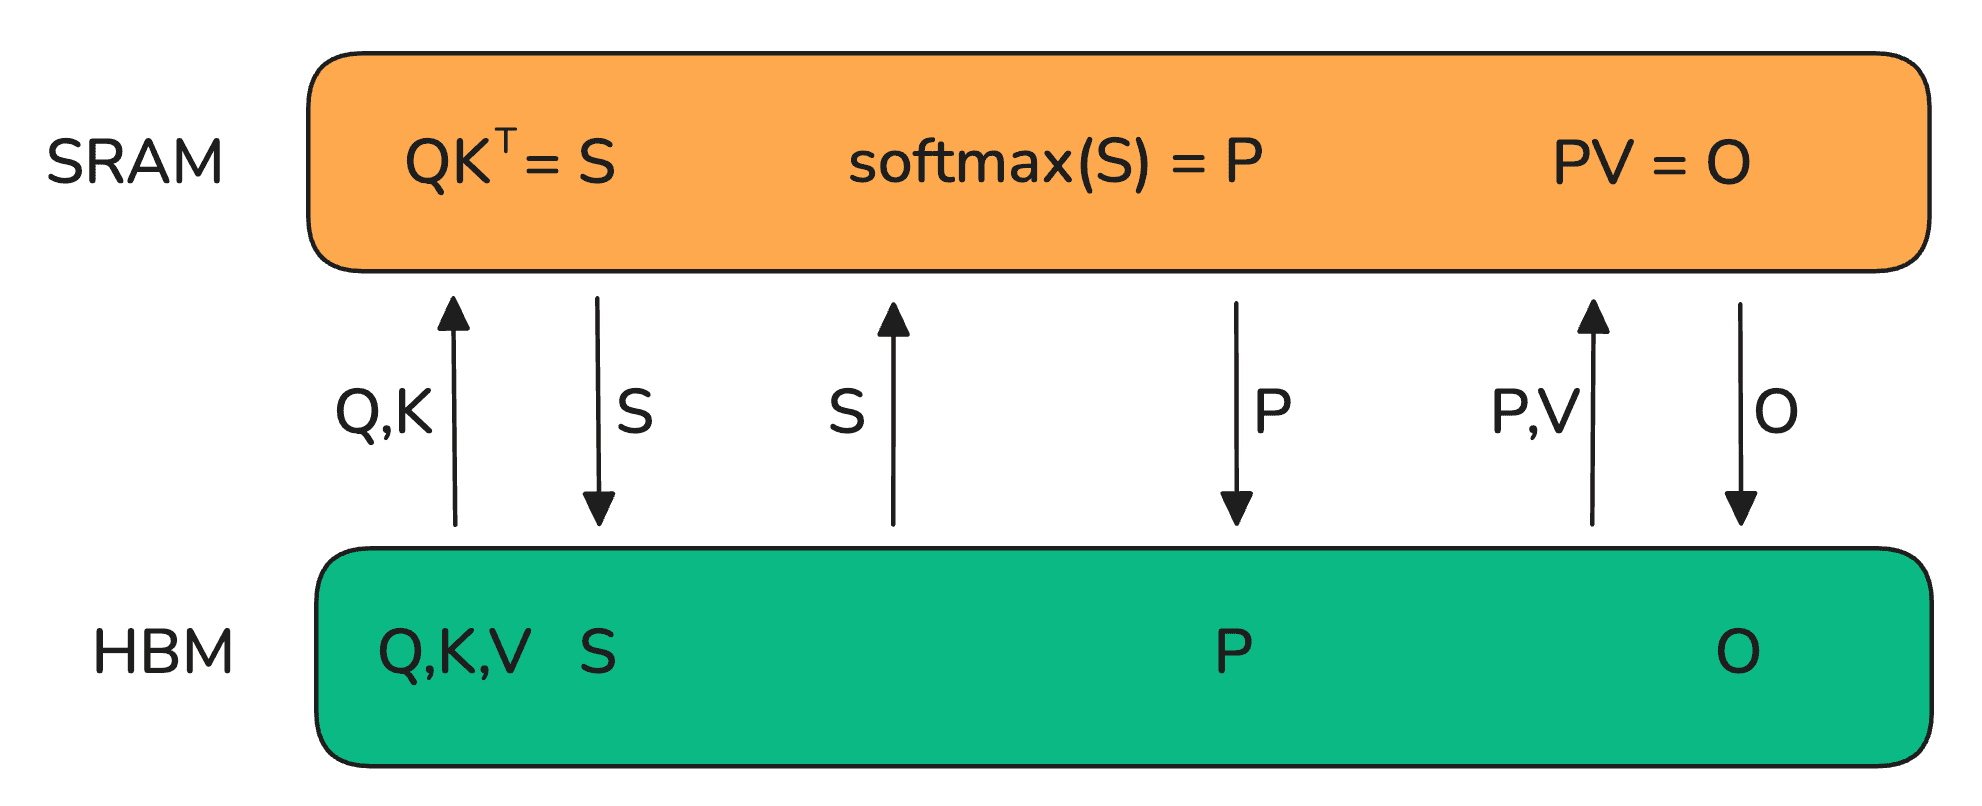
▲ FlashAttention 原理:在片上 SRAM 中完成分块计算,利用 Online Softmax 在线更新归一化分母
Tri Dao 提出的 FlashAttention 彻底颠覆了注意力算子:
- Online Softmax 片上增量更新 :将 分块载入 SRAM。借助数学技巧,动态维护局部最大值 和局部累加分母 ,每算出一个分块,当场在 SRAM 内部修正前一个分块的注意力输出, 全程完全不产生 的中间全局矩阵 。
- 反向传播重算注意力和激活值 :在反向传播时,FlashAttention 并不从 HBM 读取前向保存的巨大 Attention 矩阵,而是 直接利用保存的 在片上 SRAM 重新快速算一遍 。因为 SRAM 计算速度比读写 HBM 快得多,重算反而比从 HBM 慢速加载快了数倍。
10.4 混合精度全景:FP16、BF16 与 FP8 预训练实践
| 数据格式 | 符号位 (Sign) | 指数位 (Exponent) | 尾数位 (Mantissa) | 动态范围 (Range) | 数值精度 (Precision) | 大模型训练评价 |
|---|---|---|---|---|---|---|
| FP32 | 1 bit | 8 bits | 23 bits | 最高 (标准基准) | 收敛最稳,但显存开销极大、计算极慢 | |
| FP16 | 1 bit | 5 bits | 10 bits | 较高 | 极易发生下溢或溢出, 必须配置复杂的动态 Loss Scaler | |
| BF16 | 1 bit | 8 bits | 7 bits | 中等 | 现代预训练黄金标准 。动态范围等同 FP32,天然免疫溢出,无需 Loss Scaler | |
| FP8 (E4M3) | 1 bit | 4 bits | 3 bits | 较小 | 适合前向 | 前向权重与激活值的首选,吞吐提升近 |
| FP8 (E5M2) | 1 bit | 5 bits | 2 bits | 较大 (类似 FP16) | 适合反向 | 反向梯度的理想格式,更好适应梯度大范围剧烈波动 |
前沿突破:FP8 预训练的工程落地
在下一代大规模集群中,NVIDIA Ada Lovelace 与 Hopper 架构提供了原生的 FP8 Tensor Cores,算力吞吐相比 16-bit 再次直接翻倍。
为了在 8 位极限低精度下保证模型训练无损收敛,工业界引入了 混合 FP8 方案 :
- 在前向计算中,权重和激活使用 FP8 E4M3 ;
- 在反向传播中,梯度使用 FP8 E5M2 ;
- 采用 延迟缩放(Delayed Scaling) 或 块级细粒度量化(Block-wise Scaling) ,将量化缩放因子在局部张量块(如 128 个元素一组)上动态维护,使训练曲线与完整 BF16 几乎完全拟合重合。
11. 总结与未来展望
在大模型时代, 分布式系统工程与算法架构从来不是割裂的两张皮,而是高度共生的一体两面 。 从单卡显存的 16P 严苛拆解,到 DDP/ZeRO 的异步通信重叠;从 Megatron-LM 的列行配对与序列并行,到 Ring Attention 的超长上下文穿透;再到 DualPipe 的零气泡流水线与 5D 拓扑感知多级映射——每一个技术突破,都是在显存、算力与通信的三难困境中寻找最的物理平衡。
🔭 未来技术浪潮前沿思考 (What’s Next?)
- 推理端与强化学习 Rollout 协同扩展 :随着 DeepSeek-R1 等推理大模型的崛起,强化学习(RL)多轮 Rollout 推理与训练的反向更新正在发生深刻融合,需要更加灵活的动态弹性调度系统;
- 异构硬件与跨数据中心分布式训练 :在算力紧缺的大背景下,如何跨越不同代际的 GPU(甚至异构加速卡),乃至克服更高网络延迟的广域网分布式联合训练,正成为最受关注的研究新阵地;
- 端到端全自动并行编译器 :未来的开发者或许不再需要手动推导 5D 并行超参数,而是由基于强化学习的编译器自动搜索最优的切分图谱与算子调度。
附录篇
A0: 分布式并行通信原语速成
分布式深度学习的底层通信完全依赖于一组标准的 集合通信原语(Collective Communications) ,通常由 NVIDIA 的 NCCL 库在底层极速实现:
| 通信原语 | 操作描述 | 每个 Rank 发送/接收数据量 | 典型大模型训练场景 |
|---|---|---|---|
| Broadcast | 根节点向所有节点分发完全相同的一份数据 | 发送 ,接收 | 训练启动时广播初始模型权重与配置 |
| Reduce | 对所有节点的数据执行归约操作(如求和、最大值),结果仅保留在根节点 | 发送 ,根节点接收 | 收集单步 Global Loss 或评估指标 |
| AllReduce | 对所有节点数据执行归约,并 让所有节点都获得完全一致的最终归约结果 | DDP 梯度同步、TP 行并行后的特征汇总 | |
| Gather | 将所有节点的数据拼接汇聚到根节点 | 发送 ,根节点接收 | 收集分散在各卡的生成结果 |
| AllGather | 所有节点都收集其他所有节点的数据切片, 拼接成完整全局张量 | ZeRO-3 参数恢复、序列并行 SP 还原完整激活值 | |
| Scatter | 根节点将一个大张量均匀切块,分发给各个节点 | 根节点发送 ,各节点接收 | 切分数据集分发给各卡 |
| ReduceScatter | 对所有节点数据求和归约,但 各节点最终只保留归约结果中属于自己的那一部分切片 | ZeRO-2 梯度汇集、序列并行 SP 切分特征图 |
经典的 Ring AllReduce 环状算法两阶段数学推导
📐 为什么 Ring AllReduce 是带宽最优的?
将待同步的张量大小设为 (字节),集群 GPU 卡数为 。Ring AllReduce 将张量均匀等分为 个分块,将所有 GPU 连接为一个单向闭合物理逻辑环:
-
第一阶段:Scatter-Reduce 阶段(共 步)
在每一步中,每张卡向邻居发送一块切片(大小为 ),并从另一侧邻居接收一块并执行累加。经过 步后,每张卡正好掌握了全局最终求和结果的其中 分块。
第一阶段每卡传输数据量: -
第二阶段:All-Gather 阶段(共 步)
在每一步中,每张卡继续向邻居传递已算好的这 最终结果。经过 步后,所有 GPU 都收集到了全部 个分块,拼装出完整全局结果。
第二阶段每卡传输数据量:
总通信量 :
数据量结论 :每张 GPU 传输的数据总量 严格趋近于 ,与集群总卡数 几乎完全无关 。这一表达式只刻画每卡数据量的渐近关系;实际通信时间还受延迟、轮次数、网络拓扑与拥塞影响,不能据此推断扩展到数千卡时通信成本不变。
A1: 分布式训练性能分析实战
遇到训练速度缓慢时,切忌盲目猜测。工业级调优依赖精准的可视化性能分析工具链:
- PyTorch Profiler + TensorBoard / Chrome Trace :抓取 Host 端 Python 调用与 Device 端 CUDA Kernel 执行的时间戳对照,定位 CPU 调度瓶颈或 DataLoader 数据加载卡顿;
- NVIDIA Nsight Systems (nsys) :系统级全景追踪。可视化观察各个 CUDA Stream 上算子执行与
ncclKernel通信流的时间线重叠情况,精准诊断通信是否被计算成功覆盖; - NVIDIA Nsight Compute (ncu) :微架构内核诊断。分析单个 GEMM 算子的 Tensor Core 活跃度、Memory Bandwidth 饱满度及寄存器溢出情况。
A2: 业界主流大模型训练规格全景对照表
| 模型名称 | 总参数量 | 激活参数量 | 隐藏层 | 网络层数 | 注意力头数 | 预训练采用的复合方案 |
|---|---|---|---|---|---|---|
| Llama 3 8B | 8.03 B | 8.03 B | 4,096 | 32 | 32 (8 KV) | DP (ZeRO-1/3) + FSDP |
| Llama 3 70B | 70.6 B | 70.6 B | 8,192 | 80 | 64 (8 KV) | TP=8 + SP + PP=4 + DP |
| Llama 3.1 405B | 405 B | 405 B | 16,384 | 126 | 128 (16 KV) | TP=8 + SP + CP=8 + PP=16 + DP |
| DeepSeek-V3 | 671 B (MoE) | 37 B (激活) | 7,168 | 61 | 128 (MLA) | DualPipe PP + EP=64 + ZeRO-1 + FP8 |
A3: 通信与计算重叠比值的严格数学推导
在各种模型并行策略中,我们能否成功将通信耗时彻底隐藏在计算耗时阴影之下?判定准则是:
张量并行 (TP) 的重叠比值数学证明
在张量并行中,行并行输出后需要执行 AllGather(序列并行下)或 AllReduce。传输的数据量为:
对应的硬件通信时间为:
而紧接着下一个矩阵乘法线性层的计算 FLOPs 为 。分配到各 TP 卡上的计算时间为:
两式相除得到 重叠判别准则 :
震撼的数学洞察
注意观察上面的比值: 序列长度 和批大小 竟然在上下分母中被完全抵消消掉了。
这说明张量并行能否实现计算隐藏通信, 完全取决于模型的隐藏层维度 与硬件芯片的算力带宽比() 。只要隐藏层维度 足够大(如现代大模型的 ),TP 的通信时间就能天然被庞大的矩阵计算有效包裹隐藏。