深入理解 vLLM:高吞吐大语言模型推理系统架构剖析
从 PagedAttention、连续批处理、前缀缓存、投机解码等核心机制,到多 GPU 动态服务架构的全景剖析。
原文标题:Inside vLLM: Anatomy of a High-Throughput LLM Inference System
作者:Aleksa Gordić | 发布时间:2025年8月29日
副标题:从 PagedAttention、连续批处理、前缀缓存、投机解码等核心机制,到多 GPU、多节点大规模动态服务架构
代码分析基准:vLLM Commit 42172ad(2025年8月9日)
在这篇长文中,我将循序渐进地介绍构建现代化高吞吐大语言模型(LLM)推理系统所涉及的所有核心系统组件与进阶特性。具体而言,我将对 vLLM [1] 的内部工作原理进行全景式深度拆解。
本文是该系列技术博客的第一篇。文章遵循“倒金字塔”结构,先从宏观视角切入,随后层层递进铺开细节,帮助大家在不被繁杂细枝末节淹没的前提下,建立起对整个推理系统的精准高层心智模型。
后续文章将进一步深入各个具体的子系统源码实现。
全文整体结构分为五个部分:
- LLM 引擎与引擎核心(LLM engine & engine core):vLLM 的基础基石(请求调度、PagedAttention、连续批处理等)
- 进阶特性(Advanced features):分块 Prefill(Chunked prefill)、前缀缓存(Prefix caching)、引导式/结构化解码(Guided decoding)与投机解码(Speculative decoding)、分离式 Prefill/Decode 架构(Disaggregated P/D)
- 横向扩展(Scaling up):从单 GPU 到多 GPU 执行架构
- 服务层(Serving layer):分布式 / 并发 Web 服务支撑体系
- 基准测试与自动调优(Benchmarks and auto-tuning):测量延迟与吞吐量
说明笔记
- 本文分析基于 vLLM 代码库的 commit 42172ad(2025年8月9日)。
- 目标受众:任何对最前沿的大模型推理引擎架构感到好奇的开发者,以及有意向参与 vLLM、SGLang 等开源基础设施建设的工程师。
- 本文主要聚焦于最新的 V1 引擎。我也深入探究过 V0 引擎(现已废弃),这对于理解该项目的设计演进非常有价值,而且许多核心概念依然通用。
- 第一节关于“LLM 引擎与引擎核心”的内容可能相对偏底层与抽象——但在文章后续部分准备了极其详尽的实例与清晰的架构图解。:)
第一部分:LLM 引擎与引擎核心(LLM Engine & Engine Core)
LLM 引擎(LLM Engine)是 vLLM 最基本的构建单元。单凭它自身,就已经能够实现极高吞吐量的模型推理——但仅限于离线场景(Offline setting)。此时你还无法直接将其作为 Web 服务对外提供给线上客户。
我们将使用以下离线推理代码片段作为贯穿全篇的基础示例(改编自 basic.py):
from vllm import LLM, SamplingParams

prompts = [
    "Hello, my name is",
    "The president of the United States is",
]

sampling_params = SamplingParams(temperature=0.8, top_p=0.95)

def main():
    llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0")

    outputs = llm.generate(prompts, sampling_params)

if __name__ == "__main__":
    main()
说明:环境变量配置
VLLM_USE_V1="1"# 显式启用最新的 V1 引擎VLLM_ENABLE_V1_MULTIPROCESSING="0"# 在单进程模式下运行
当前这个基准配置具备以下特征:
- 离线(offline):没有引入任何 Web 网络层或分布式系统的脚手架组件;
- 同步(synchronous):所有的推理执行都发生在一个阻塞式的单一进程中;
- 单 GPU(single-GPU):不涉及数据并行(DP)、张量并行(TP)、流水线并行(PP)或专家并行(EP),即 DP/TP/PP/EP 均为 1;
- 标准 Transformer 架构 [2]:如果要支持像 Jamba 这类混合模型,则需要更复杂的混合 KV Cache 内存分配器。
从这个极简的起点开始,我们将一步步向上构建出一个在线、异步、多 GPU、多节点的高可用大模型推理服务系统——但底层始终承载着标准 Transformer 模型的推理任务。
在这个极简示例中,我们主要做了两件事:
- 实例化一个
LLM引擎对象; - 调用其上的
generate方法,对给定的 Prompt 列表进行采样生成。
让我们首先从引擎的构造函数开始深入分析。
LLM 引擎构造函数(LLM Engine Constructor)
LLM 引擎由以下几个核心组件有机组合而成:
- vLLM 配置(vLLM config):汇集了配置模型结构、显存缓存、并行策略等所有系统关键旋钮与超参数;
- 处理器(Processor):负责将用户输入的原始 Prompt 文本,通过校验、分词(Tokenization)与预处理转换为
EngineCoreRequests; - 引擎核心客户端(Engine core client):在当前单进程示例中,我们使用的是
InprocClient(其本质基本等同于EngineCore);在后文中我们将逐步升级为能够支持大规模集群动态服务的DPLBAsyncMPClient; - 输出处理器(Output processor):将底层返回的原始
EngineCoreOutputs解码并转换封装为终端用户可见的RequestOutput对象。
说明 随着旧版 V0 引擎被逐步弃用,代码库中的具体类名和接口签名可能会产生微调。本文将着重阐述架构背后的核心设计思想,而非死记硬背具体的代码签名,并在行文中对部分非关键的底层细节进行适度抽象。
引擎核心(Engine Core)自身又由若干关键子组件构成:
- 模型执行器(Model Executor):驱动模型前向传播的动力核心。当前示例中使用的是
UniProcExecutor(在单张 GPU 上绑定单个Worker进程)。在后文中我们将升级到支持多卡协同的MultiProcExecutor; - 结构化输出管理器(Structured Output Manager):用于引导式受限解码(Guided Decoding)——我们将在后文专题讲解;
- 调度器(Scheduler):负责决定在下一个引擎推理步(Step)中执行哪些请求——其内部包含:
a. 调度策略配置(Policy setting):可以是 FCFS(先来先服务)或 Priority(按优先级调度);
b.waiting(等待队列)与running(运行队列);
c. KV Cache 管理器(KV cache manager):这是支撑 PagedAttention [3] 分页内存管理的心脏所在。
KV Cache 管理器维护着一个 free_block_queue——即可用空闲 KV 物理块的资源池(根据 GPU 显存容量大小与 Block 大小的不同,其数量通常在数十万块量级)。在 PagedAttention 执行期间,这些物理块充当了将离散逻辑 Token 映射到实际已计算 KV 显存块的核心索引结构。
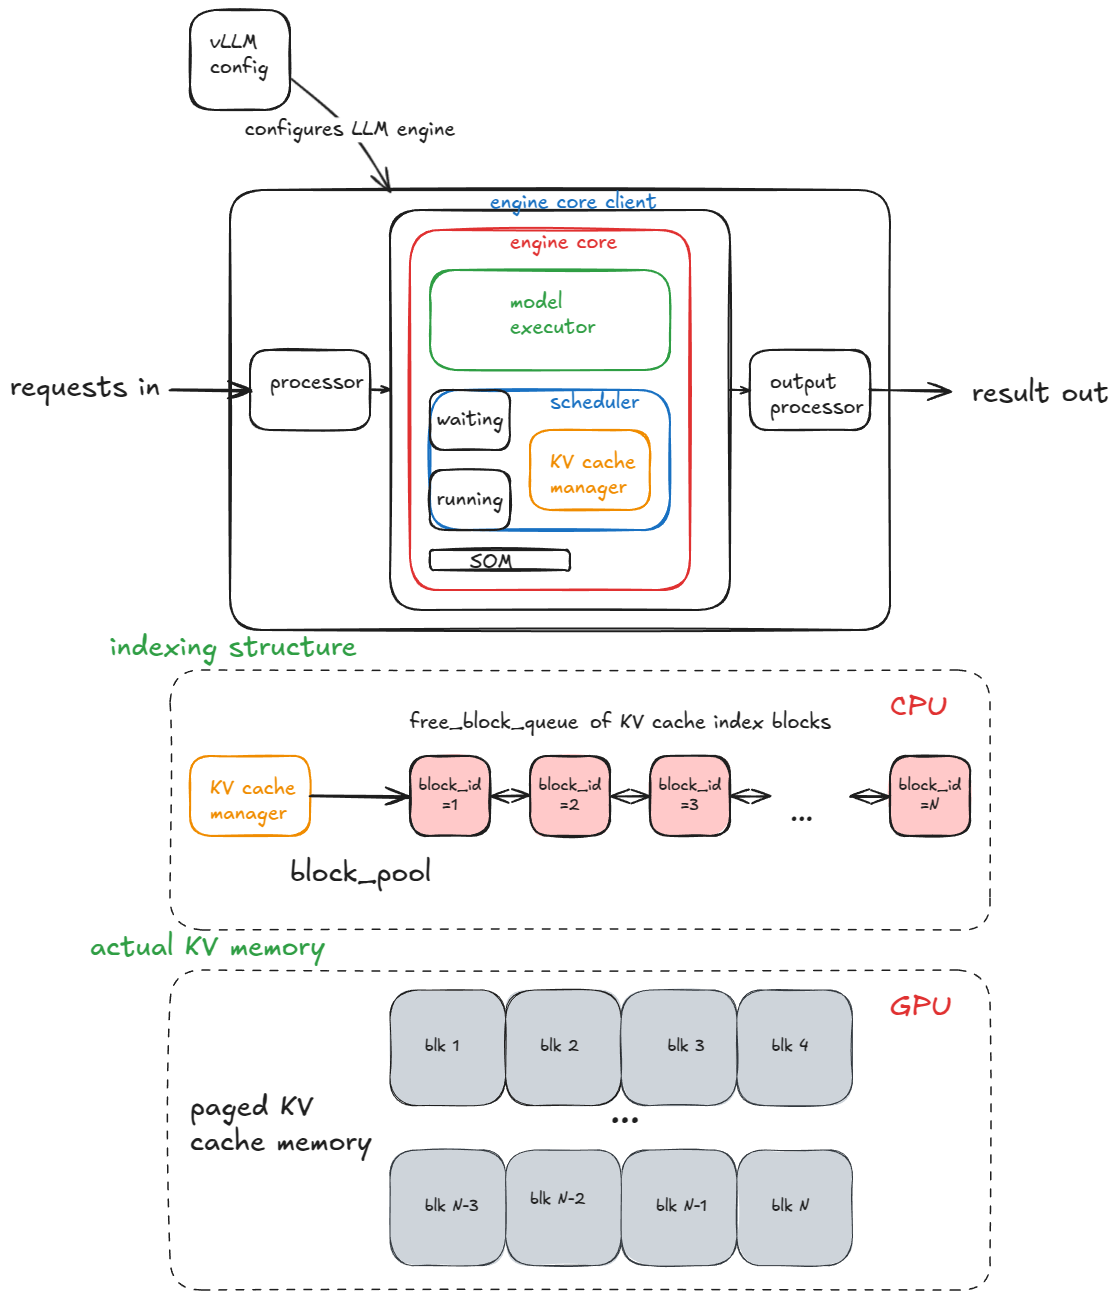 图 1:本文所述的核心系统组件及其相互调用关系
[!TIP] 单 Block 显存大小计算公式 标准 Transformer 层(非 MLA 架构 [4])的单个 Block 大小计算公式如下:
2 (Key 与 Value) * block_size (默认=16) * num_kv_heads * head_size * dtype_num_bytes (例如 bf16 格式为 2 字节)
在构建模型执行器(Model Executor)期间,系统会实例化一个 Worker 对象,并相继执行三个核心关键流程。(稍后在引入 MultiProcExecutor 时,完全相同的这套流程将在跨多张 GPU 的各个独立 Worker 进程中并行独立执行):
- 初始化硬件设备(Init device):
- 为该 Worker 绑定具体的 CUDA 设备(例如
"cuda:0"),并严格校验模型的数据类型(如 bf16)是否被硬件底层指令集所支持; - 根据用户设定的
gpu_memory_utilization参数(例如 0.8 表示允许占用整卡 80% 的总显存),校验当前是否有足够空闲的物理 VRAM; - 初始化分布式通信拓扑与通信域参数(DP / TP / PP / EP 等);
- 实例化
model_runner(内部承载着采样器 Sampler、KV Cache 张量以及input_ids、positions等前向传播所需的 GPU 显存缓冲区); - 实例化
InputBatch对象(承载 CPU 侧的前向输入缓冲区、用于 KV Cache 寻址的 Block Tables 块表以及采样元数据等)。
- 为该 Worker 绑定具体的 CUDA 设备(例如
- 加载模型权重(Load model):
- 根据模型结构定义实例化神经网络架构;
- 将模型权重加载注入到显存中;
- 调用
model.eval()进入 PyTorch 的纯推理无梯度模式; - 可选步骤:在模型上调用
torch.compile()进行图编译优化。
- 初始化 KV Cache 显存池(Initialize KV cache):
- 获取逐层(Per-layer)的 KV Cache 规范。以往这始终是
FullAttentionSpec(同构标准 Transformer),但随着滑动窗口注意力以及 Transformer/SSM 混合架构(如 Jamba)的出现,这变得更为精巧复杂(详见 Jenga [5]); - 执行一次 Dummy/Profiling 预热前向传播,并对 GPU 显存进行快照采样,从而精确计算出剩余可用 VRAM 能够容纳的 KV Cache 物理块总数;
- 在显存中连续预分配、Reshape 并将 KV Cache 张量精确绑定到各层注意力模块中;
- 准备注意力元数据(例如将底层计算后端显式指定为 FlashAttention),供后续前向计算时的 GPU Kernel 消费;
- 除非命令行显式指定了
--enforce-eager,否则引擎将针对各个预热 Batch Size 分别执行 Dummy Run 并捕获 CUDA Graphs。CUDA Graphs 能够将整条 GPU 工作流序列固化为一个无环有向图(DAG)。在后续前向计算阶段,直接重放预先固化的 Graph,彻底消除了 CPU 侧的 Kernel 启动开销,从而极大降低端到端延迟。
- 获取逐层(Per-layer)的 KV Cache 规范。以往这始终是
Generate 生成函数
推理的第一步是校验请求并将其注入到底层引擎中。针对用户传入的每个 Prompt,系统会依次执行:
- 生成一个全局唯一的 Request ID,并记录请求的到达时间戳(Arrival Time);
- 调用输入预处理器对 Prompt 文本进行分词处理,返回包含
prompt文本、prompt_token_ids序列以及输入类型type(文本、Token、Embeddings 等)的字典; - 将上述信息打包为
EngineCoreRequest,并附加上优先级、采样参数(Sampling Params)以及其他控制元数据; - 将该请求传递给引擎核心,引擎核心将其封装为内部统一的
Request状态对象,并将其生命周期状态置为WAITING。随后该请求被加入到调度器的waiting等待队列中(若为 FCFS 策略则直接追加到末尾,若为优先级策略则执行堆 Push)。
到这里,引擎已经接收到了待处理的工作负载,真正的推理执行即将拉开帷幕。在同步引擎示例中,这批初始输入的 Prompt 是整个运行周期内唯一需要处理的任务——中途没有任何机制能够在半路注入新的并发请求。相比之下,异步引擎则原生支持这一特性(即工业界著名的连续批处理(Continuous Batching)[6]):在每一次推理 Step 结束后,调度器都会统筹兼顾新到达的请求与正在运行的存量请求。
核心机制:连续批处理 由于 vLLM 的前向传播会将同一个 batch 内的所有请求扁平化拼接成单一的连续序列,并由定制的高效算子进行寻址处理,因此从底层数学与算子机制上说,即便在同步引擎中,连续批处理的基础能力在本质上也是完备支持的。
接下来,只要等待或运行队列中依然存在未处理完的请求,引擎就会不断循环调用其核心的 step() 函数。每一次 Step 的执行都严格划分为三个阶段:
- 调度阶段(Schedule):决定哪些请求应当进入本轮 Step 参与前向计算(可以是 Decode 解码请求,也可以是(分块)Prefill 预填充请求);
- 前向传播阶段(Forward pass):执行底层深度学习模型的矩阵计算并采样出新的 Token;
- 后处理阶段(Postprocess):将最新采样出的 Token ID 追加到对应的
Request对象中,执行反分词(Detokenize),并严格检查停止条件(Stop Conditions)。如果某个请求已经触发停止条件,则立即执行资源清理(例如将其占用的 KV Cache 显存物理块归还回free_block_queue空闲池),并提前将最终输出结果返回给调用方。
机制说明:请求的停止条件(Stop conditions)
- 请求的总长度超出了系统或自身的上限(达到模型的
max_model_length或自身设定的max_tokens);- 最新采样生成的 Token 命中了结束符 EOS ID(除非在基准测试时显式开启了
ignore_eos,用以强制生成指定数量的输出 Token);- 采样出的 Token ID 匹配到了采样参数中所列出的任意
stop_token_ids;- 生成的文本中检测到了匹配的终止字符串(Stop Strings)——系统会在第一个终止字符串出现处对文本进行截断,并在引擎中中止该请求(注意:
stop_token_ids会保留在最终输出中,但 Stop Strings 自身会被截除)。
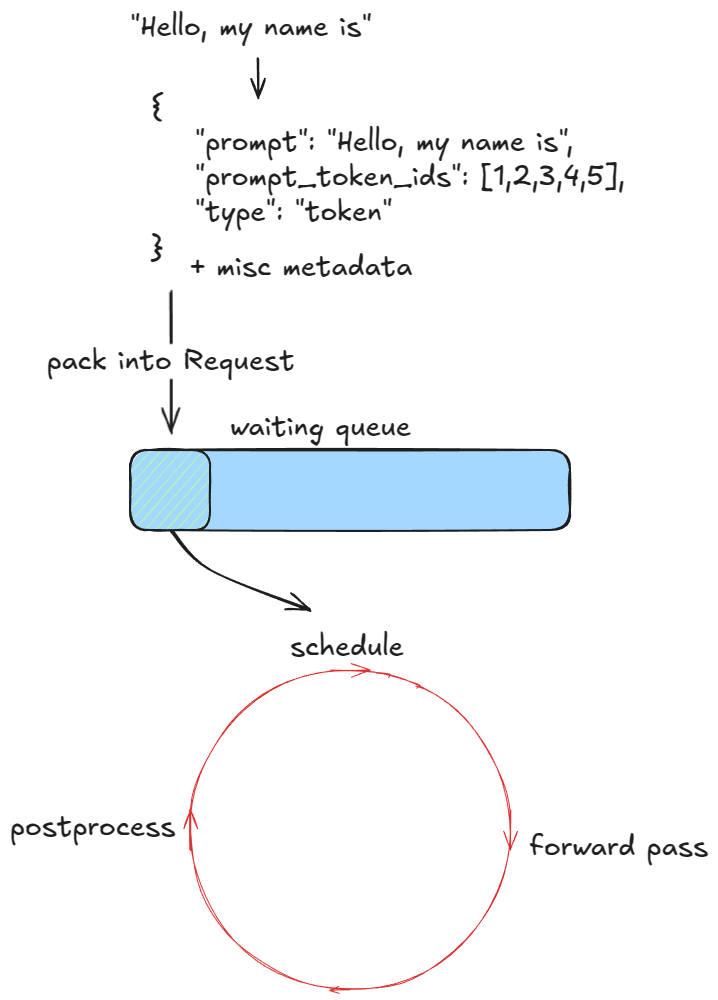 图 2:引擎主循环(Engine Loop)执行流程示意图
架构说明:流式传输 在流式传输(Streaming)模式下,中间生成的 Token 会在每一步被实时推送给客户端,为简化当前的主线理解,我们暂时先忽略这一分支。
调度器(Scheduler)
大模型推理引擎日常处理的负载主要划分为两类截然不同的计算模式:
- Prefill(预填充)请求——对输入的 Prompt 所有 Token 一次性执行完整的前向计算。这部分计算通常是典型的**计算密集型(Compute-bound)**任务(具体阈值取决于底层硬件算力以及 Prompt 的序列长度)。在 Prefill 结束时,系统依据最后一个位置的概率分布采样输出第一个生成 Token。
- Decode(解码)请求——单次前向计算仅处理最新生成的那 1 个 Token。由于所有先前的历史 KV 向量均已缓存在显存中,此时整个计算属于极度典型的**显存带宽密集型(Memory-bandwidth-bound)**任务,因为 GPU 必须将数十 GB 的模型完整权重从 HBM 加载到计算核心中,仅仅为了推导这 1 个 Token。
[!TIP] 性能模型参考 在本文的基准测试章节中,我们将深入剖析 GPU 性能的 Roofline 模型,届时将从硬件第一性原理揭示 Prefill 与 Decode 性能瓶颈特征的本质差异。
得益于全新的架构设计,vLLM 的 V1 调度器能够在同一个推理 Step 内混合调度并协同批处理上述两种不同类型的请求。作为对比,旧版的 V0 引擎在单一 Step 内只能非此即彼地单独处理 Prefill 或 Decode。
在调度策略上,调度器具有严格的优先级次序:优先满足 Decode 请求——即已经在 running 队列中的存量请求。针对队列中的每个 Decode 请求,调度器会依次执行:
- 计算该请求在本次 Step 需要生成的 Token 数量(由于投机解码与异步调度的存在,该值并不一定恒等于 1);
- 调用 KV Cache 管理器的
allocate_slots方法; - 从当前 Step 的可用 Token 预算(Token Budget)中扣减第 1 步计算出的 Token 数。
完成对活跃 Decode 请求的显存分配与编排后,调度器接着从 waiting 队列中拉取就绪的 Prefill 请求,依次执行:
- 查询该请求已预先计算好的 Block 数量(若未开启前缀缓存 Prefix Caching 则恒返回 0);
- 调用 KV Cache 管理器的
allocate_slots方法; - 将该请求从
waiting队列中弹出,转移至running队列,并将其状态原子更新为RUNNING; - 从剩余的 Token 预算中扣除对应的 Token 数量。
现在让我们聚焦剖析 allocate_slots 的底层运作逻辑,它包含三个步骤:
- 计算所需 Block 数量——精确确定必须新分配的 KV Cache 物理块数
n。默认配置下每个 Block 容纳 16 个 Token。举例来说,若一个 Prefill 请求包含了 17 个新增 Token,则至少需要分配ceil(17/16) = 2个物理块; - 校验物理显存余量(Checks availability)——如果当前管理器空闲块池中的可用物理块不足以满足分配需求,则提前退出当前调度流程。根据当前请求是 Decode 还是 Prefill,引擎可能会触发基于重算的抢占(Recompute Preemption),即主动驱逐低优先级请求(调用
kv_cache_manager.free将其占用的 KV 块释放回池子中);或者直接跳过本次调度,继续让现有批次向前推进; - 实际分配物理块(Allocates blocks)——通过 KV Cache 管理器的协调器(Coordinator),从空闲块池(
free_block_queue双向链表)的头部依次取出n个物理块。将其写入req_to_blocks字典,完成每个request_id到其物理 KV Cache 块列表的精确映射。
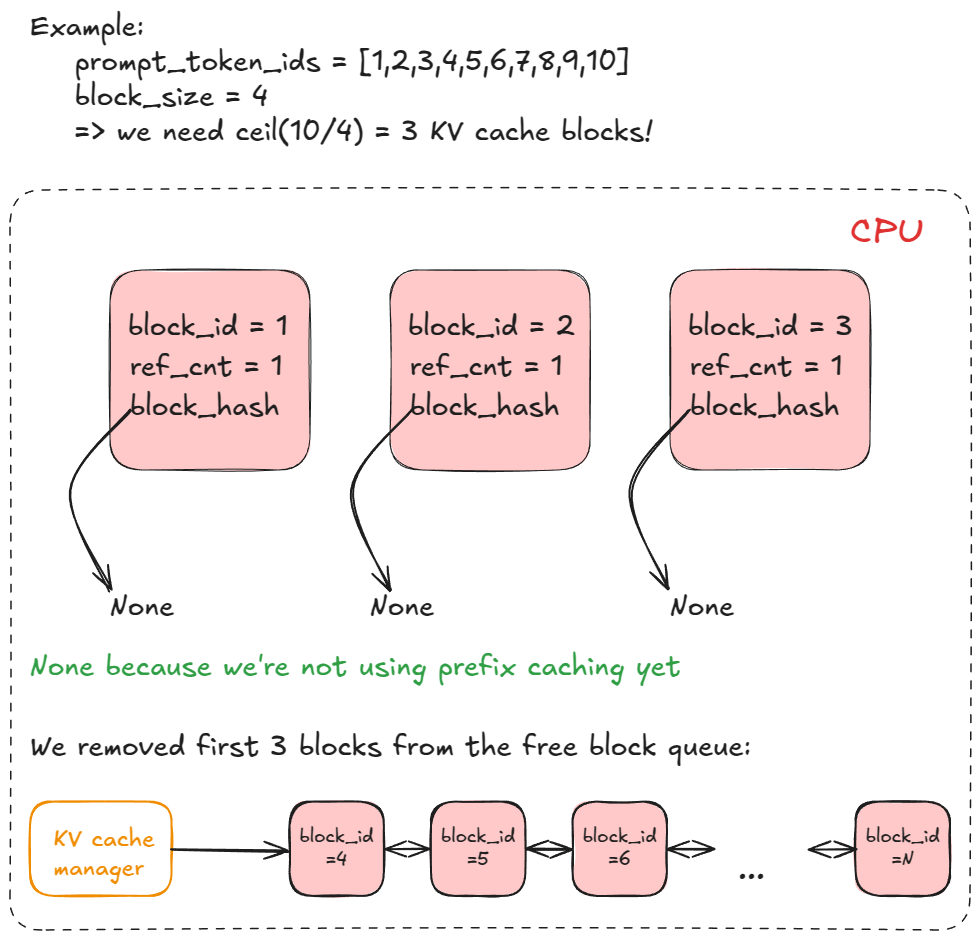 图 3:KV Cache 物理块链表(Block Table)寻址映射示意图
执行前向传播(Run forward pass)
系统发起对模型执行器的 execute_model 调用,该调用随后委托给底层 Worker,Worker 最终指派其内部的 model_runner 完成执行。
核心执行步骤如下:
- 更新批次状态(Update states)——从
input_batch中剔除已经结束生成的请求;同步更新与前向传播相关的各类底层元数据(例如各请求的 KV Cache 块映射表,用于在前向算子中索引分页显存); - 准备输入张量(Prepare inputs)——将 CPU 侧的输入缓冲区高效异步拷贝至 GPU 显存;推导并计算 Token 的物理位置编码(Positions);构建
slot_mapping槽位映射关系;构造底层的注意力元数据(Attention Metadata); - 前向传播计算(Forward pass)——调用定制的高性能 PagedAttention CUDA 核函数执行模型计算。整个批次中的所有序列会被展平并拼接成单一的连续“超级序列(Super sequence)”。依靠位置索引与注意力掩码的精妙隔离,确保每个序列在自注意力计算时仅能看到并聚焦于自身的 Token,从而在彻底消除右填充(Right-padding)浪费的前提下完美实现了极致高效的连续批处理;
- 提取末尾 Token 隐层状态(Gather last-token states)——抽取出各个序列最终输出位置的隐藏状态向量,并通过输出投影层计算出最终的未归一化对数概率分布(Logits);
- 采样新 Token(Sample)——严格按照调用方配置的采样策略(贪婪采样 Greedy、温度采样 Temperature、Top-p、Top-k 等),从计算好的 Logits 分布中采样出最终的输出 Token。
前向传播自身在工程上有两种截然不同的执行模式:
- Eager(动态即时)模式:直接调用标准的 PyTorch 原生动态图前向流程;
- Captured(CUDA Graphs 捕获固化)模式:直接执行/重放预先捕获的 CUDA Graph,消除 CPU 调度开销。
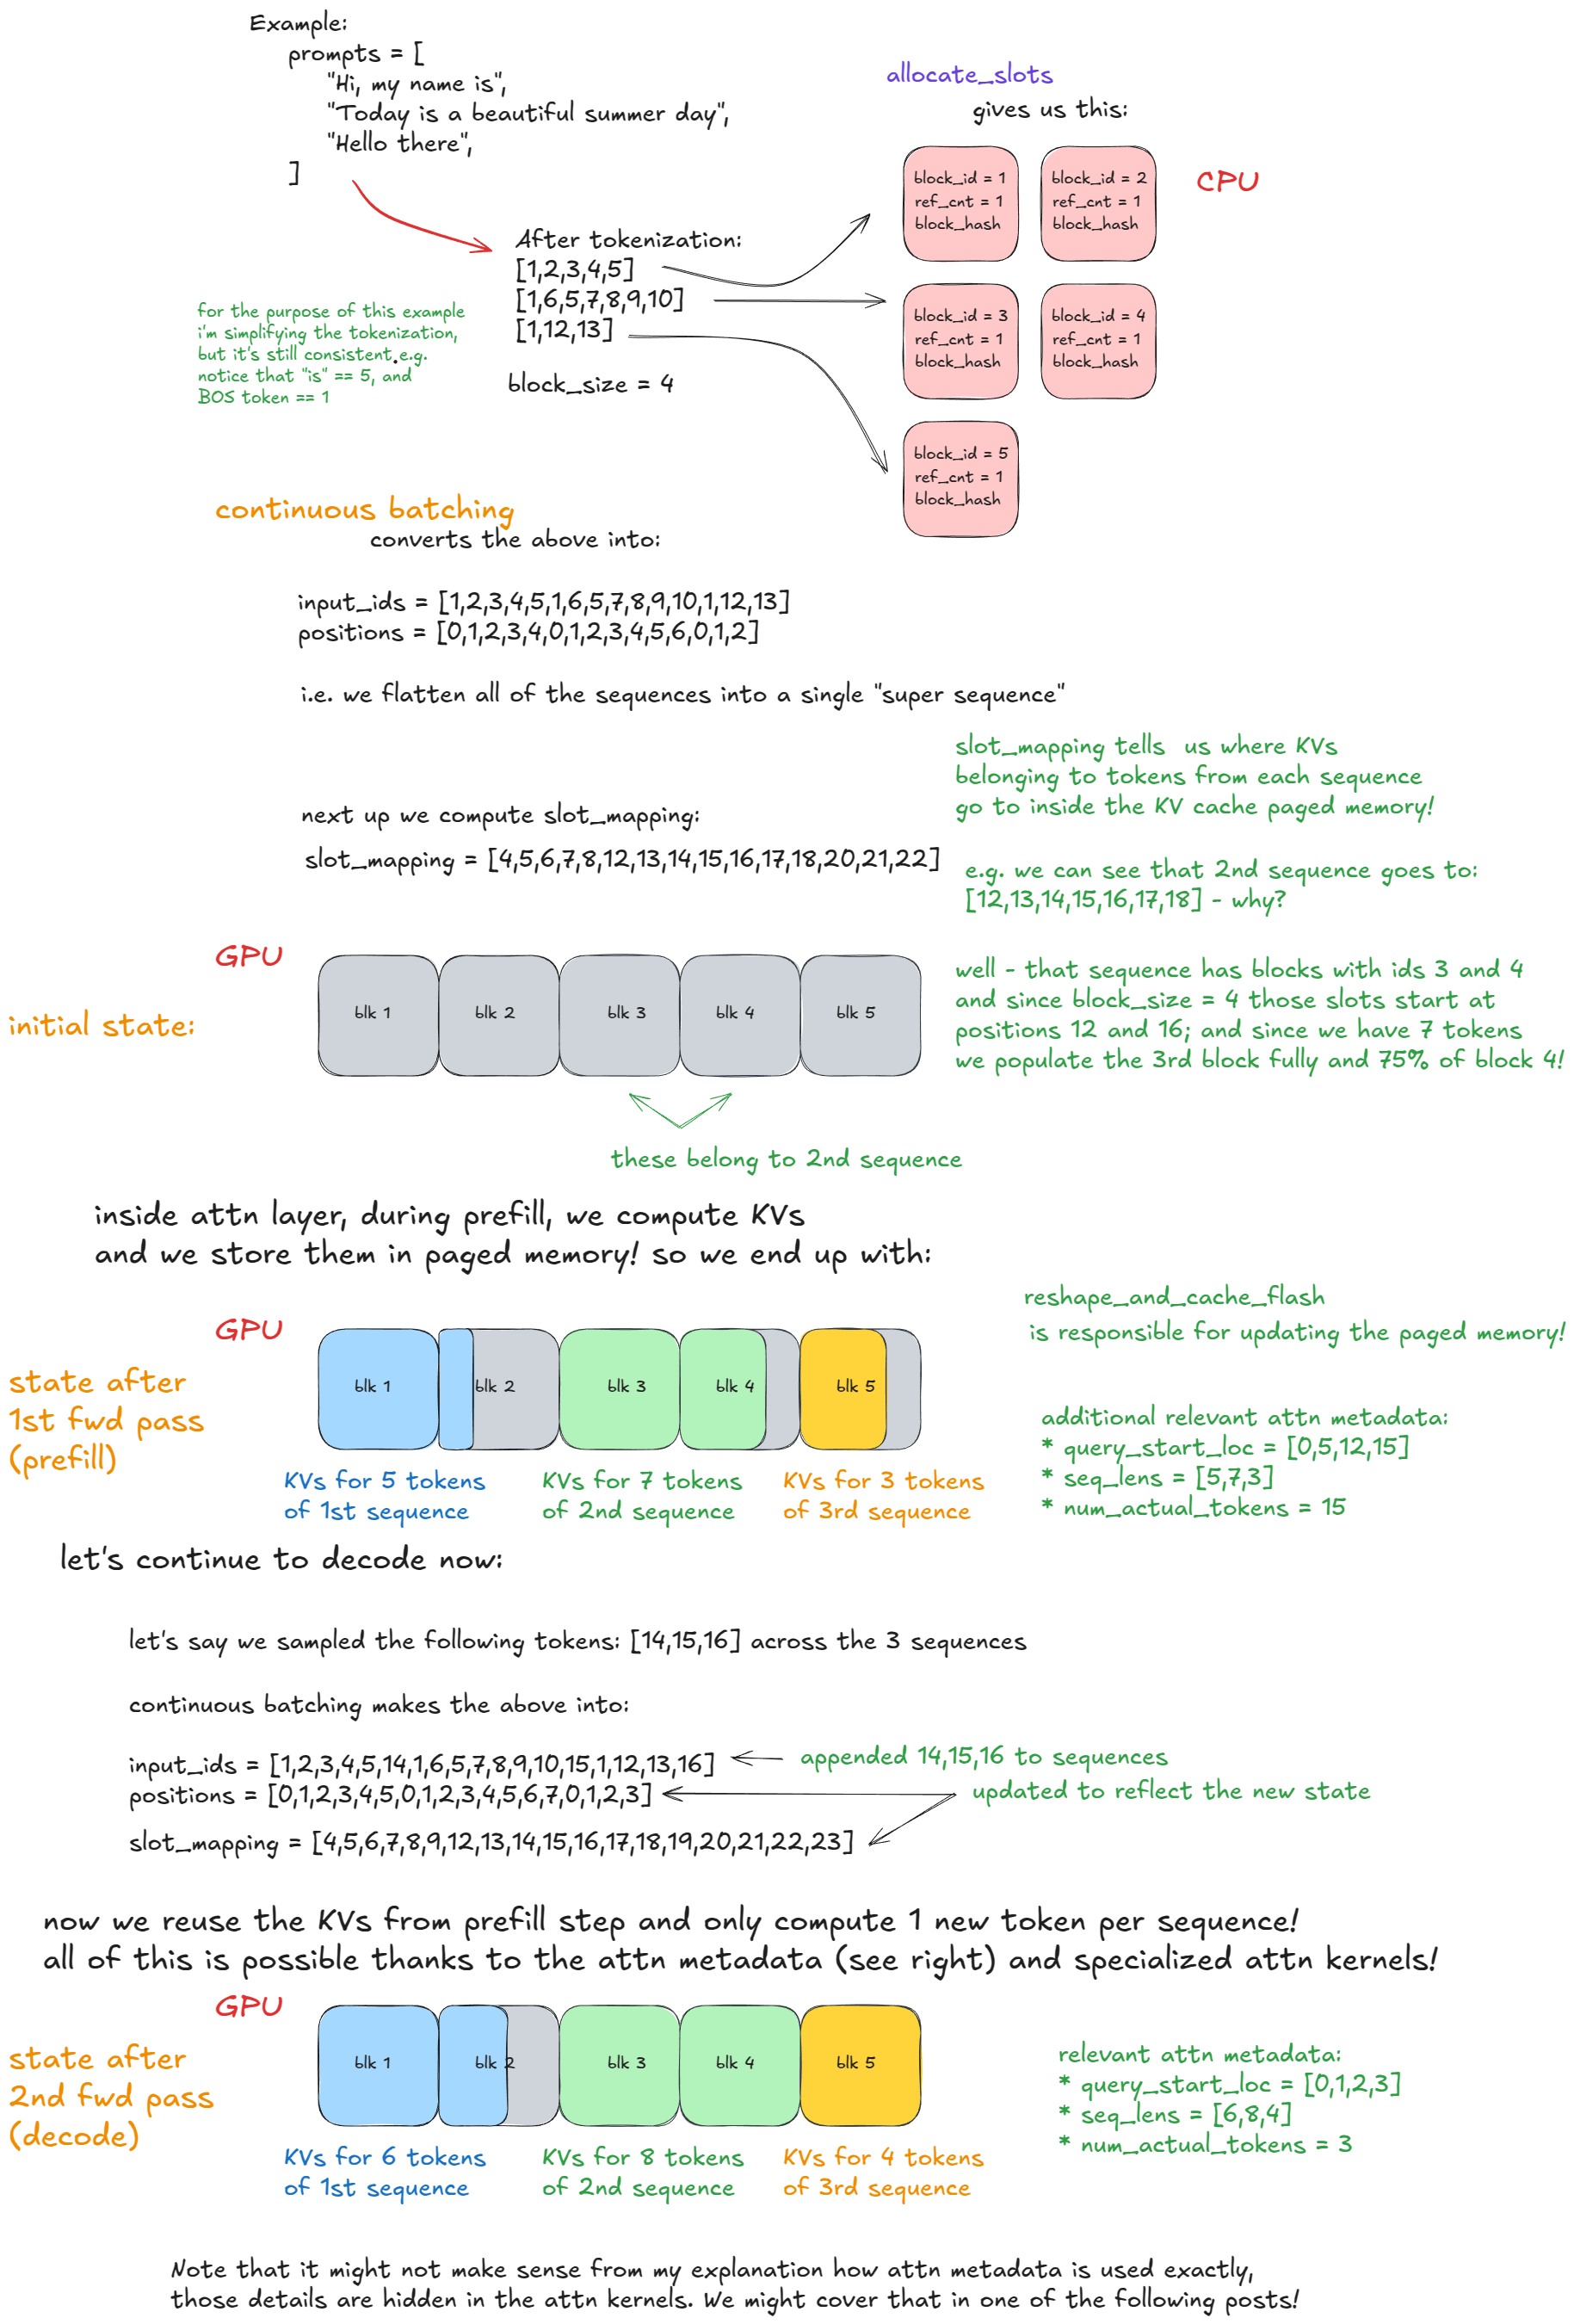 图 4:前向传播全貌:连续批处理(Continuous Batching)与 PagedAttention 显存寻址机制
第二部分:进阶特性——扩展核心引擎逻辑(Advanced Features)
在厘清了基础引擎的运转全貌之后,我们现在可以进一步探究构建工业级推理系统所必备的各项进阶特性:
- 分块预填充(Chunked prefill)
- 前缀缓存(Prefix caching)
- 引导式/结构化解码(Guided decoding,基于文法受限的有限状态机 FSM)
- 投机解码(Speculative decoding)
- 分离式 Prefill/Decode 架构(Disaggregated P/D)
分块预填充(Chunked prefill)
分块预填充(Chunked Prefill)是一种专门用于优雅处理超长 Prompt 的工程加速技术。它的核心做法是将单个巨型 Prompt 的 Prefill 阶段拆分为若干个更小的分块(Chunks)分步执行。如果不采用这种机制,一个极度冗长的请求可能会单方面霸占整张 GPU 的一个完整推理 Step,导致系统无法及时调度处理其他请求的 Prefill,更会导致存量 Decode 请求陷入长时间饥饿等待,从而造成极其严重的词间延迟(ITL)剧烈抖动与激增。
举个具体的例子:假定我们将每个分块设定为包含 n (=8) 个 Token。一个较长的输入序列 P 可以抽象表示为 x-y-z(其中 z 是最后一个不足一个完整 Block 的片段,例如仅有 2 个 Token)。那么完整执行完 P 的全部预填充计算将至少需要消耗 ≥ 3 个引擎 Step,并且只有在最后一个 Chunked Prefill Step 顺利计算完成后,系统才会首次采样输出第一个新 Token。
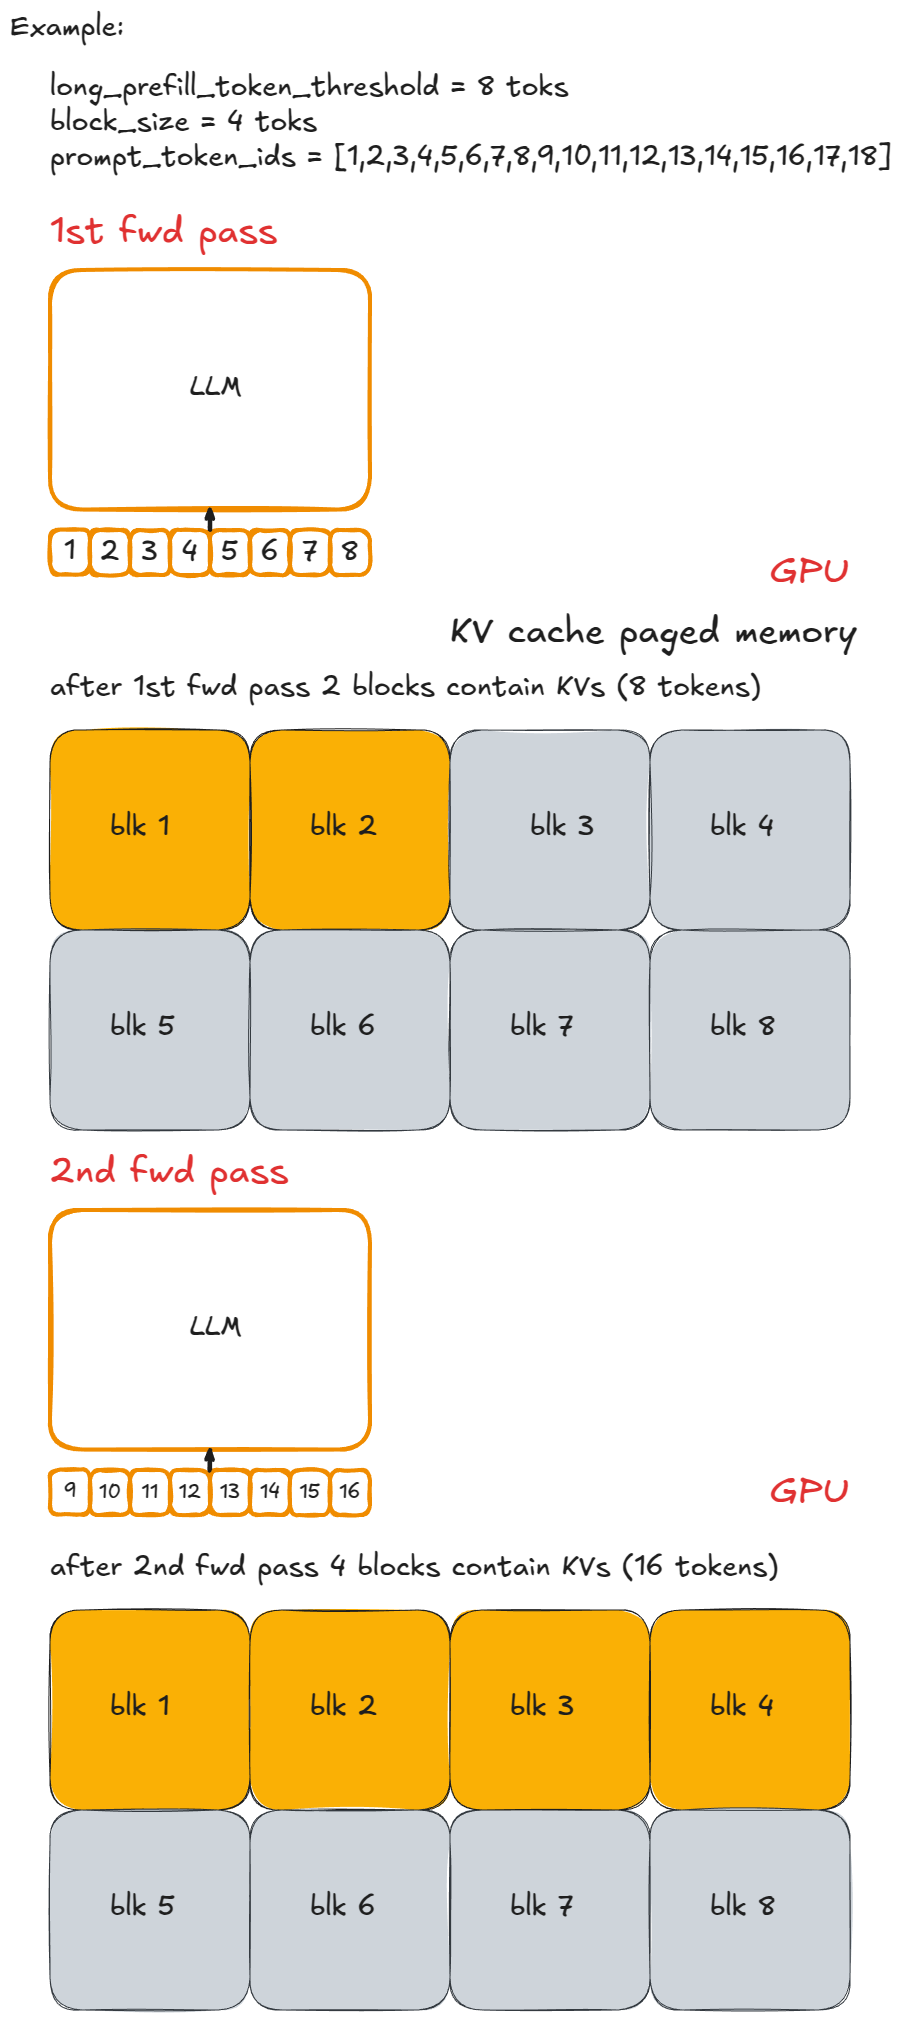 图 5:长 Prompt 分块预填充(Chunked Prefill)多步调度执行图解
其在代码层面的实现非常直接且简洁:系统对单个 Step 内允许处理的新 Token 数量设立了严格上限。如果某个请求当前轮次申请的待计算 Token 数超过了 long_prefill_token_threshold,调度器就会果断将其截断,强制重置为刚好等于该阈值的值。而底层的 KV Cache 分页寻址逻辑会自动负责追踪各分块的衔接计算。
在 vLLM V1 中,只需将 long_prefill_token_threshold 设定为一个正整数即可显式启用分块预填充。
前缀缓存(Prefix Caching)
为了直观说明前缀缓存的工作机制,让我们在最初的代码基础上做一点针对性的微调:
from vllm import LLM, SamplingParams

long_prefix = "<a piece of text that is encoded into more than block_size tokens>"

prompts = [
    "Hello, my name is",
    "The president of the United States is",
]

sampling_params = SamplingParams(temperature=0.8, top_p=0.95)

def main():
    llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0")

    outputs = llm.generate(long_prefix + prompts[0], sampling_params)
    outputs = llm.generate(long_prefix + prompts[1], sampling_params)

if __name__ == "__main__":
    main()
前缀缓存(Prefix Caching)的核心设计哲学非常朴素而有力:彻底避免在多个请求之间重复计算它们在开头所共享的相同 Token 序列——这部分共享的内容即称为前缀(Prefix)。
在这个例子中,至关重要的变量是 long_prefix:它被定义为任何长度超过一个 KV Cache 物理块大小(默认配置下为 16 个 Token)的公共文本。假定 long_prefix 的长度刚好严格等于 n x block_size(其中 n ≥ 1)。
对齐约束:块对齐要求 前缀必须能够与物理显存块的边界完全对齐——如果无法对齐,尾部剩余的
long_prefix_len % block_size个散碎 Token 依然必须重新计算,因为引擎出于显存管理与对齐效率考虑,不允许对未写满的半残 Block 进行跨请求共享。
没有前缀缓存时,每次处理携带相同 long_prefix 的新请求,都必须将这 n x block_size 个 Token 的所有层注意力矩阵乘法重新计算一遍。开启前缀缓存后,这些公共 Token 首次计算后会被缓存在显存中,后续请求直接复用物理块,使得 Prefill 耗时发生数量级锐减。
在 vLLM 内部,调度器通过 hash_request_tokens 实现这一逻辑:
- 将
long_prefix + prompts[0]按 16 个 Token 切分成若干 Chunk; - 逐 Chunk 计算哈希,混编前一个 Block 的哈希、当前 Token 列表及可选元数据(MM Hash、LoRA ID、Cache Salt);
- 生成
BlockHash对象链表,并登记在self.req_to_block_hashes[request_id]中。
首次请求时,find_longest_cache_hit 未命中任何缓存:
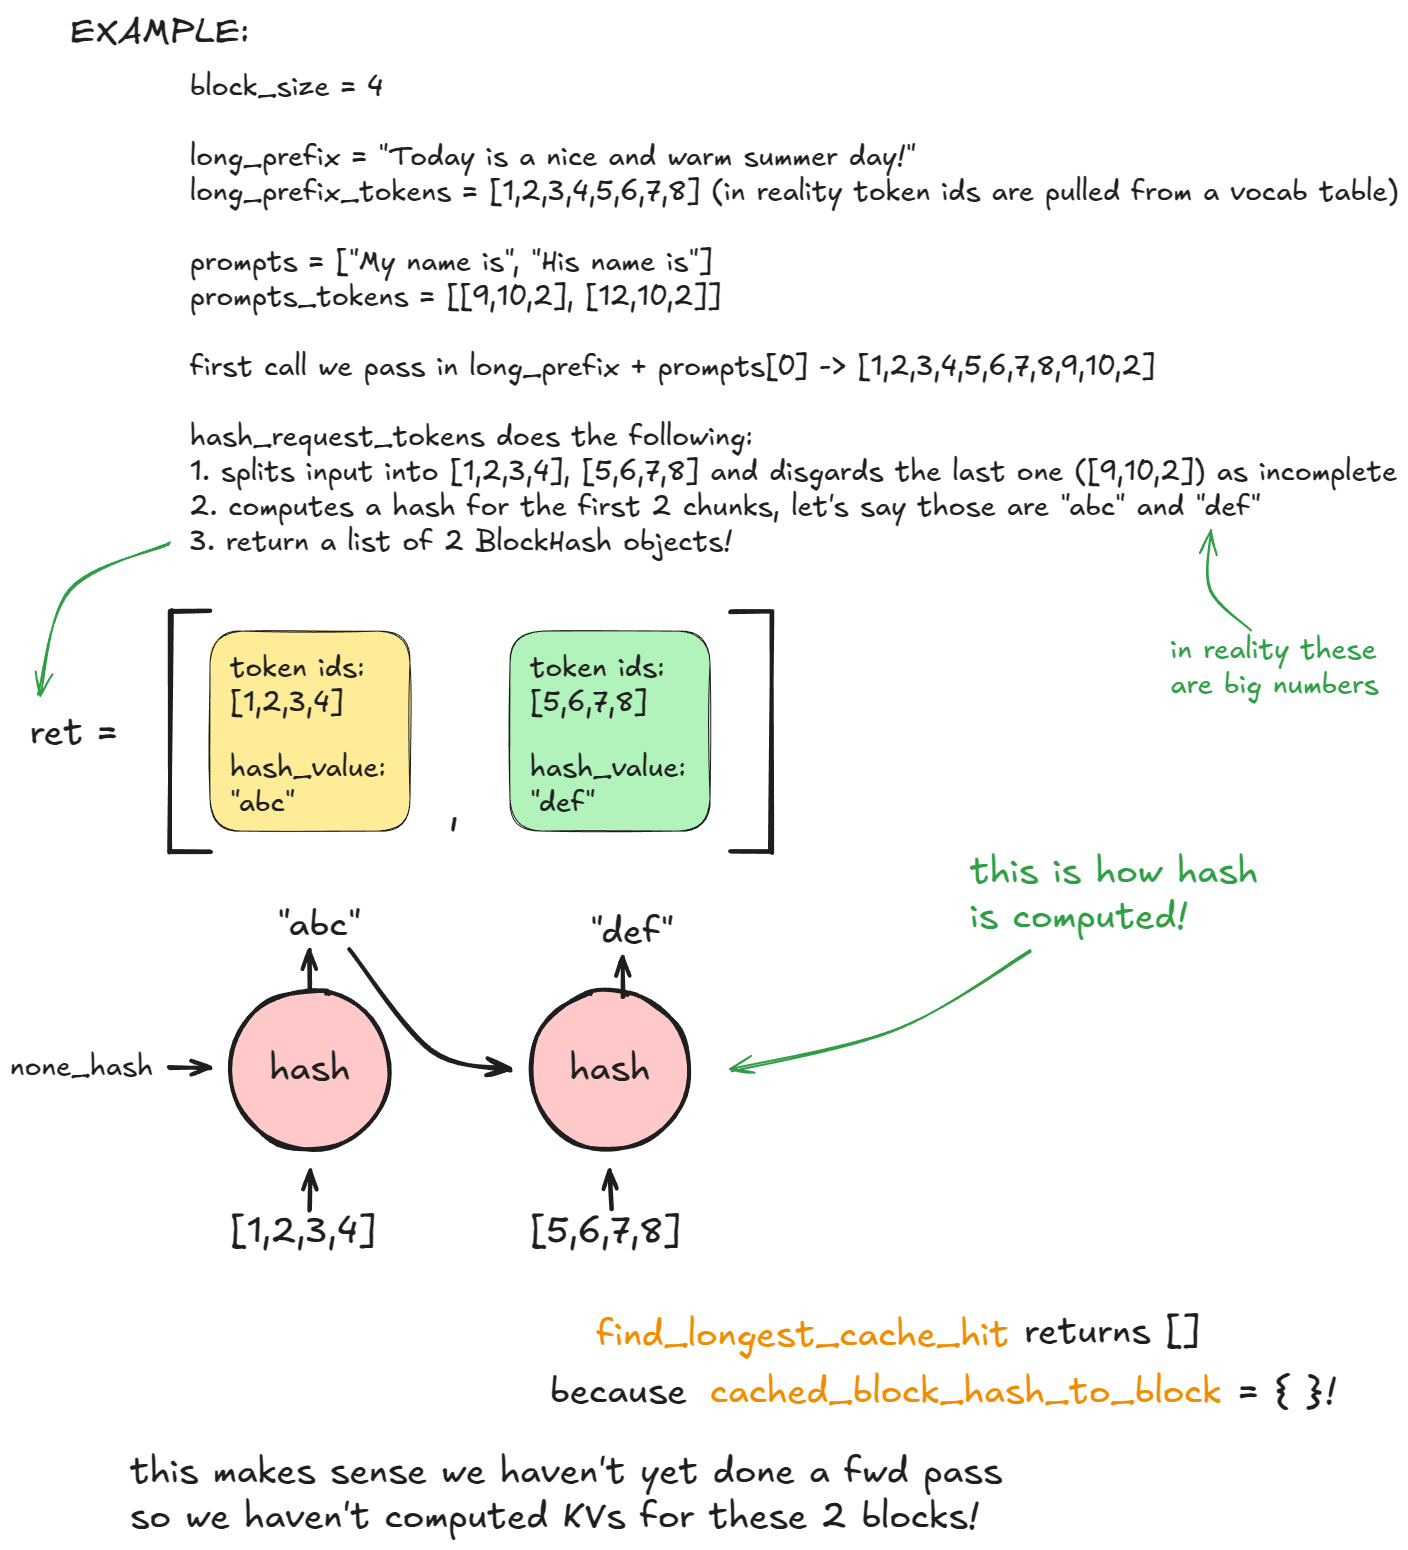 图 6:前缀缓存运作逻辑阶段一:首次请求计算哈希并检测缓存未命中
随后,allocate_slots 触发 coordinator.cache_blocks,将 BlockHash 与分配的物理块登记在全局映射表 cached_block_hash_to_block 中,前向计算将 KV 数据写入显存:
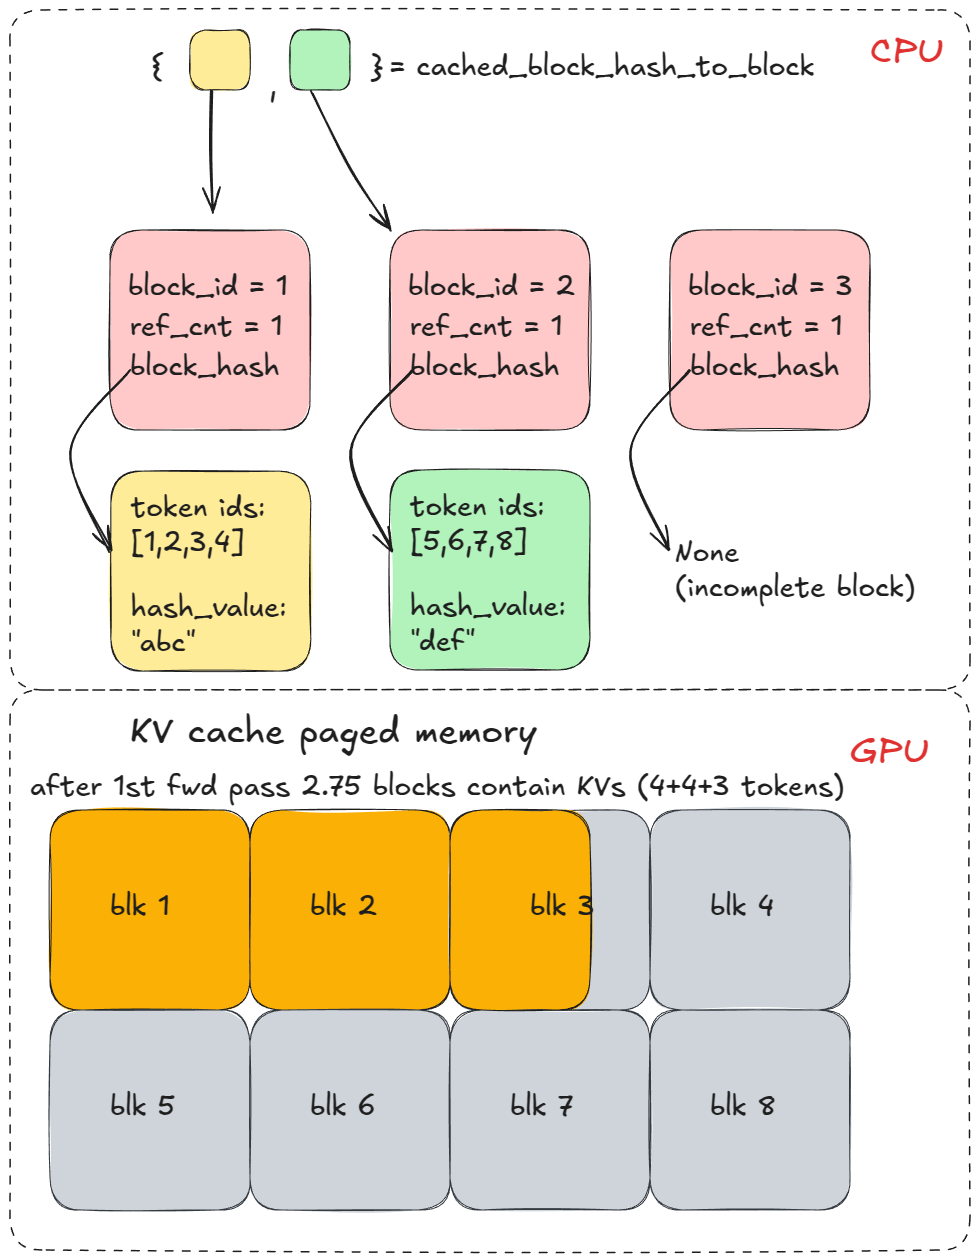 图 7:前缀缓存运作逻辑阶段二:前向计算完成后将物理块登记绑定至全局映射表
当携带相同前缀的第二个请求到达时,find_longest_cache_hit 成功匹配全部 n 个物理块,直接复用已有显存,无需重复计算:
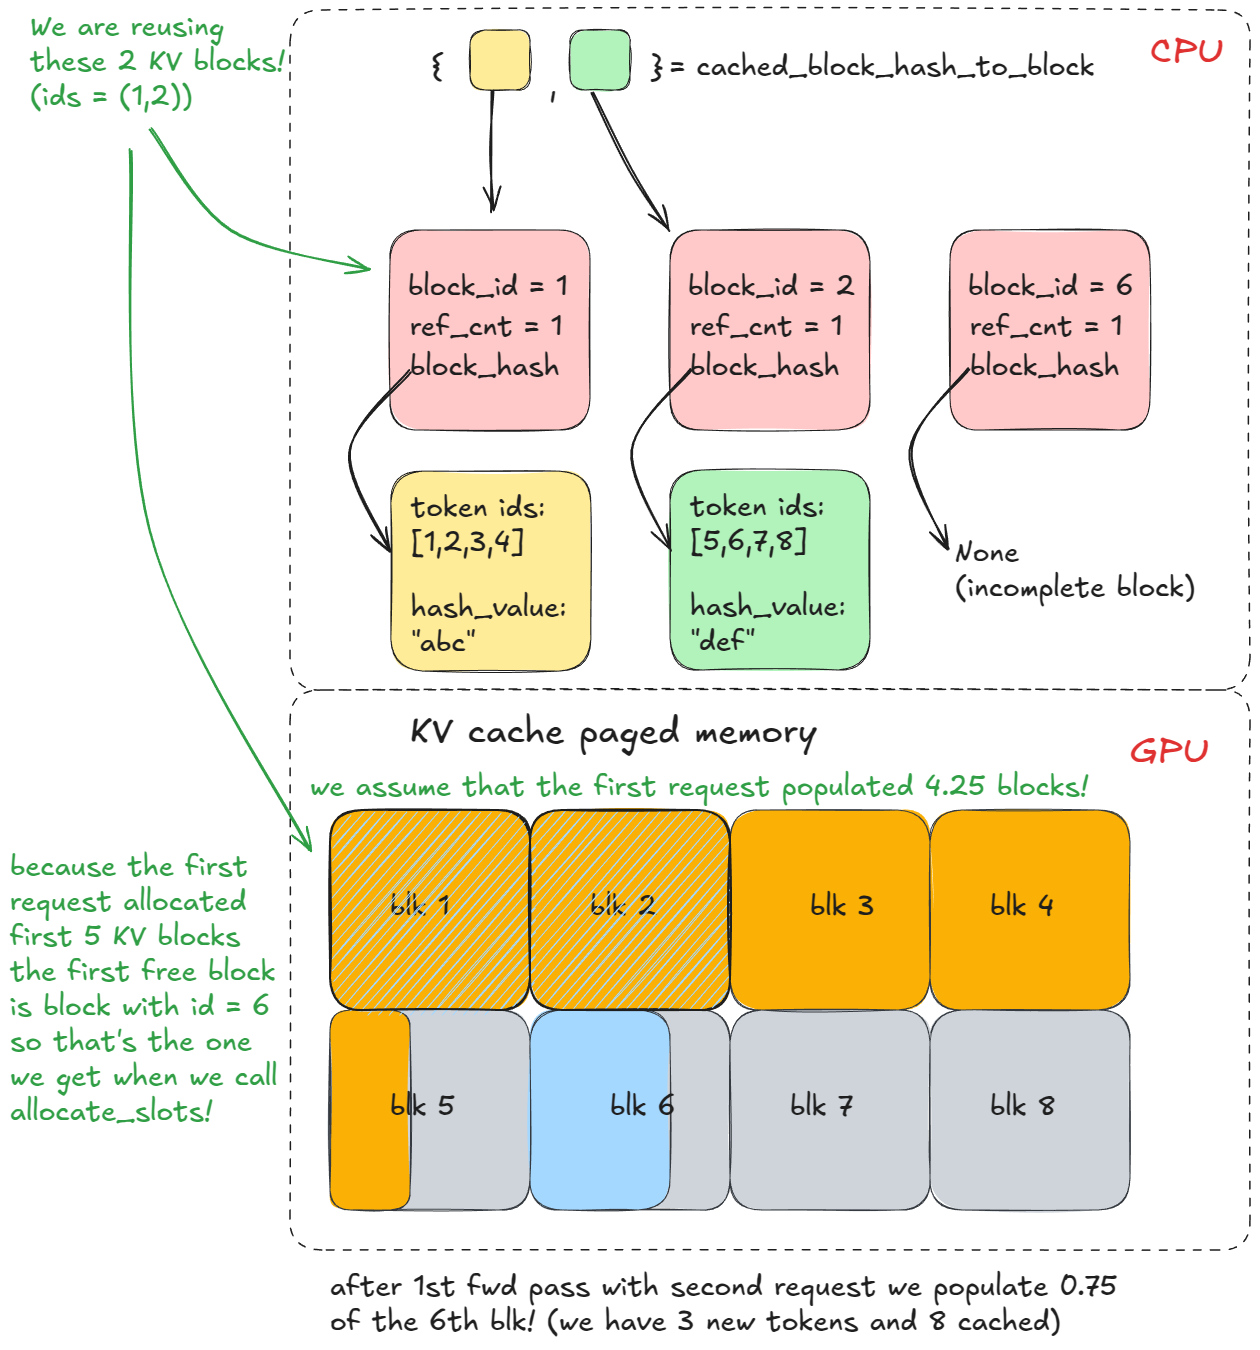 图 8:前缀缓存运作逻辑阶段三:后续请求精准命中哈希并直接复用已有物理块
机制说明:缓存失效机制 已缓存的 KV Cache 物理块只有在全局显存极度紧张、新的请求被迫从
free_block_queue头部弹出该块重新分配时,才会清除其哈希并从全局映射表中剔除,确保陈旧数据绝不会被错误复用。
引导式/结构化解码(Guided Decoding / FSM)
引导式解码(Guided Decoding)通过基于文法的有限状态机(FSM)对输出 Logits 施加严格数学约束,从概率层面 100% 确保大模型只能采样出符合特定文法规则的 Token。
无论是正则表达式(Chomsky 3 型)还是上下文无关文法(CFG,Chomsky 2 型,如 JSON Schema 或代码语法树),都可以完美受限执行:
from vllm import LLM, SamplingParams
from vllm.sampling_params import GuidedDecodingParams

prompts = [
    "This sucks",
    "The weather is beautiful",
]

guided_decoding_params = GuidedDecodingParams(choice=["Positive", "Negative"])
sampling_params = SamplingParams(guided_decoding=guided_decoding_params)

def main():
    llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0")

    outputs = llm.generate(prompts, sampling_params)

if __name__ == "__main__":
    main()
架构说明:高性能后端 文法编译与状态机转移主要由第三方高性能库(如 XGrammar [7])在底层高效驱动。
预处理器预先构建有限状态机(FSM):
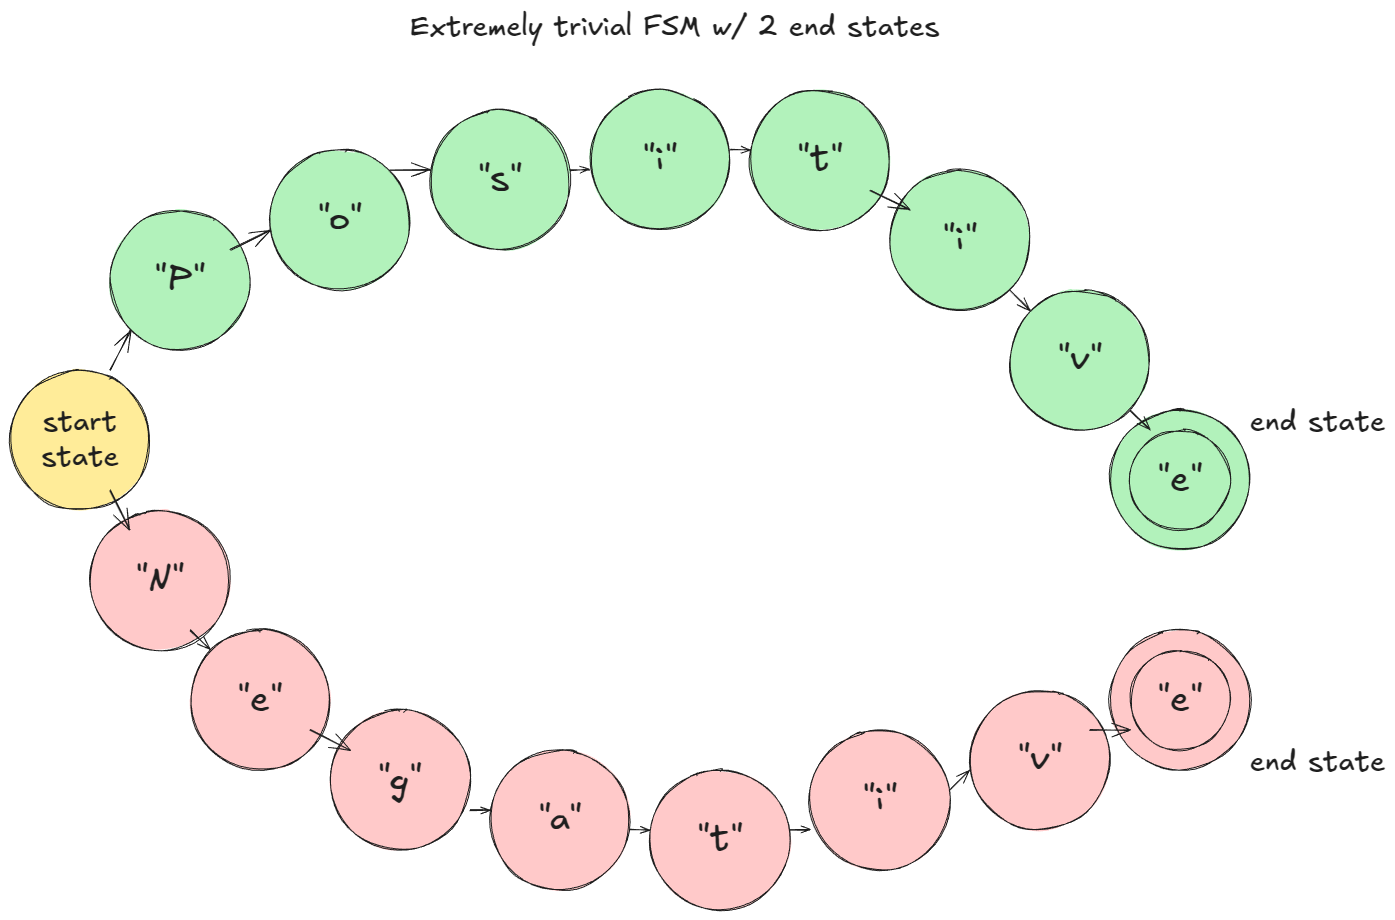 图 9:结构化引导解码玩具示例:状态机转移图(FSM)
在每个 Step 中,根据当前 FSM 状态查询合法 Token 集合,构建词表位掩码(Bitmask),并在 Softmax 前将非法 Token 的 Logits 强制置为 -inf:
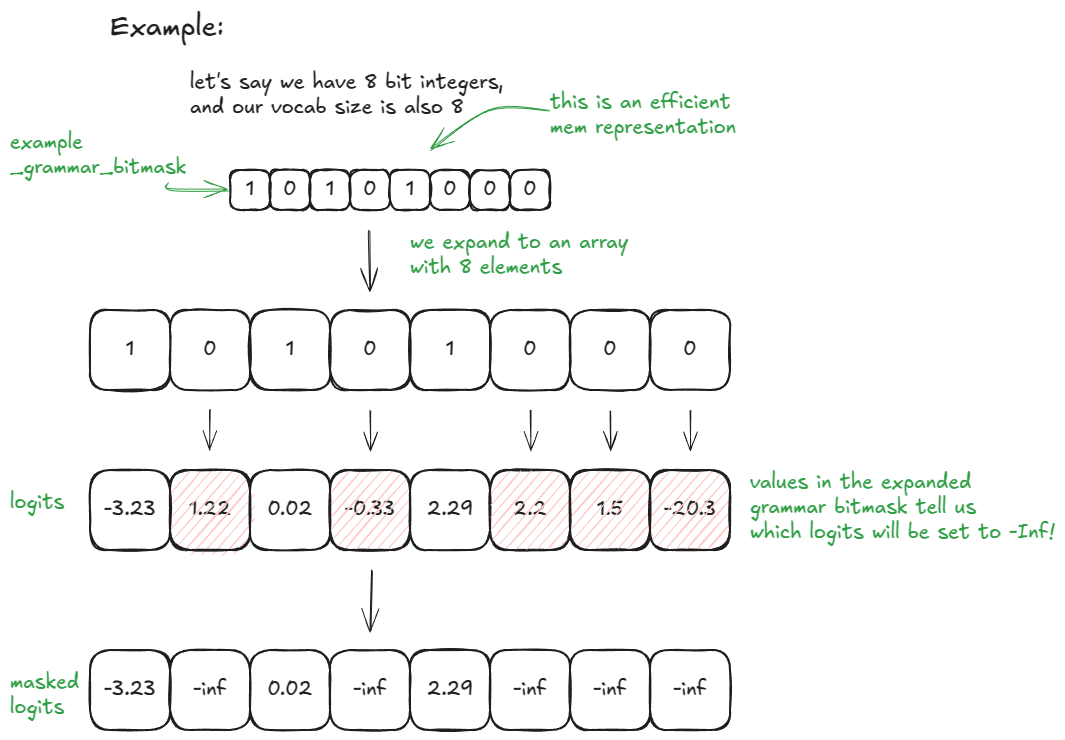 图 10:词表位掩码(Bitmask)在 Logits 上的屏蔽与过滤机制
投机解码(Speculative Decoding)
针对 Decode 阶段严峻的显存带宽瓶颈,投机解码通过小巧高速的草稿机制(Draft Mechanism)快速推测出未来 K 个候选 Token,随后由 Target 大模型执行单步并行打分验证(Verification),并通过拒绝采样(Rejection Sampling)无损决定接受长度:
from vllm import LLM, SamplingParams

prompts = [
    "Hello, my name is",
    "The president of the United States is",
]

sampling_params = SamplingParams(temperature=0.8, top_p=0.95)

speculative_config={
    "method": "ngram",
    "prompt_lookup_max": 5,
    "prompt_lookup_min": 3,
    "num_speculative_tokens": 3,
}

def main():
    llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0", speculative_config=speculative_config)

    outputs = llm.generate(prompts, sampling_params)

if __name__ == "__main__":
    main()
整个过程分为两个阶段:
- 起草阶段(Drafting stage):快速产出 K 个候选 Token:
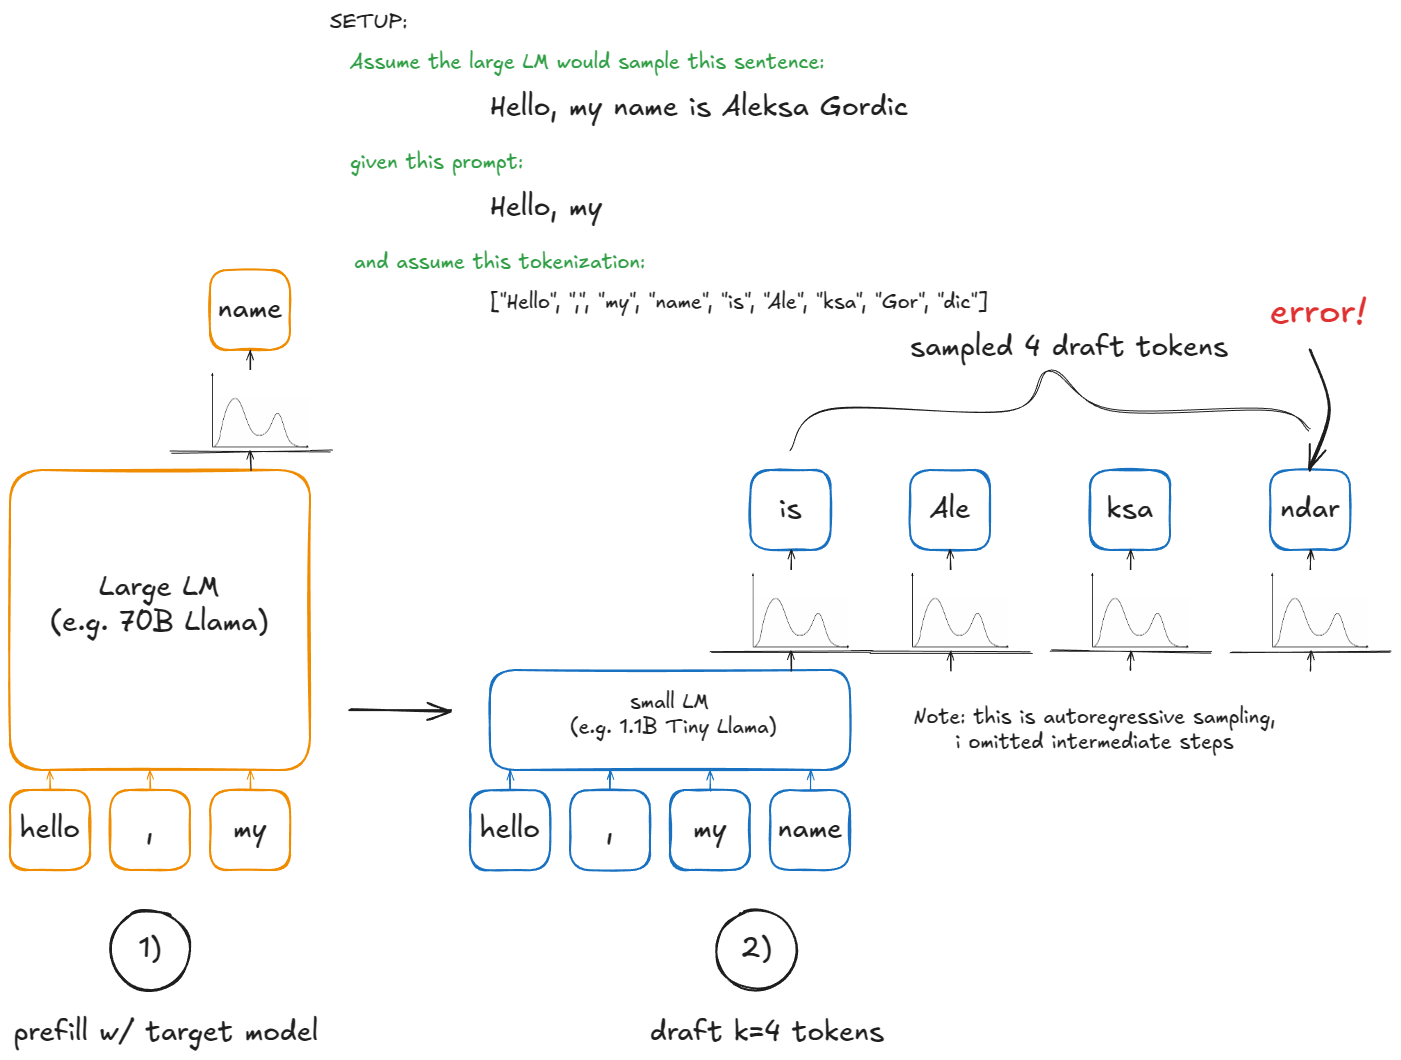 图 11:投机解码起草阶段:Draft 机制快速生成 K 个连续候选 Token
- 验证与拒绝采样阶段(Verification & Rejection sampling stage):Target 模型单次并行计算打分,按
p_accept = min(1.0, P_target(x) / P_draft(x))决定接受长度:
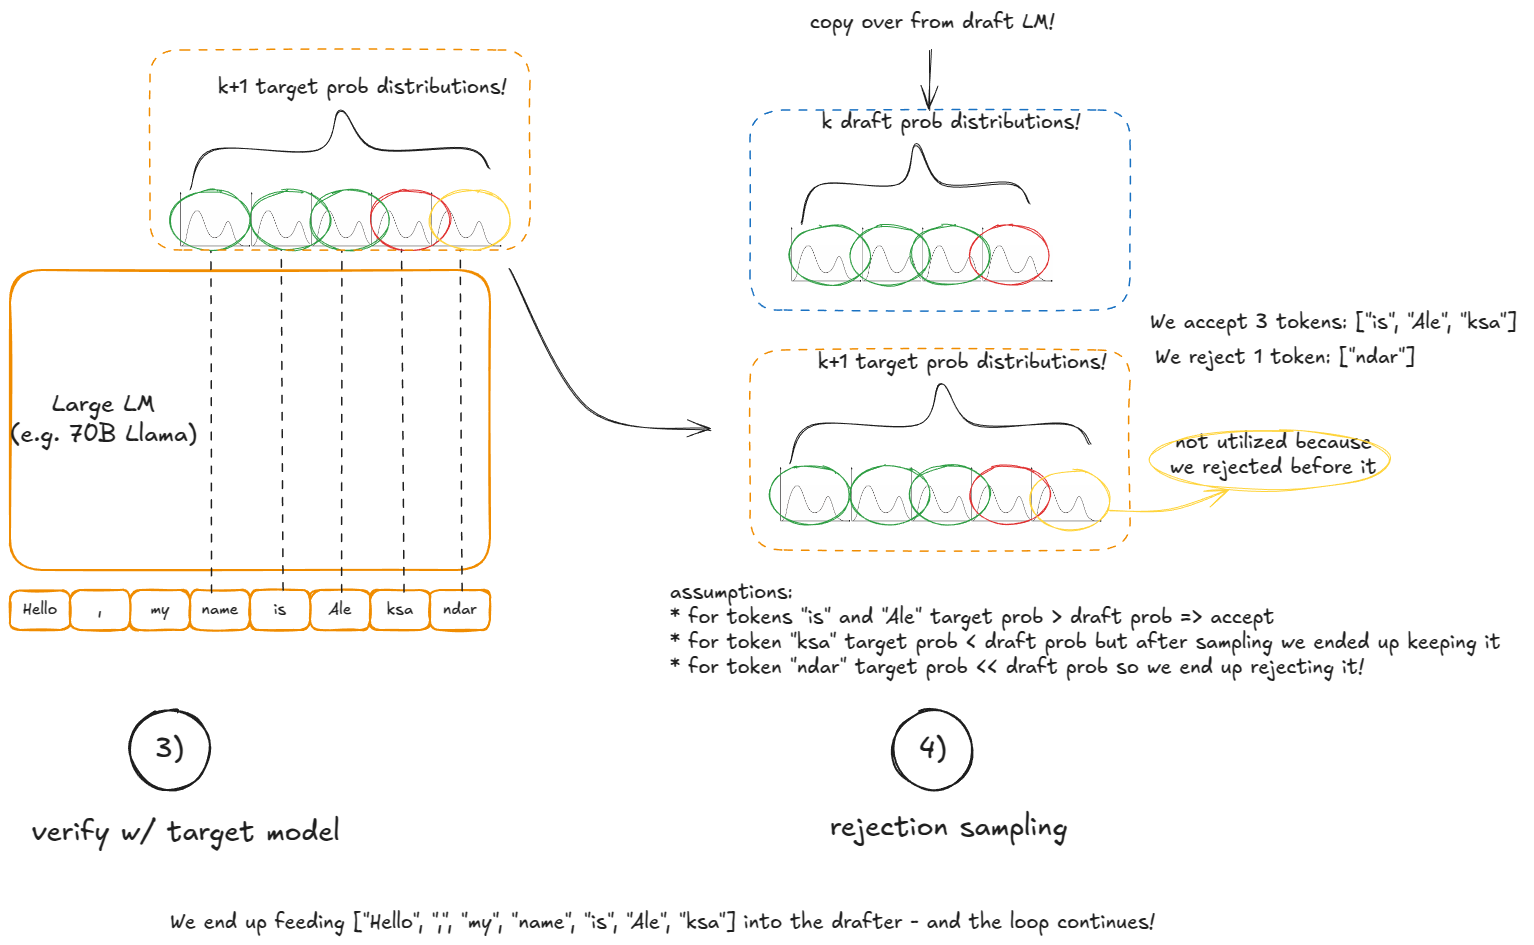 图 12:验证与拒绝采样阶段:Target 模型单次并行打分并确定最终接受长度
主流草稿生成方案:
分离式 Prefill/Decode 架构(Disaggregated P/D)
传统混部模式下,算力密集的 Prefill 与带宽密集的 Decode 相互争抢资源,引发严重的尾延迟抖动。分离式 P/D 架构将集群物理划分为专精 Prefill 的节点池与专精 Decode 的节点池,各自按需独立伸缩与调度:
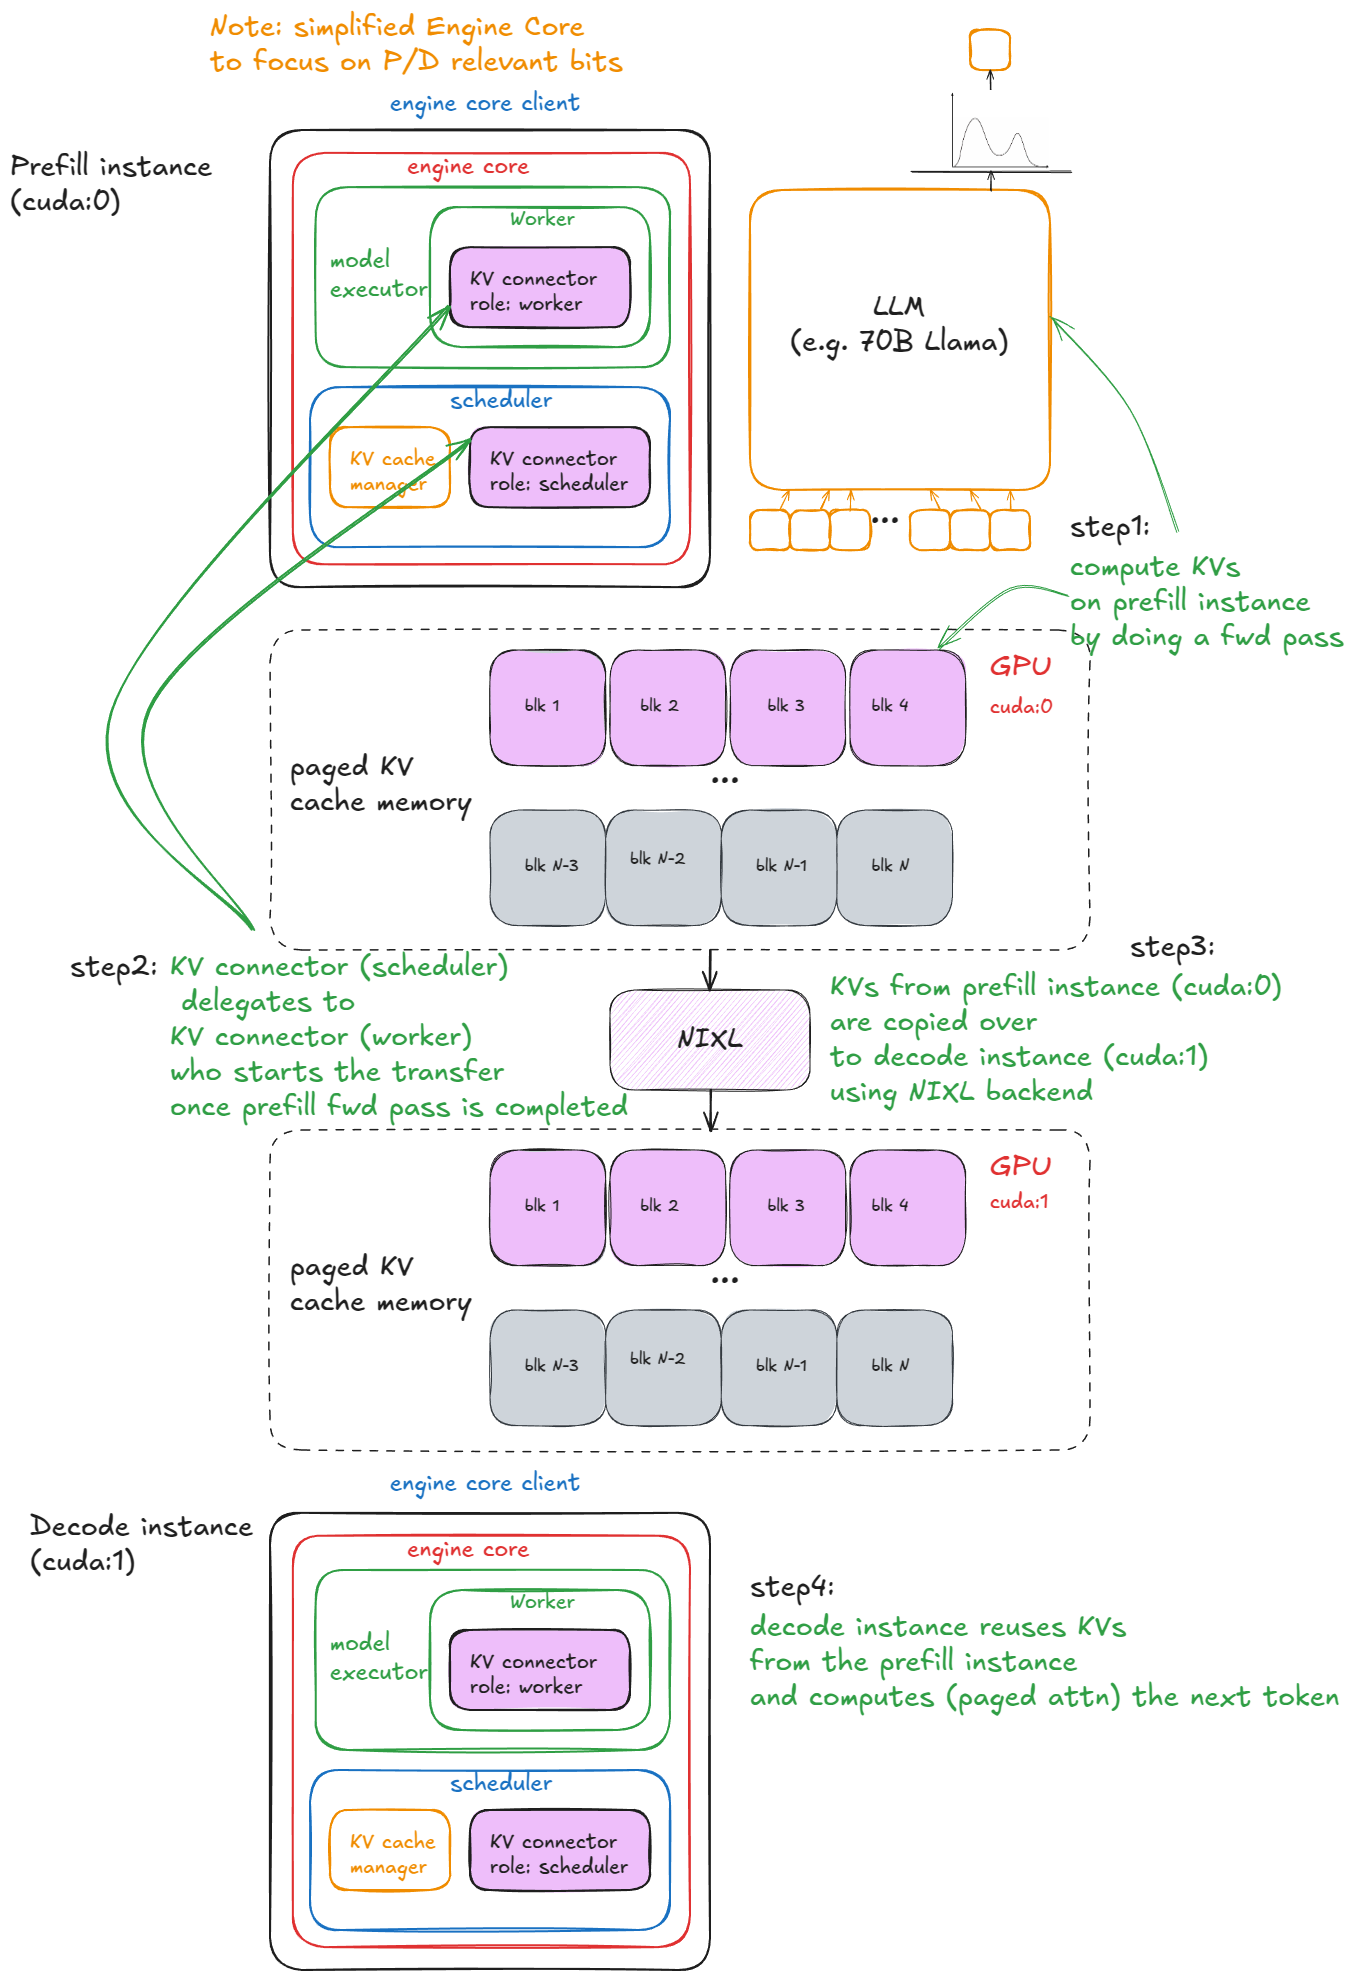 图 13:计算分离式 P/D 架构服务拓扑图解(Disaggregated Prefill and Decode)
跨节点 KV Cache 传输通过 KVTransferConfig 与 Connector 抽象实现:
import os
import time
from multiprocessing import Event, Process
import multiprocessing as mp

from vllm import LLM, SamplingParams
from vllm.config import KVTransferConfig

prompts = [
    "Hello, my name is",
    "The president of the United States is",
]

def run_prefill(prefill_done):
  os.environ["CUDA_VISIBLE_DEVICES"] = "0"

  sampling_params = SamplingParams(temperature=0, top_p=0.95, max_tokens=1)

  ktc=KVTransferConfig(
      kv_connector="SharedStorageConnector",
      kv_role="kv_both",
      kv_connector_extra_config={"shared_storage_path": "local_storage"},
  )

  llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0", kv_transfer_config=ktc)
  llm.generate(prompts, sampling_params)

  prefill_done.set()  # 通知 Decode 实例 KV cache 已就绪

  # 保持 Prefill 进程存活,防止提前退出导致传输中断
  try:
      while True:
          time.sleep(1)
  except KeyboardInterrupt:
      print("Script stopped by user.")

def run_decode(prefill_done):
  os.environ["CUDA_VISIBLE_DEVICES"] = "1"

  sampling_params = SamplingParams(temperature=0, top_p=0.95)

  ktc=KVTransferConfig(
      kv_connector="SharedStorageConnector",
      kv_role="kv_both",
      kv_connector_extra_config={"shared_storage_path": "local_storage"},
  )

  llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0", kv_transfer_config=ktc)

  prefill_done.wait()  # 阻塞等待 Prefill 实例传输 KV cache

  # 内部首先从共享通道拉取 KV cache,随后启动解码循环
  outputs = llm.generate(prompts, sampling_params)

if __name__ == "__main__":
  prefill_done = Event()
  prefill_process = Process(target=run_prefill, args=(prefill_done,))
  decode_process = Process(target=run_decode, args=(prefill_done,))

  prefill_process.start()
  decode_process.start()

  decode_process.join()
  prefill_process.terminate()
演进说明:传输方案 工业界实践涵盖 LMCache [11]、基于 RDMA 的
PyNcclConnector以及 Mooncake 等高性能低延迟网络连接器。
第三部分:纵向扩展——从 UniProcExecutor 到 MultiProcExecutor(Scaling Up)
当模型权重超出单卡显存时,系统需引入张量并行(Tensor Parallelism, TP)与流水线并行(Pipeline Parallelism, PP)。由于节点内 NVLink 带宽显著高于跨节点网络带宽,单机内部始终优先采用 TP。
此时,单机单卡执行器升级为 MultiProcExecutor(多进程执行器):
- 为每个 GPU 卡派生独立的
Worker操作系统进程; - Rank 0 为主控者(Driver Worker):常驻主进程,负责与调度器通信;
- Rank 1 ~ N-1 为非 Driver Workers:在后台无头运行,通过 NCCL 算子与 Driver Worker 保持硬件级同步运算。
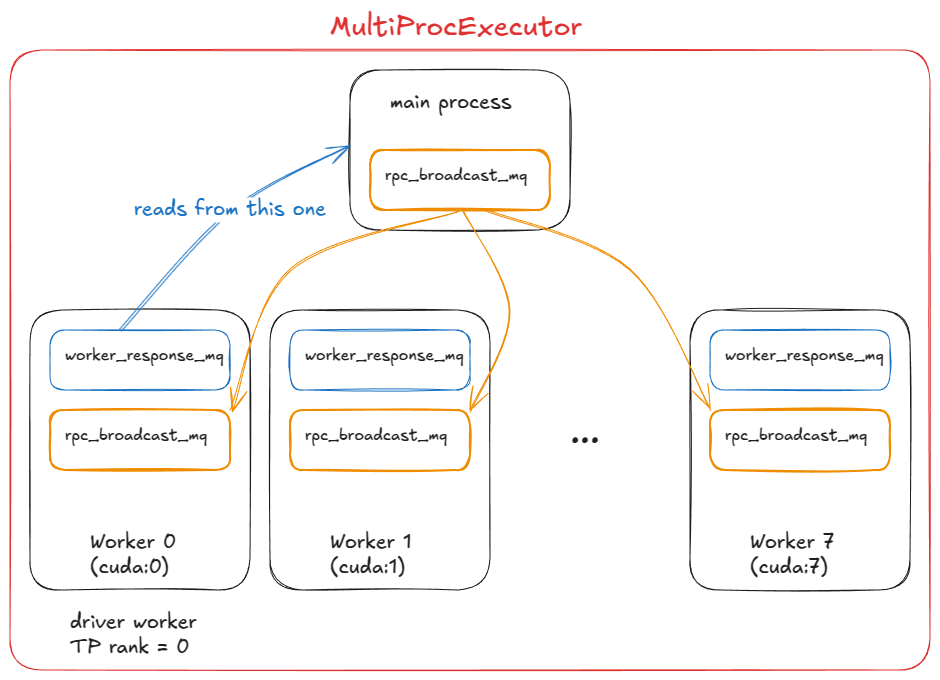 图 14:MultiProcExecutor 在单机 8 卡 TP=8 配置下的多进程协作拓扑(Rank 0 为主控 Driver Worker)
第四部分:服务层——分布式服务系统架构(Serving Layer)
生产级集群典型拓扑:2 台服务器,每台配备 8 张 NVIDIA H100(共 16 张 H100),部署配置为 TP=4, DP=4:
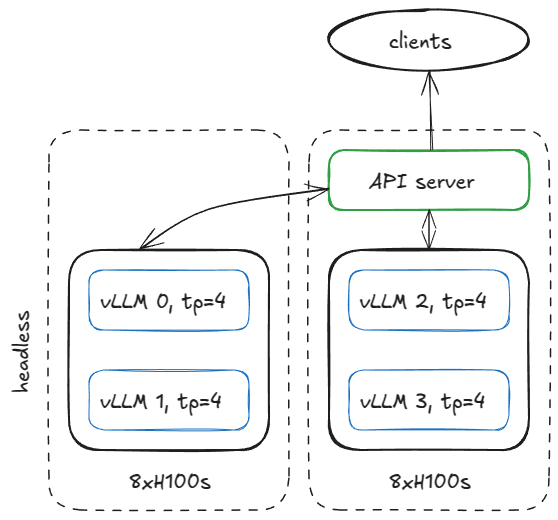 图 15:双机 16 张 H100 拓扑配置:1 台无头计算节点 + 1 台 API 主控服务节点(TP=4, DP=4)
- 无头服务节点(Headless Node):承载 DP 0 与 DP 1,纯后台算力节点;
- API 服务主控节点(API Server Node):承载 DP 2 与 DP 3,同时运行全局 Web 网关与负载均衡器。
无头节点启动命令:
vllm serve <model-name> --tensor-parallel-size 4 --data-parallel-size 4 --data-parallel-size-local 2 --data-parallel-start-rank 0 --data-parallel-address <master-ip> --data-parallel-rpc-port 13345 --headlessAPI 主控节点启动命令:
vllm serve <model-name> --tensor-parallel-size 4 --data-parallel-size 4 --data-parallel-size-local 2 --data-parallel-start-rank 2 --data-parallel-address <master-ip> --data-parallel-rpc-port 13345无头服务节点(Headless Server Node)的处理流程
无头节点上为每个本地 DP 副本派生一个 DPEngineCoreProc 进程:
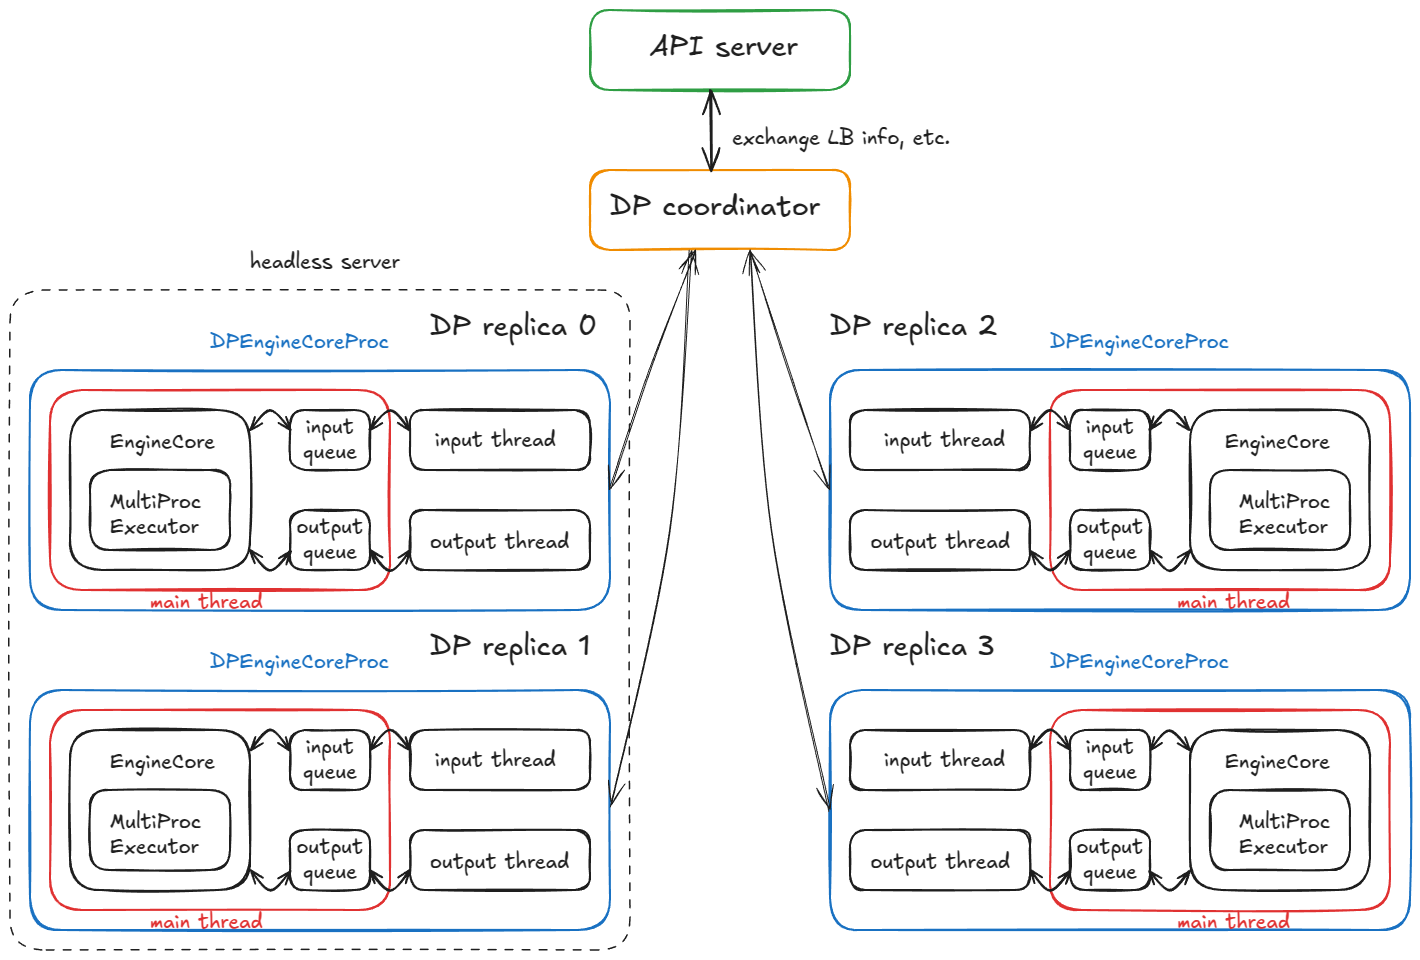 图 16:分布式推理架构全景:4 个数据并行副本各自运行独立的 DPEngineCoreProc 进程
每个进程封装完整的调度器与 MultiProcExecutor,通过 RPC 监听主控节点指令并驱动本地 4 张 GPU 执行计算并回传结果。
API 服务节点(API Server Node)的处理流程
对外暴露兼容 OpenAI 标准的 HTTP API:
curl -X POST http://localhost:8000/v1/completions   -H "Content-Type: application/json"   -d '{
    "model": "TinyLlama/TinyLlama-1.1B-Chat-v1.0",
    "prompt": "The capital of France is",
    "max_tokens": 50,
    "temperature": 0.7
  }'
内部核心枢纽 DPLBAsyncMPClient 负责:
- 请求接入与 Tokenize 预处理;
- 动态负载均衡:追踪全集群 4 个 DP 副本的队列深度,按 Least-busy 或轮询策略精准路由;
- 异步流式回传:实时接收增量 Token,执行 Detokenize 并通过 HTTP SSE 实时推送到客户端。
第五部分:基准测试与自动调优——延迟 vs 吞吐量(Benchmarks & Auto-Tuning)
大模型服务核心指标体系:
| 核心度量指标(Metric) | 工业级技术定义与数学说明(Definition) |
|---|---|
TTFT(Time To First Token / 首字延迟) | 从请求提交到首次收到大模型生成的第一个输出 Token 的耗时,主要反映 Prefill 计算耗时与排队等待时间。 |
ITL(Inter-Token Latency / 词间延迟) | 连续两个输出 Token 之间的时间间隔,决定打字机流式输出的顺滑度。 |
TPOT(Time Per Output Token / 单词平均耗时) | 请求中所有输出 Token 的 ITL 算术平均值:(总耗时 - TTFT) / 生成 Token 总数。 |
Latency / E2E(端到端完整延迟) | 处理并完成请求的总物理耗时:TTFT + sum(所有 ITL)。 |
Throughput(系统吞吐量) | 单位时间内成功处理交付的 Tokens 数量(Tokens/s)或请求数量(RPS)。 |
Goodput(有效吞吐量) | 严格满足预设 SLO 服务质量约束(如 TTFT < 500ms 且 ITL < 30ms)的有效吞吐量。 |
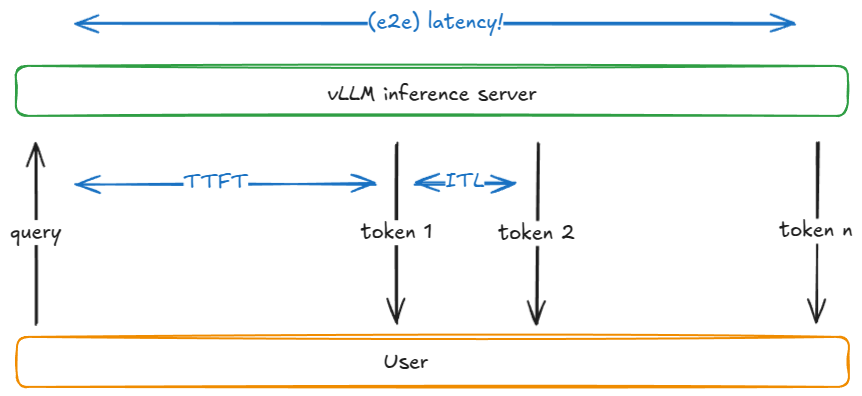 图 17:大模型交互响应的关键延迟指标拆解:TTFT、ITL 与端到端 E2E 延迟时序图
GPU 性能 Roofline 模型
横轴为计算强度(Arithmetic Intensity,FLOPs / Byte),纵轴为硬件实际计算性能(TFLOPs/s):
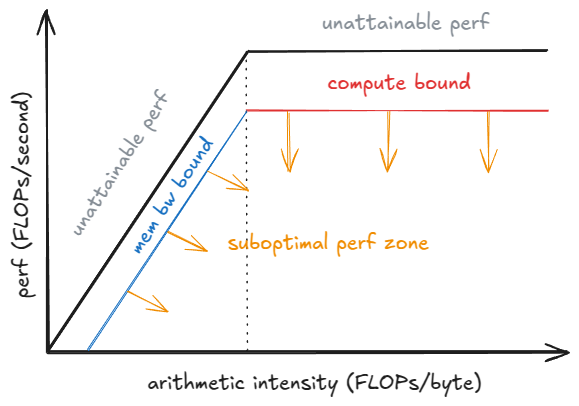 图 18:GPU 性能 Roofline 模型:显存带宽瓶颈斜线与硬件算力天花板
- 小 Batch Size(如 B=1):每生成 1 个词需将整量模型参数从 HBM 读出,计算强度极低,落入陡峭的显存带宽受限区(Memory-bandwidth bound),Tensor Core 严重闲置;
- 增大 Batch Size B:同一批次内的 B 个请求共享权重矩阵,单次访存分摊的浮点计算呈线性倍增,计算强度不断右移;
- 跃迁至算力受限区(Compute-bound):最终达到硬件算力天花板,系统总吞吐量达到极限!
如何在 vLLM 中进行基准测试
测量特定模型物理极限延迟:
vllm bench latency --model <model-name> --input-tokens 32 --output-tokens 128 --batch-size 8测量在线集群高并发服务吞吐:使用 vllm bench serve 模拟真实世界的泊松分布流量,自动化扫描并绘制端到端吞吐-延迟响应曲线。
结语(Epilogue)
至此,我们完成了对现代化高吞吐大模型推理系统 vLLM 的全景式架构剖析:
- 以 PagedAttention 征服显存碎片;
- 以 连续批处理 打破静态 Batch 桎梏;
- 以 前缀缓存 彻底消除重复上下文算力开销;
- 以 投机解码 突破自回归串行解码带宽瓶颈;
- 以 分离式 P/D 架构 与多机多卡分布式网络实现工业级弹性伸缩。
致谢(Acknowledgements)
衷心感谢 Hyperstack 在过去一年中为我提供海量的 NVIDIA H100 GPU 算力集群支持!
由衷感谢 Nick Hill(vLLM 核心贡献者,Red Hat)、Mark Saroufim(PyTorch 核心团队)、Kyle Krannen(NVIDIA Dynamo 团队)以及 Ashish Vaswani(《Attention Is All You Need》第一作者)审阅本文预发布版本并提供宝贵建议!
参考文献(References)
- vLLM: Easy, fast, and cheap LLM serving for everyone - GitHub Repository, https://github.com/vllm-project/vllm
- Attention Is All You Need - Vaswani et al., 2017, https://arxiv.org/abs/1706.03762
- Efficient Memory Management for Large Language Model Serving with PagedAttention - Kwon et al., SOSP 2023, https://arxiv.org/abs/2309.06180
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model - DeepSeek-AI, 2024, https://arxiv.org/abs/2405.04434
- Jenga: Effective Memory Management for Serving LLM with Heterogeneity - 2025, https://arxiv.org/abs/2503.18292
- Orca: A Distributed Serving System for Transformer-Based Generative Models - Yu et al., OSDI 2022, https://www.usenix.org/conference/osdi22/presentation/yu
- XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models - 2024, https://arxiv.org/abs/2411.15100
- Accelerating Large Language Model Decoding with Speculative Sampling - Leviathan et al., 2023, https://arxiv.org/abs/2302.01318
- EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty - Li et al., 2024, https://arxiv.org/abs/2401.15077
- Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads - Cai et al., 2024, https://arxiv.org/abs/2401.10774
- LMCache: LLM KV Cache Sharing and Offloading - GitHub Repository, https://github.com/LMCache/LMCache