 yuzheng
翻译与阅读笔记
为什么推测解码(Speculative Decoding)会更快?
推测解码不仅没有减少每个 token 的计算量,反而增加了总 FLOPs。它之所以更快,是因为改变了 GPU 的工作负载类型:在小批大小下利用闲置算力置换延迟。
它之所以快,并不是因为做的功变少了,而是因为改变了 GPU 正在执行的工作类型。
很多人常有一个误解:认为推测解码(Speculative Decoding)之所以快,是因为生成每个 token 所需的计算量变少了——仅仅“验证(verifying)”草稿 token 所需的 FLOPs 比完整“生成(generating)”相同 token 要少。
事实并非如此。
推测解码最反直觉的一点在于:你实际上做了更多的工作!对于同一个生成序列,你执行的浮点运算总次数(FLOPs)不降反升。
那它到底为什么能变快?如果一个高准确率的草稿模型(Draft Model)带来的并不是计算效率的提升,它究竟带来了什么?
答案就藏在 GPU 所执行的工作类型之中。
推测解码简要回顾
推测解码是一项经典加速技术:先用一个小参数量的草稿模型提出一段可能成立的草稿序列,再由大模型在单次前向传播中并行验证这段序列。
传统的大模型自回归解码是一次生成一个 token:
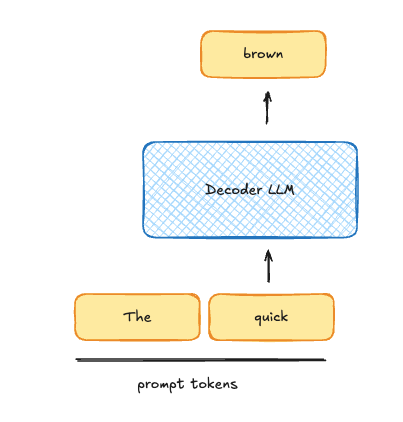
图 1:传统自回归解码。Decoder 接收提示词 token(如 “The quick”),单步前向传播仅输出一个下一个 token(“brown”)。
而推测解码允许大模型在单次前向计算中一次性考察多个候选 token,并接受那些与大模型自身采样分布一致的 token:
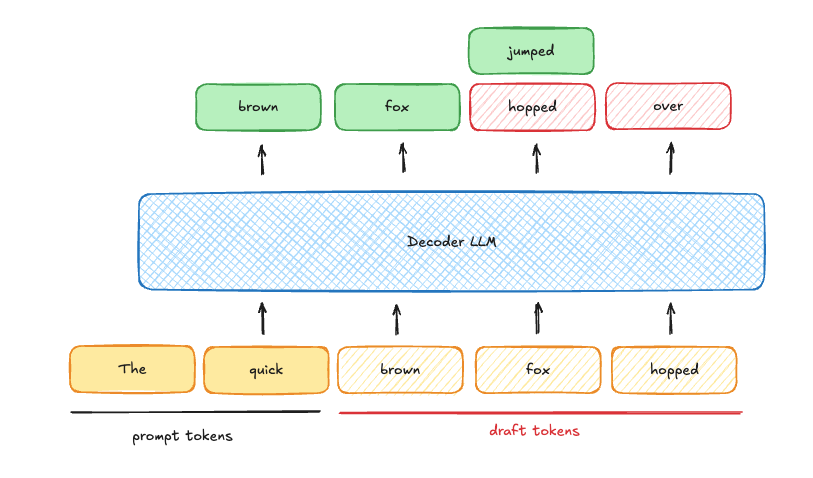
图 2:推测解码。大模型单次前向传播同时验证 3 个草稿 token,接受 “brown” 和 “fox”,并在拒绝 “hopped” 的同时直接采样出修正后的正确 token “jumped”。
GPU 上的工作类型
当模型在 GPU 上运行时,硬件其实在并发进行不同性质的工作。 最显而易见的是算术运算:执行矩阵乘法(GEMM)、点积或其他张量算子。 但另一个同样关键、却不那么显眼的工作是:将数据从全局显存(Global Memory / HBM)加载到片上本地存储(SRAM / 寄存器),反之亦然。
- 当 GPU 的大部分时间都在等待数据搬运时,该操作被称为访存受限(Memory Bound)。
- 当所有数据都已搬运就绪,硬件主要在等待张量计算核心完成运算时,该操作被称为计算受限(Compute Bound)。
(关于这一机制的更深入剖析,可参阅作者此前的文章:A Visual Guide to the Roofline Model。)
当大模型以单 token 步进方式解码时(如图 1 所示),它是极度访存受限的。每吐出一个 token,GPU 都必须从 HBM 完整流式读取一次模型的全部激活权重参数(例如 Qwen3.5-27B 对应的 270 亿参数)。 而当大模型在单步执行包含数千个 token 的批处理解码(Batched Decode)时,计算密度大幅提高,系统便转为计算受限。
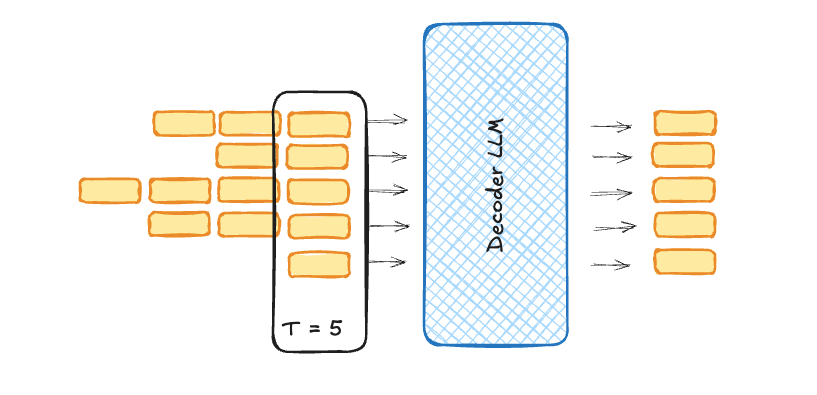
图 3:批处理解码。5 条独立的生成序列在单步中并行输入 Decoder(总计 个 token),输出 5 个 token。
当大模型解码处于访存受限阶段时,算力实际上被白白浪费了。GPU 的计算单元完全有能力执行更多算术运算,但它们却在饥饿等待权重数据。例如,如果在单步中解码 2 条序列而不是 1 条序列,生成每个 token 所耗费的时间几乎完全相同。
推测解码的本质,正是利用这部分未被占满的“冗余算力”,在较小批大小(Batch Size)下实现端到端延迟加速。
用“宽度”换“深度”
为了具体说明这一点,假设在某硬件和模型配置下,单次前向传播能充分平衡算力与带宽的“最优 token 数”为 5。 如果单次处理少于 5 个 token,就会陷入访存受限;若多于 5 个 token,则会进入计算受限。
此时我们有两种选择:
第一种方案:以 batch size = 5 并发运行 5 条独立序列,每条序列各自解码 1 个 token。我们把这种方式称为跨序列的**“宽度”(Breadth)**推进:
图 4:将 理解为“宽度”。5 条独立序列在单步中各推进 1 个 token。
第二种方案:利用推测解码,在单条序列内一次性输入 5 个 token(即验证 4 个草稿 token + 预测后续),从而在序列维度实现很高的**“深度”(Depth)**推进:
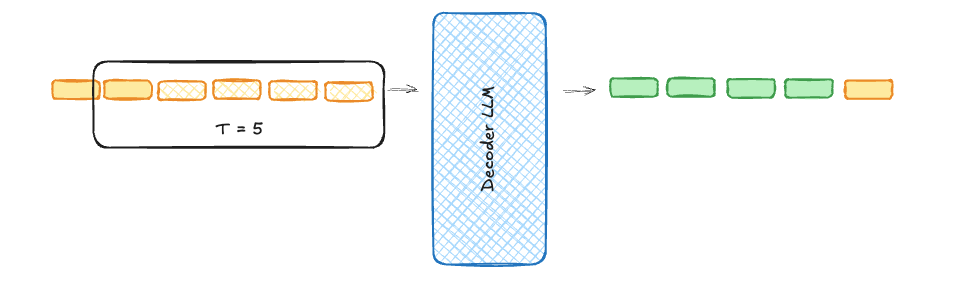
图 5:单条序列的深度推测。单步输入 个 token,其中 4 个 token 被成功接受。
在这两种情况下,GPU 所执行的实际物理工作量(数据搬运与计算总量)大致相同。 但效果完全不同:在第一种方案中,5 条序列各自推进了一小步;而在第二种方案中,我们的单条序列一下子跨越了一大步。
如果系统本身已经并发了大量序列,此时再让每条序列都推测到相同的深度,总 token 规模就会迅速推高计算量,使 GPU 彻底计算受限,反而导致所有请求的延迟统统变慢。
但在批大小较小(即 Batch Size 远小于最优饱和 token 数)的场景下,推测解码能够近乎“免费”地利用闲置算力,让单请求序列以更少的前向传播步数更早完成!
为什么这在实践中至关重要?
上述讨论听起来可能略显学究气。有人可能会问:既然推测解码在小批大小下确实能加快端到端生成,那它背地里究竟多做了还是少做了运算,真的很重要吗?
当你面向真实生产流量进行模型服务部署,或者深入推测解码前沿研究时,这一点就变得至关重要。 假设系统的最优处理 token 数是 5,但我们在多并发下依然开启了推测解码(如下图所示):此时每条序列都推测 4 个 token,单步总 token 激增到 。我们实际上是在滥用并浪费计算资源,而此时如果把时间留给显存搬运和更多并发请求,整体吞吐会高得多!
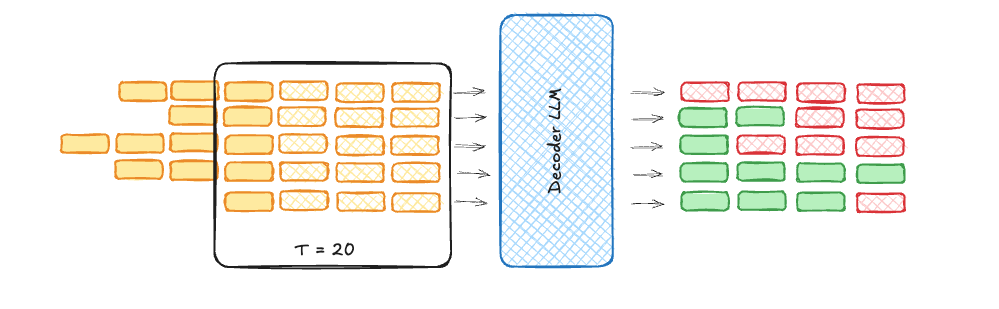
图 6:5 条序列各向后推测 4 步(单步处理 个 token)。系统已严重计算受限,且大量草稿 token 最终被拒绝。
更重要的是,草稿模型的接受率(Acceptance Rate)往往无法达到 100%。每一个被大模型拒绝的 token,都是完全被抛弃的额外浪费。
正因如此,在高吞吐服务场景下,主流推理引擎(如 vLLM)专门提供了配置参数,支持根据批大小自动禁用推测解码(即 --speculative-disable-by-batch-size 参数)。
观察到这一现象的研究人员也开始思考:为什么我们在每一个时间步都必须对所有序列推测相同的固定深度? 为什么不在算力充裕(小批大小)时进行大深度推测,而在并发增多(大批大小)时减小推测深度,甚至针对每条序列动态自适应调整?
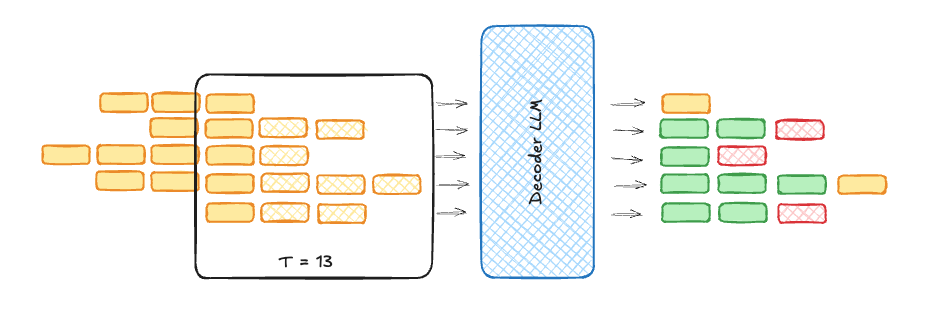
图 7:单步中 5 条序列推测不同深度(深浅不一,总计 个 token),兼顾计算饱和度与接受收益。