 yuzheng
翻译与阅读笔记
Continuum:多轮 Agent 调度与 KV Cache TTL
理解工具调用期间的 KV 驻留、多轮任务连续性,以及 TTL 与调度策略之间的取舍。
问题:缓存恢复之后,为什么仍然慢
多轮 Agent 的一次任务通常包含多次模型调用。模型生成动作,工具执行动作,工具结果再进入下一轮上下文。如果推理服务只把这些轮次看作互不相关的请求,就可能反复支付历史上下文的重算、搬运和排队成本。
Continuum 关注的是整个任务的完成时间,而不仅是单次模型调用的速度。它用 KV Cache 的租约时间(Time-to-Live,TTL)连接相邻轮次:在工具执行的一段时间内保留 GPU 上的状态,并根据资源压力与预期收益决定保留多久。
本文依据已有中文精读稿重新整理。实验数字对应原稿引用的论文设置,不代表所有 Agent 工作负载;文末的项目联系属于个人理解。
1. 两类反复发生的开销
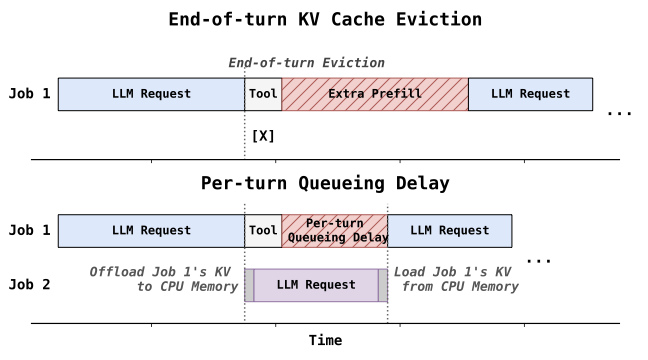
图 1:论文 Figure 1,对比不同服务方式下的重算与调度开销。
第一类是 历史上下文的重复处理 。如果一轮结束后 KV 被回收,下一轮就需要重新 Prefill;如果 KV 已卸载到 CPU,则需要先恢复。工具返回得越快、历史上下文越长,这段额外工作越值得关注。
第二类是 重新入队的等待 。CPU 缓存可以减少重算,但并不自动保留下一轮所需的 GPU 资源。在显存紧张或并发较高时,请求仍可能等待其他任务释放空间。这样的等待在多个轮次中累积,影响最终的任务完成时间(Job Completion Time,JCT)。
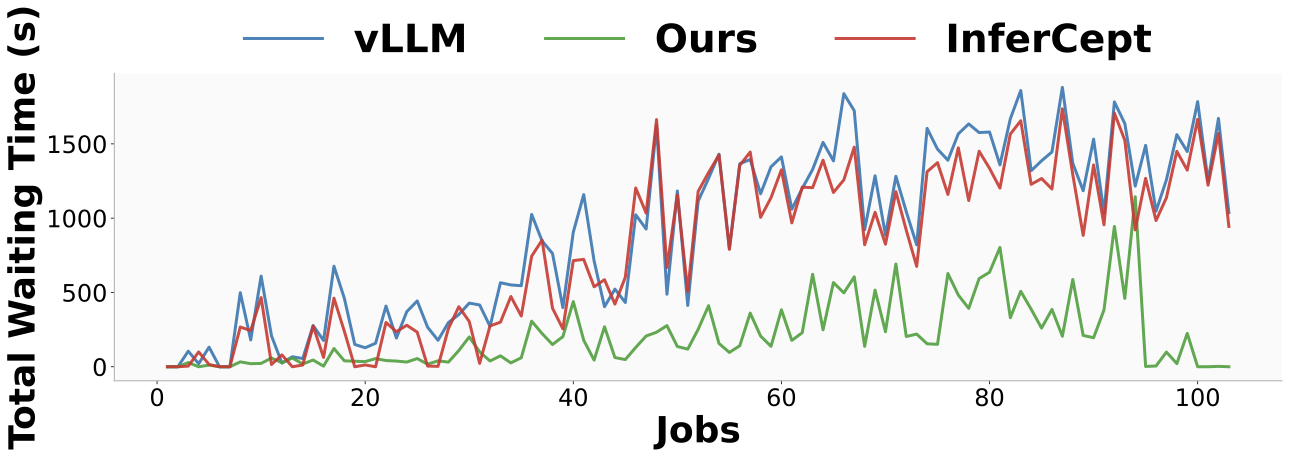
图 2:论文 Figure 4。分析卸载策略时,需要同时考虑数据恢复和重新排队。
这两类开销并非在所有系统、所有负载下同样严重。论文的出发点是:对于工具间隔较短且上下文不断增长的任务,仅优化单轮请求不一定能优化整个 Agent。
2. 工作负载为什么适合跨轮次保留
已有精读稿整理了论文中 Mini-SWE-agent 与 BFCL 的轨迹统计:
| 工作负载 | 平均轮次数 | 平均工具耗时 | 每个任务平均 token 总量 |
|---|---|---|---|
| SWE-bench | 10.9 | 925 ms | 70,126 |
| BFCL v4 | 6.3 | 1,923 ms | 93,256 |
这些数字描述的是采集到的轨迹。它们说明,某些 Agent 的工具等待时间比人工交互间隔短得多,因此可以尝试在这段间隔内保留 KV,而不是立即让出全部状态。
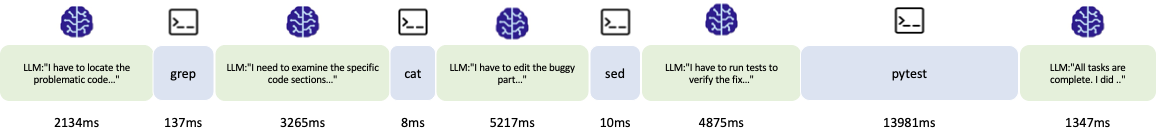
图 3:论文 Figure 3,展示模型与工具交替执行的过程。
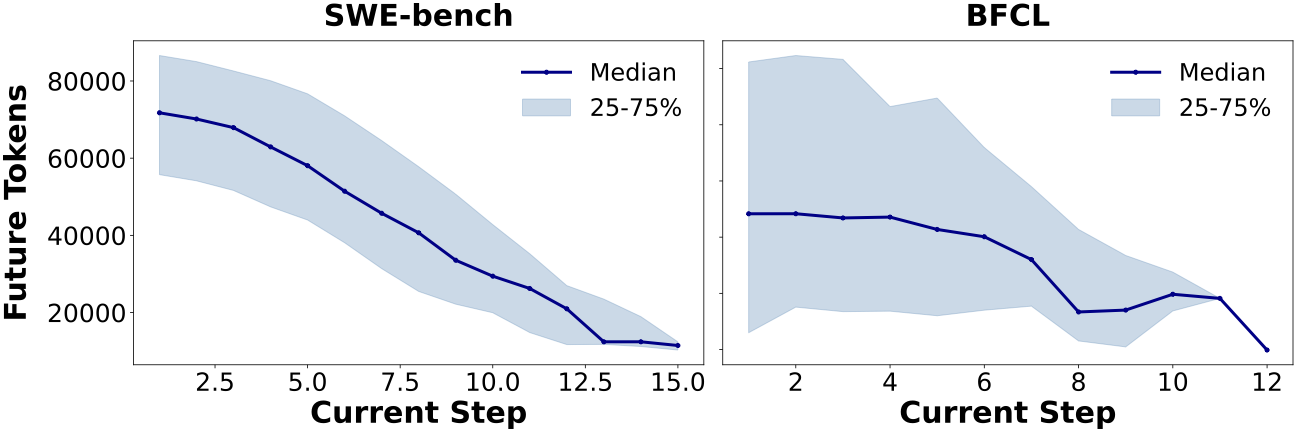
图 4:论文 Figure 2。任务所处的阶段也会影响继续为其保留资源的价值。
3. 机制:标识会话、保留状态、设置到期时间
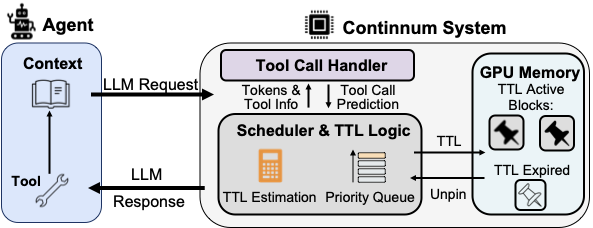
图 5:论文 Figure 5,展示工具调用、KV 保留和调度之间的联系。
Continuum 的机制可以按三个步骤理解:
- 识别同一任务。 客户端携带
program_id,服务端据此关联多轮请求,而不是只保留单次请求的身份。 - 在工具执行期间保留 KV。 显式保留(Pinning)使相关状态在租约内继续驻留,减少下一轮重新获得状态和资源的开销。
- 设置有界的保留时间。 工具可能变慢、失败或不再返回,因此保留必须能够到期。租约到期后,系统可以回收相应资源,避免无限等待占用显存。
这是一种资源分配策略。它并不意味着下一轮在任何情况下都能“零延迟”执行:模型计算、调度以及其他系统开销仍然存在。
4. TTL 如何平衡收益与代价
设保留时间为 。较长的租约提高了工具在状态仍驻留时返回的机会,但同时延长了其他请求不能使用这部分显存的时间。
阅读模型时,可以分别看两项成本:
- 不保留的成本 :下一轮可能支付重载或重算时间 ,以及重新进入队列的等待时间 。
- 保留的成本 :等待工具的状态继续占用显存,可能降低其他请求的准入机会。
动态 TTL 尝试在这两者之间选择合适的 。这里的“最优”应放回模型的假设与估计条件中理解,不能解释为对任意负载都保证全局最短 JCT。工程上还需要处理工具时长估计误差和突发的显存压力。
5. 如何阅读实验结果
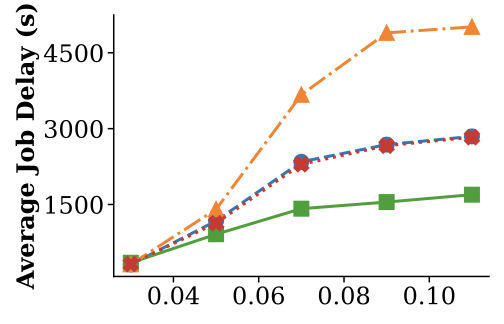
图 6:论文 Figure 12。横轴为并发负载,纵轴为平均任务完成时间。
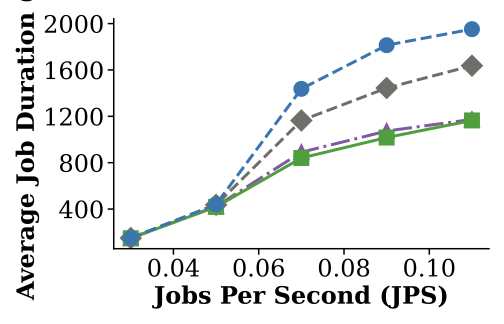
图 7:论文 Figure 15,对比不保留、无限保留与自适应保留。
已有精读稿记录的结果包括:相对对照系统,任务完成时间加速比最高达到 8.18× ;不同设置下吞吐提升为 1.10×–3.22× 。这些是特定模型、硬件、并发与工作负载下的结果,不是跨设置的固定收益。
比单个最大加速比更值得关注的是消融实验:它帮助区分收益究竟来自状态驻留、TTL 选择还是其他调度改动。评估自己的系统时,也应同时观察任务完成时间、吞吐、显存占用,以及其他请求受到的影响。
6. 个人思考:与会话 KV 管理的联系
以下是个人理解,不属于论文原文。
在 Qwen3 Runtime 中,我关注工具等待期间的会话状态保存、前缀校验与增量恢复。只有前缀匹配且缓存有效时,后续请求才能复用历史 KV;显存压力、回收策略和传输成本都会影响收益。
这与 Continuum 讨论的缓存生命周期有关,但实现范围和评测条件不同。Qwen3 Runtime 面向单 GPU 的 Agentic Rollout 推理层,不能据此宣称已经实现论文的调度算法或达到其评测结果。
具体实现与实验边界见 Qwen3 Runtime 项目记录。