 yuzheng
翻译与阅读笔记
CUDA 从零到精通 #1
从 GPU 硬件、线程层次与内存结构出发,理解 CUDA 编程的基本执行模型。
把硬件结构与线程模型放在一起看
这篇笔记依据 Pramod Goyal 的 CUDA 入门文章及已有中文译稿整理。目标是建立一条连续的理解路径:GPU 为什么适合并行计算,CUDA 如何组织线程,以及如何把矩阵乘法映射到这些线程上。
硬件示意图帮助建立概念;具体 GPU 的单元数量、缓存容量和执行限制仍需结合目标设备。本文最后的朴素矩阵乘法用于说明索引与执行方式,性能优化可继续阅读 CUDA 矩阵乘法优化。
理解 GPU 硬件
这时自然会产生一个显而易见的问题:我们为什么需要 GPU?光有 CPU 难道还不够吗?难道不能把它们合并在一起吗*?为什么非要搞一个独立的计算模块?
*有趣的是,苹果(Apple)恰恰就是这么做的;你可以在这里了解更多信息(我记得曾看过一个非常精彩的深度科普视频,可惜一时想不起名字了。如果你知道我说的是哪个视频,欢迎随时联系我。)。
这是 CPU 的大致架构:
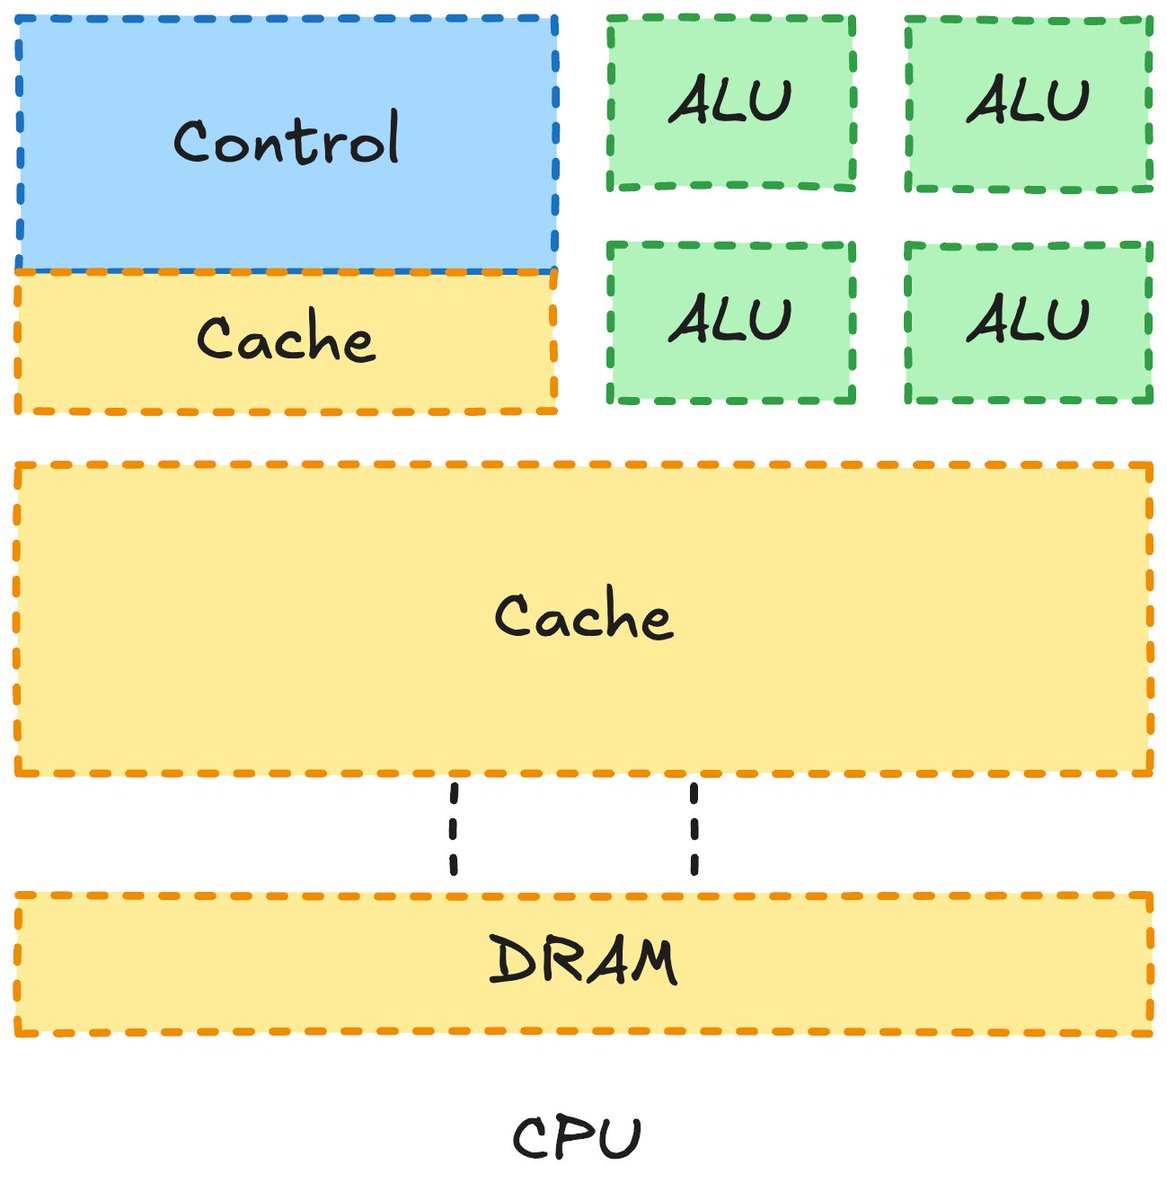
灵感源自《PMPP》(大规模并行处理器编程,Programming Massively Parallel Processors)
其中的各个组成部分包括:
DRAM ➔ 动态随机存取内存(Dynamic Random Access Memory),数据在进入计算单元之前存放于此。
CACHE ➔ 缓存(Cache),用于暂存运算过程中频繁访问与即时产生的计算数值的临时存储空间。
CONTROL ➔ 控制单元(Control),负责决定将计算任务分发到何处、将数据存放在哪里。它是整个芯片的控制中心。
ALU ➔ 算术逻辑单元(Arithmetic Logic Unit),实际负责执行算术与逻辑运算的核心部件。
注: 这只是对 CPU 架构(以及稍后将介绍的 GPU)的一种高度简化概括,目的是帮助你建立对核心组件及其工作机制的直观认知。随着文章的推进,我们将逐步把这些顶层组件拆解为具体的细分部件,深入探讨其内在运作原理。
如果你想要串行地处理任务(即一个接一个地执行),那么这种架构非常出色。在现代 CPU 中,我们甚至拥有多个核心,因此也可以并行执行多项计算任务(多线程、并行与异步是完全不同的概念,建议阅读这篇讨论来理解它们之间的区别)。
现在,试想一下矩阵乘法——这也是绝大多数 AI 模型的核心运算。如果你仔细分析这种运算,就会发现它天然是可以高度并行的:输出矩阵中的每一个数值都可以完全独立于其他数值进行计算,你所需要的仅仅是对应第 i 行与第 j 列的行向量与列向量。
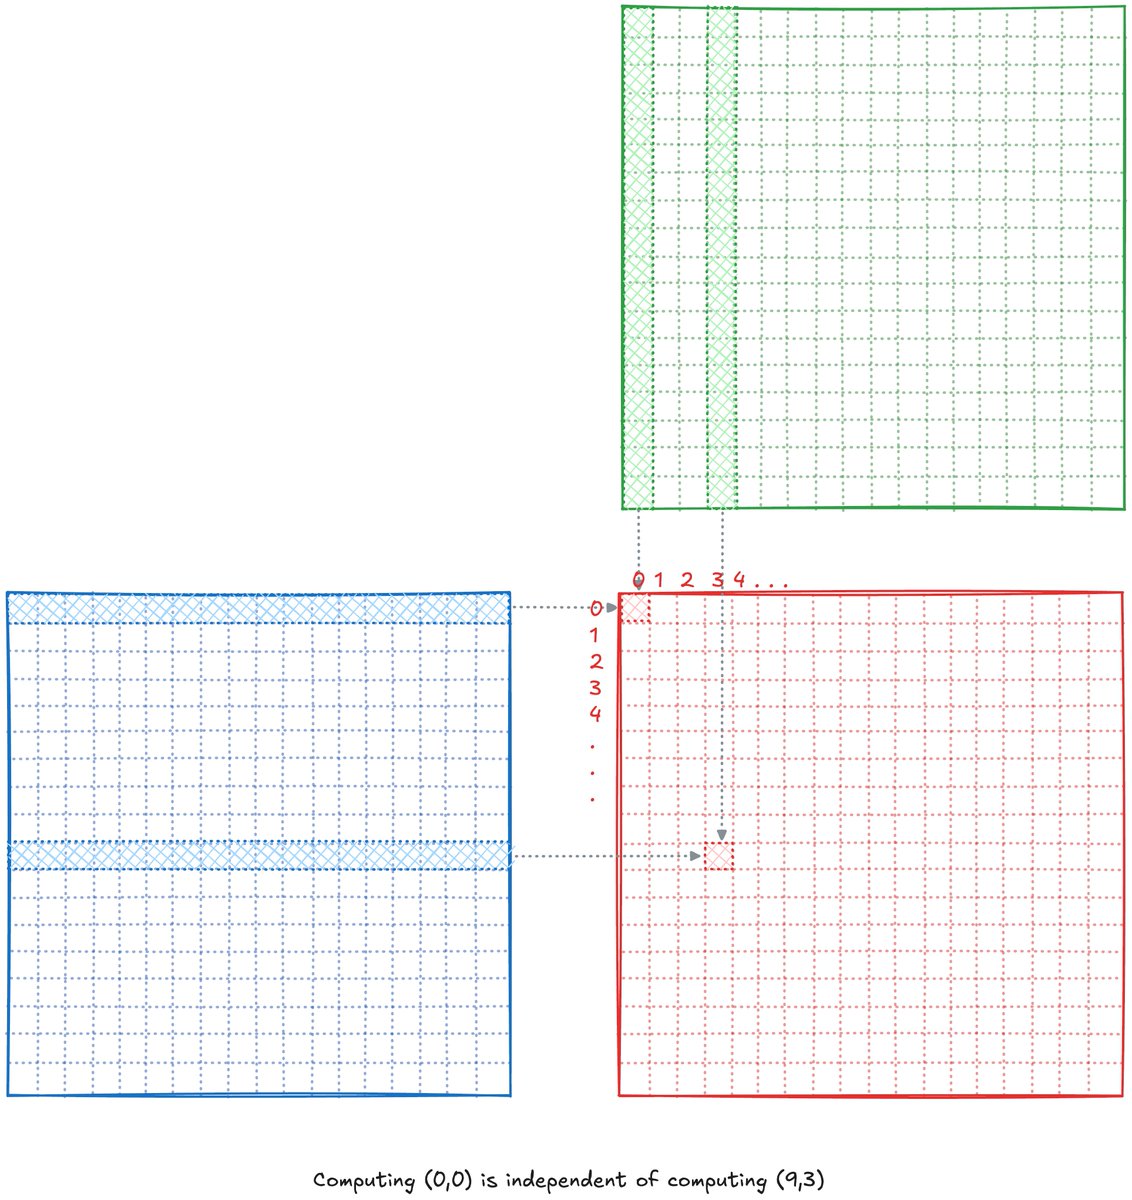
而为了实现这种大规模并发计算,相比 CPU 我们需要做出怎样的改变?……答案其实并不难猜: 更多的 ALU。 因为我们希望尽快同时算出所有这些数值。这就是为什么通常 GPU 的架构看起来是这个样子的:
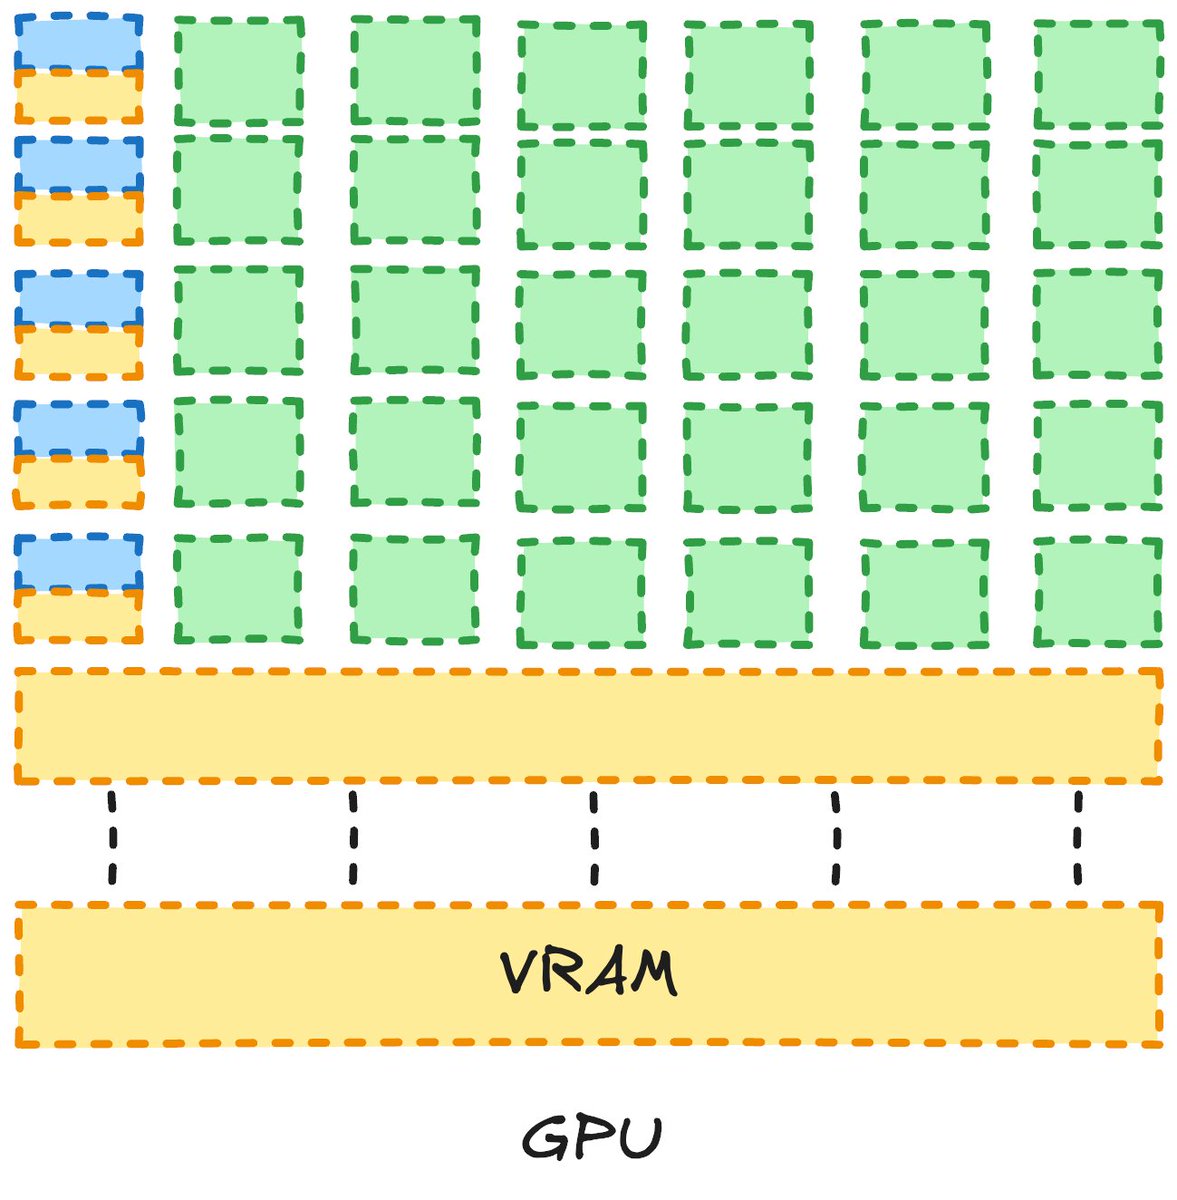
注: 再次强调,这里的 GPU 架构图也是一个简化示意。但它足以清晰传达核心设计理念。随着我们讨论的深入,我们会在现有知识的基础上逐步补充,架构图也会变得更加丰富和细致。
正如你在上图中所见,GPU 拥有数量多得多的 ALU。接下来让我们通过各个组成部件的名称来更深入地理解它们。由于本文的核心在于理解 GPU 与 CUDA,因此相比上面的 CPU 部分,我们将对这些部件进行更加详尽的探讨。
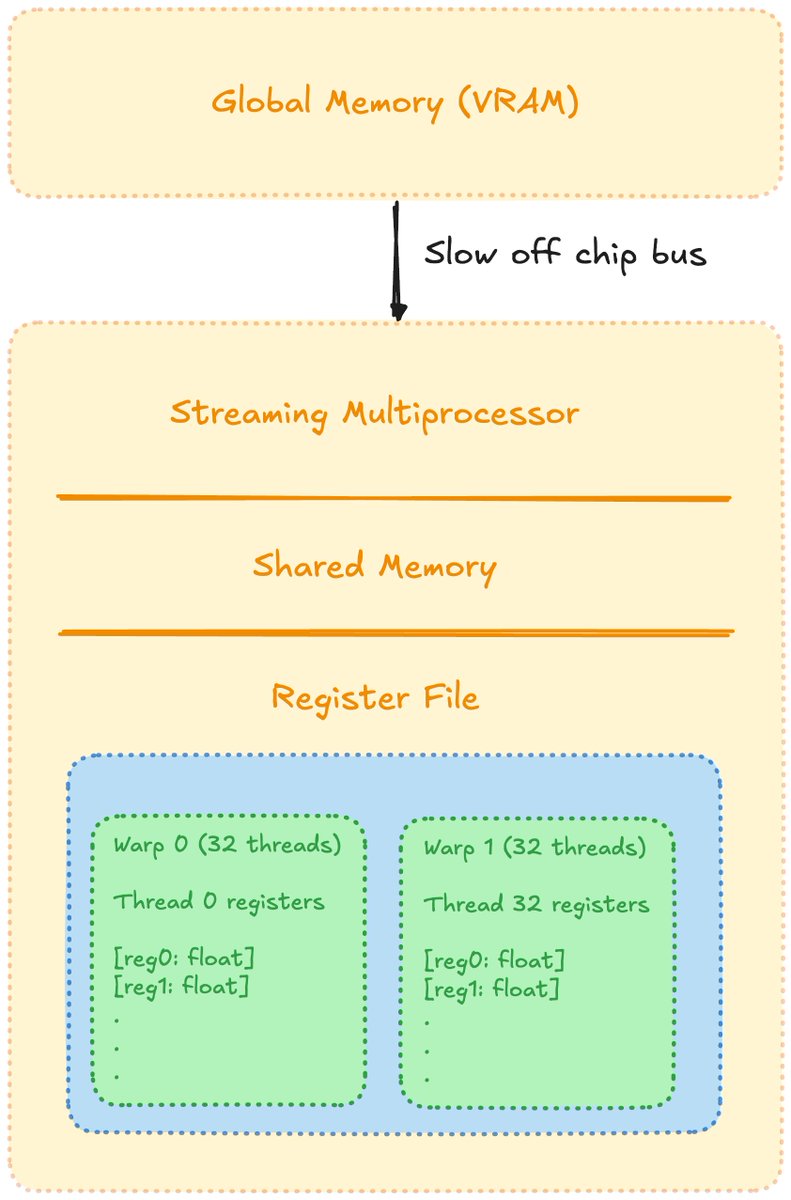
图片灵感来源于该技术博客
我们需要理解的最基础事实就是: 存储容量越大,访问速度越慢;反之亦然。 (目前我还没有完全搞懂其背后的物理/硬件深层原因,不过等我彻底搞明白后,我一定会写出来。)。
全局内存(Global Memory) 即显存(VRAM),也就是厂商宣传标称的 GPU 存储容量。一个 SM(流式多处理器,Streaming Multiprocessor) 内部包含多个部件,例如 Tensor Cores、线程执行单元、Warp 调度器(Warp Scheduler)等等众多组件。
对于本文而言,我们暂时不必钻得过深。现在我们先聚焦于最核心的几个思想。最关键的一点在于理解: SM 内部驻留有线程块(Blocks);这些块内部包含多个线程(Threads);同一个块内的线程【只能】访问该块对应的共享内存(Shared Memory)。
所有的线程都按 32 个线程一组组织为一个 Warp(线程束) 。本质上,一个 Warp 会同时并发执行其中的所有线程。
(如果现在觉得有些难以理解也不用担心,随着我们的继续深入,这些概念会变得越来越清晰。)
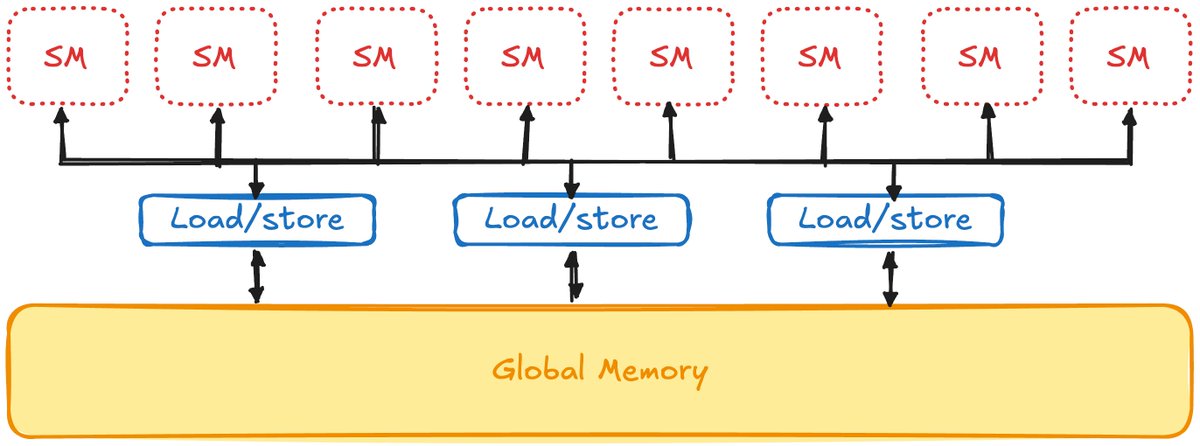
将数据从全局内存(Global Memory)传输到 SM 是一项开销极大且相对低效的操作,Horace He 写过一篇非常精彩的博客《Making GPUs go Brrr》,对此作了极为出色的阐述,非常推荐一读。因此在理想情况下,我们希望把数据一次性加载到 SM 中,在 SM 本地完成全部必要的计算,并在所有计算全部完成后,再把结果统一写回全局内存。
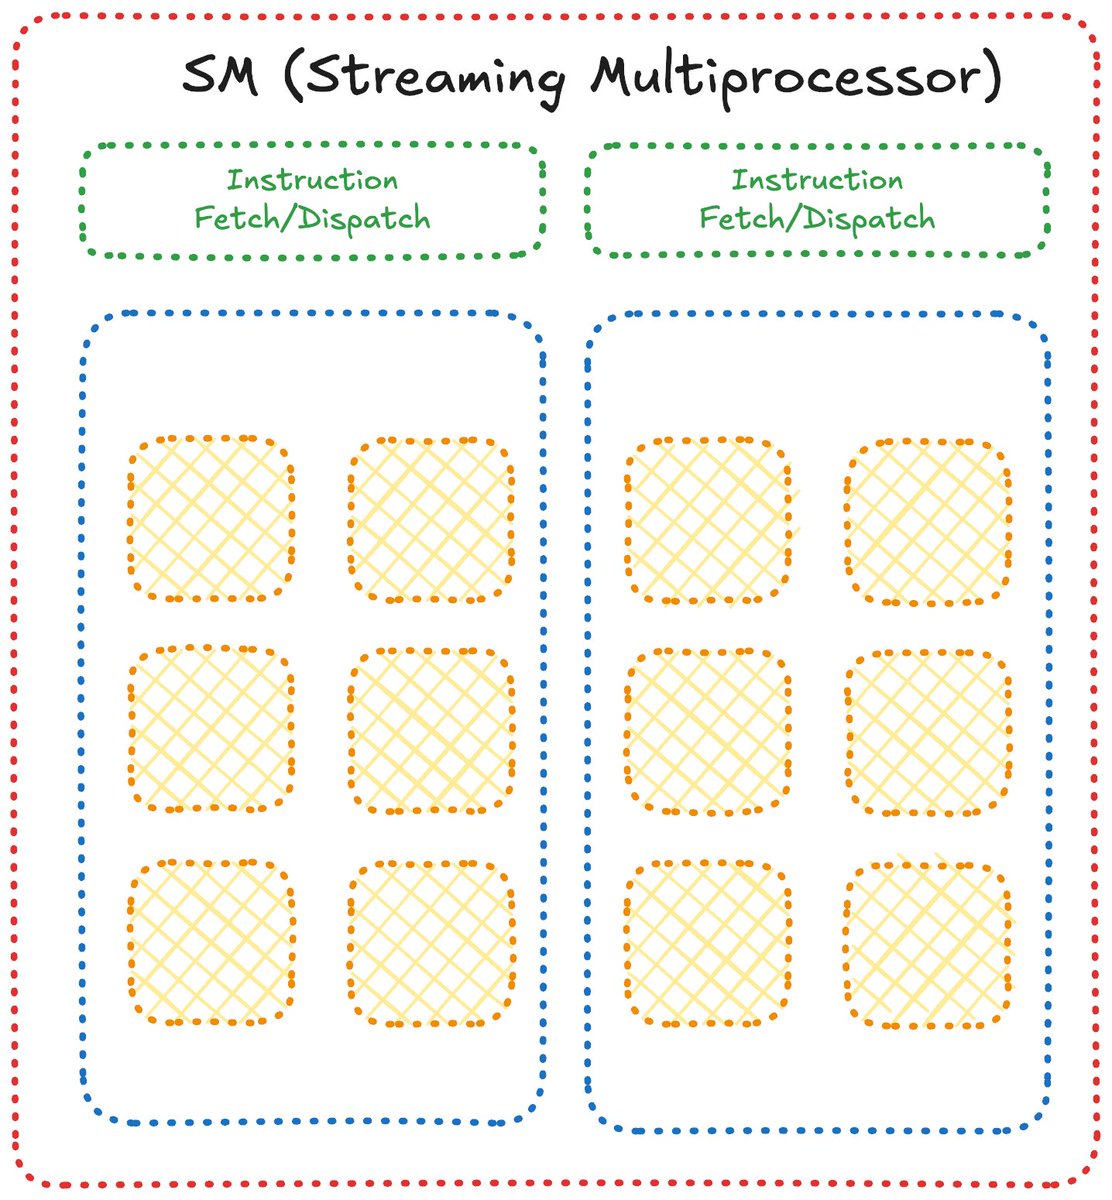
上图是 SM 结构的一个简化示意图。到目前为止,我们已经对为什么需要 GPU 以及 GPU 的大体形态有了很好的宏观理解。当我们后续深入到更深入的内容时,这些基础知识将发挥巨大的作用。
理解 CUDA 软件模型
现在,我们可以开始探究 CUDA 内部的运作机制了。
在 CUDA 中,我们有 Grid(网格) ,Grid 内部包含若干个 Block(线程块) ,而 Block 内部则包含若干个 Thread(线程) 。如下图所示,它们可以按照三维(3D)的形式进行编排,但在绝大多数实际工程中,大家通常采用二维(2D)布局,因此我们在大部分时间里也会使用 2D 布局。
因为对于初学者来说一维(1D)模型更直观易懂,所以本篇中我将先采用 1D 模型进行讲解。多维布局的内容我们将在下一篇文章中正式展开。
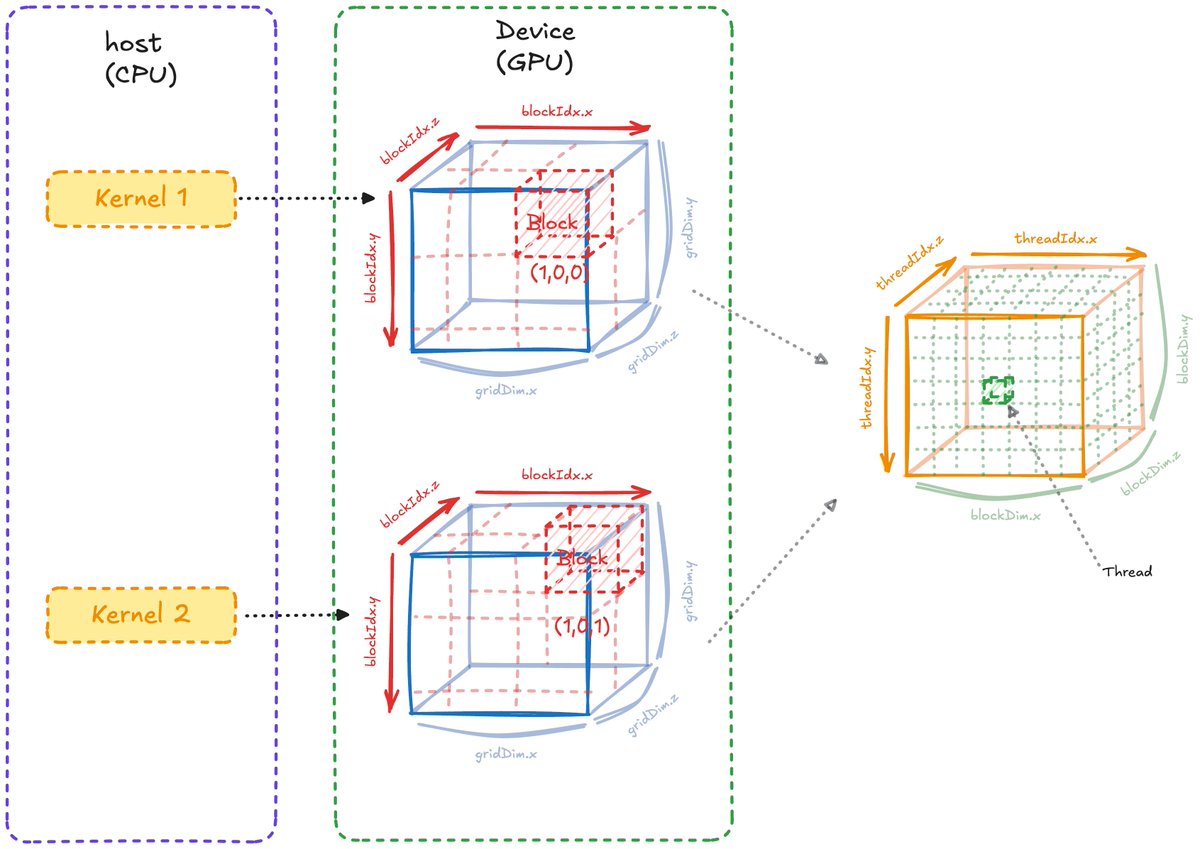
对于刚入门的人来说,上图的信息量可能有些大,但让我们逐个组件拆解剖析:
我们拥有一个 Host(主机端) ,我们在其上编写并调用将在 Device(设备端) 上运行的 CUDA 核函数(Kernel)。简而言之: Host 就是 CPU,Kernel 本质上就是一个函数,而 Device 就是 GPU。
在启动核函数时,我们定义了网格中的线程块数量(Grid 中的 Block 数),以及每个线程块中的线程数量(Block 中的 Thread 数)。
为了在 Block 和 Grid 之间进行遍历寻址,我们拥有 Dimension(维度尺寸) 和 Index(索引位置) 这两个概念。(请仔细辨析,这两者截然不同:Index 帮助你在某个方向上定位移动,而 Dimension 则定义了该方向的总跨度/长度)。
编写简单的矩阵乘法
现在,让我们先用 Python 编写一段简单的 CPU 矩阵乘法代码,然后再利用我们刚才学到的知识来编写对应的 CUDA 核函数。
Python (CPU 参考实现)
import numpy as np

a = 5
b = 10
c = 5

GEMM_1 = np.random.rand(a, b)
GEMM_2 = np.random.rand(b, c)

ANS_triple = np.zeros((a, c))

for i in range(a):
    for j in range(c):
        for k in range(b):
            ANS_triple[i, j] += GEMM_1[i, k] * GEMM_2[k, j]

# 两者结果应该与 numpy 内置的 matmul 完全一致
assert np.allclose(ANS_triple, GEMM_1 @ GEMM_2)
在编写 CUDA 代码时,我们需要时刻铭记的最朴素理念是: 我们拥有成千上万个线程,它们能够并发执行,而我们要做的就是让它们齐头并进地同时运转起来。
你能写出的 最糟糕 的矩阵乘法如下所示:
CUDA C++ (极度低效的反例)
// A -> M X K
// B -> K X N
// output -> M X N

__global__ void super_bad_matmul_kernel(const float* A, const float* B, float* output, int M, int N, int K){
   float temp_val = 0;

   for(int i = 0; i < M; i++){
      for(int j = 0; j < N; j++){
         for(int k = 0; k < K; k++){
            temp_val += A[i * K + k] * B[K * k + j];
         }
         output[i * N + j] = temp_val;
      }
   }
}

extern "C" void solve(const float* A, const float* B, float* output, int M, int N, int K) {
   // 注意:这里只启动了 1 个 Block、1 个 Thread!
   super_bad_matmul_kernel<<<1, 1>>>(A, B, output, M, N, K);
}上面的代码糟糕透顶,根本原因在于我们完全没有利用好代码可以高度并行的特性,也没有让多个线程各自计算一个独立的输出值。请注意,solve 函数仅仅启动了单个线程(<<<1, 1>>>)。因此,即便这段代码运行在 GPU 上,那区区一个线程依然要独自一人跑完整个三重循环,行为与 CPU 版本如出一辙——我们根本没有享受到 GPU 的任何并行红利。
接下来,让我们编写一个朴素但正确的 CUDA 解决方案(Naive Matmul),随后我将详细拆解每个部分的作用以及它为何要这样设计。
CUDA C++ (标准入门朴素实现)
// A -> M X K
// B -> K X N
// output -> M X N

__global__ void naive_matmul(const float* A, const float* B, float* output, int M, int N, int K){
   // 计算当前线程的全局唯一索引
   int gid = threadIdx.x + blockDim.x * blockIdx.x;

   // 边界越界保护检查
   if(gid >= M * N) return;

   int row = gid / N;
   int col = gid % N;

   float temp_val = 0;
   for(int i = 0; i < K; i++){
      temp_val += A[row * K + i] * B[i * N + col];
   }

   output[gid] = temp_val;
}

extern "C" void solve(const float* A, const float* B, float* output, int M, int N, int K) {
   int threadsPerBlock = 256;
   // 向上取整计算需要的 Block 数量
   int blocksPerGrid = (M * N + threadsPerBlock - 1) / threadsPerBlock;

   naive_matmul<<<blocksPerGrid, threadsPerBlock>>>(A, B, output, M, N, K);
}
虽然上面的实现算不上优化的高性能版本,但它已经展现出了 CUDA 并行的真正价值。在这段代码中,涉及到了一个我们此前尚未提及、却处于 CUDA 核心地位的关键概念: 数据在物理内存中的实际排布是一维的,并且是以行优先(Row-Major)的格式连续存储的。
我们知道输出矩阵的形状是 。但是在计算机内存物理层面并不存在真正的二维结构,只有一维连续地址空间。因此,并不是真的在硬件上排布成 的网格,而是将 行、每行 个元素紧密地首尾相连堆叠在一维内存中,具体呈现如下图所示:
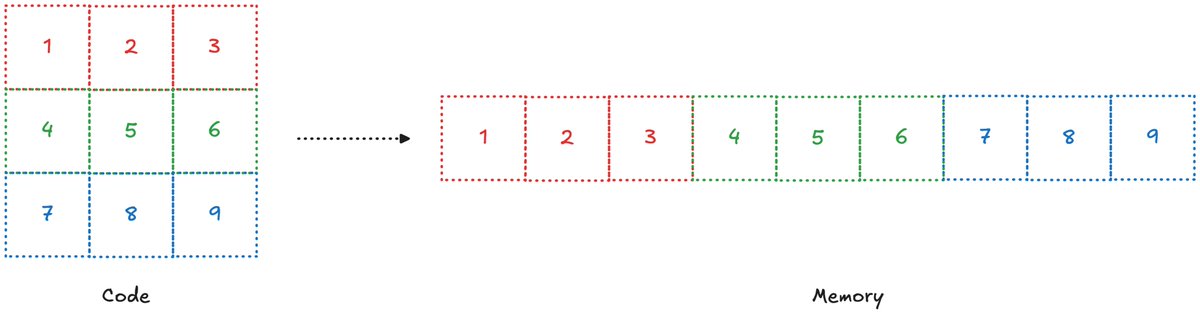
(对于三维数据,你也可以类比想象出类似的展开形式)
因此,我们来拆解一下 gid(我习惯称之为全局 ID,即 Global ID;而 tid 即线程 ID,代表线程在当前线程块内部的序号,既然我们定义了每个块的大小为 256,那么 tid 就绝不会超过这个上限)。它由 threadIdx、blockDim 和 blockIdx 共同计算得出。其中 Idx 代表索引(Index),dim 代表维度大小(Dimension)。
直观地可视化并理解其运算过程至关重要:threadIdx 告诉你当前线程在自己所属线程块中的相对偏移量;而将线程块索引(blockIdx)乘以线程块维度大小(blockDim),则能准确算出在当前线程块之前,已经排了多少个线程。
理解这一点的绝佳方法是 逆向倒推 :我们希望每个线程独立计算输出矩阵中的一个元素值,因此我们需要 个线程。但直接一次性启动一个无限大或者任意大小的单一块是不现实的。
因此,我们设定每个块容纳 256 个线程(threadsPerBlock = 256),然后在此基础上反推需要启动多少个线程块——这也正是向上取整(Ceiling)公式的由来:
blocksPerGrid = (M * N + threadsPerBlock - 1) / threadsPerBlock;
这个公式能够确保我们分配出足够数量的线程块以及足够多的线程来承载全部计算任务。然而,正因为向上取整的存在,启动的总线程数可能会略微超出 个。这也正是我们在核函数中加入越界检查判断的原因:
if(gid >= M * N) return;
建议多读几遍这一段,尝试用你自己的语言和逻辑去推导一遍,你一定能豁然开朗。
接下来该何去何从?
如果你想检验并巩固刚才学到的知识,我强烈推荐你去体验以下两个实战练习资源:
本篇文章对很多核心概念进行了高度的提炼与简化。在下一篇文章中,我们将进一步探讨 CUDA 代码中的常见性能瓶颈究竟是什么、我们该如何精准定位它们,以及如何有针对性地实施性能优化。同时,我们也会深入学习与之对应的 GPU 硬件细节。
最后,如果你已经一口气读到了这里,那我就权当你是真的很喜欢这篇文章了。既然如此,此情此刻你我便已经是挚友了——而作为朋友,不妨顺手将这篇文章分享给你身边的其他开发者朋友们,这也是对我最大的帮助与支持。