 yuzheng
翻译与阅读笔记
将大模型推理引擎放入递归自改进(RSI)闭环?
探讨如何利用强化学习后训练与多 Agent 群体协作,构建自动优化推理调度器、KV Cache 管理器、路由与算子的递归自改进(RSI)系统。
过去几个月里,我一直在深入研究强化学习后训练(RL Post-Training)领域及其周边的系统工程。我的目标是:利用自己在推理引擎(Inference Engines)和 GPU 算子(Kernels)方面的已有积累,搞清楚如何才能将整个推理引擎置入一个递归自改进(Recursive Self-Improvement,RSI)闭环之中。
如果仅针对独立的底层算子(Kernels),将其置入自动生成与调优闭环基本算是一个已解决且相对易处理(tractable)的问题。然而,一旦将目标范围扩展到“推理服务(Inference Server)+ 推理引擎(Inference Engine)”,系统的复杂度便会呈指数级爆炸。
推理引擎本身由众多精密复杂的子模块构成。整个推理技术栈包含了请求调度器(Scheduler)、KV Cache 管理器、请求路由器(Router)、硬件算子(Kernels)等等。因此,当谈及如何优化它时,一个显而易见的设计思路是:部署一个多 Agent 协作群体(Multi-Agent Swarm),每个 Agent 负责技术栈的一个特定分层,在彼此紧密协同的前提下共同提出优化方案。
那么,从 50,000 英尺的高空俯瞰,我们该如何设计这样一个系统?受 Kimi K2.5 以及 Prime Intellect 的 Multi-Agent Systems 近期工作的启发,我梳理了如下思考。
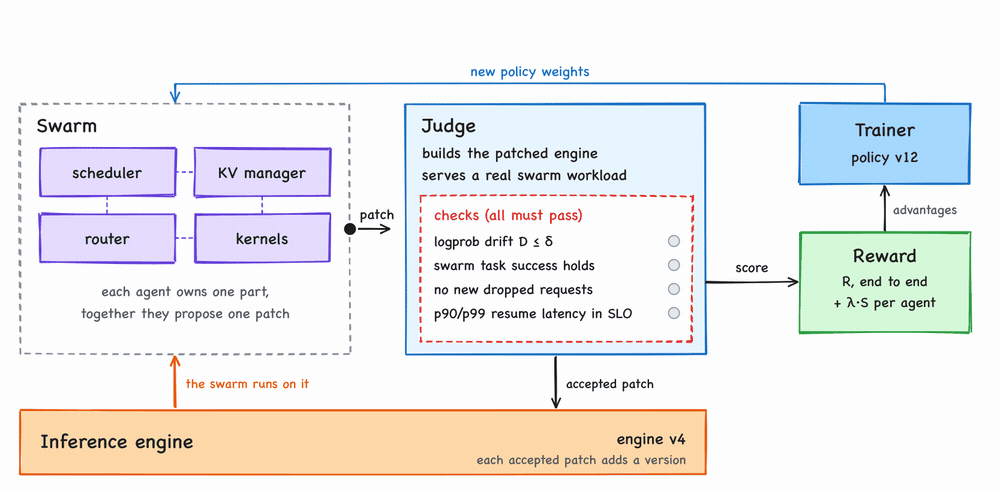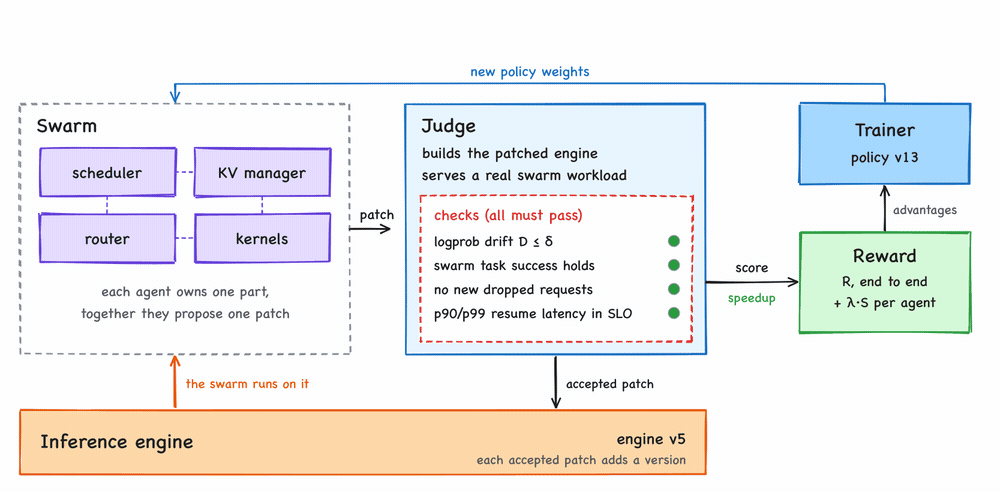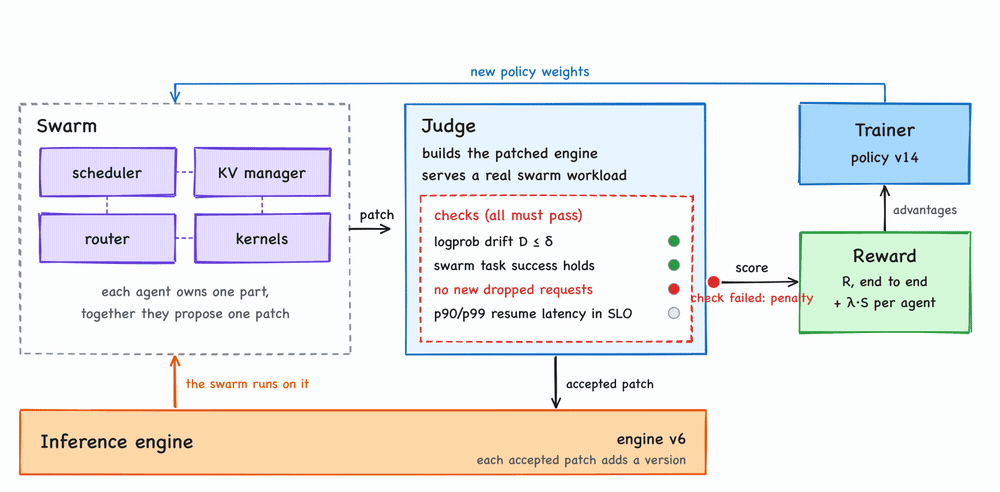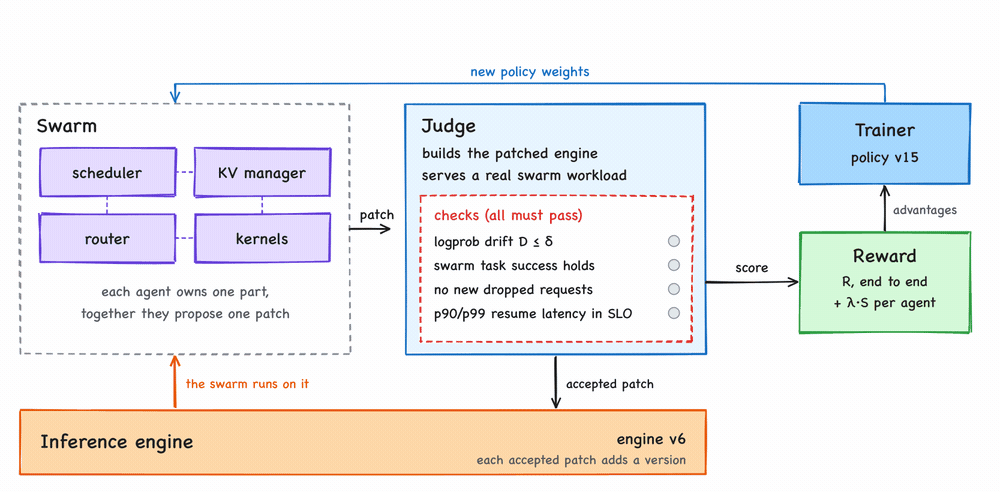
图 1:不同 Agent 各自负责技术栈的一个特定模块,协同提出一个组合补丁(Patch)。环境(如评估裁判 Judge)负责编译打了补丁的推理引擎,在其上运行多 Agent 真实工作负载,并对通过全部校验的改动打出正向分数(示意)。图中示意了每 3 个补丁就可能有 1 个因未通过测试而受到惩罚。一旦补丁被接受,便成为下一代引擎版本,且后续的 Agent 负载自身直接运行在此引擎之上。
1. 评估环境(Environments)
对于单一算子,评估环境的设计是清晰可控的:分配一张 GPU,挂载 nsys 与 ncu 性能分析工具,明确要观测的核心硬件指标,并据此设计合理的奖励函数。只要把这些塞进循环,就能得到一台高效的“算子生成机器”。最近几次模型迭代已让这一任务变得愈发自动化。
但当面对整个推理引擎时,问题就棘手得多。实际流量的形态直接决定了推理引擎应该采取哪些优化策略:输入长度分布、输出长度分布、批大小(Batch Size)、不同会话与请求之间是否存在缓存复用(Cache-Reuse)等等。
多 Agent 协作负载(Swarm Traffic)进一步加剧了这种复杂性:
- 多个 Agent 之间往往存在大量的共享前缀(Shared Prefix);
- 部分或全部 Agent 在等待工具调用(Tool Calls)期间处于空闲状态,但仍然在 GPU 显存中霸占着 KV Cache;
- 某个 Agent 可能很早就完成了生成,却必须在显存中保留上下文,等待其余 Agent 执行完毕。
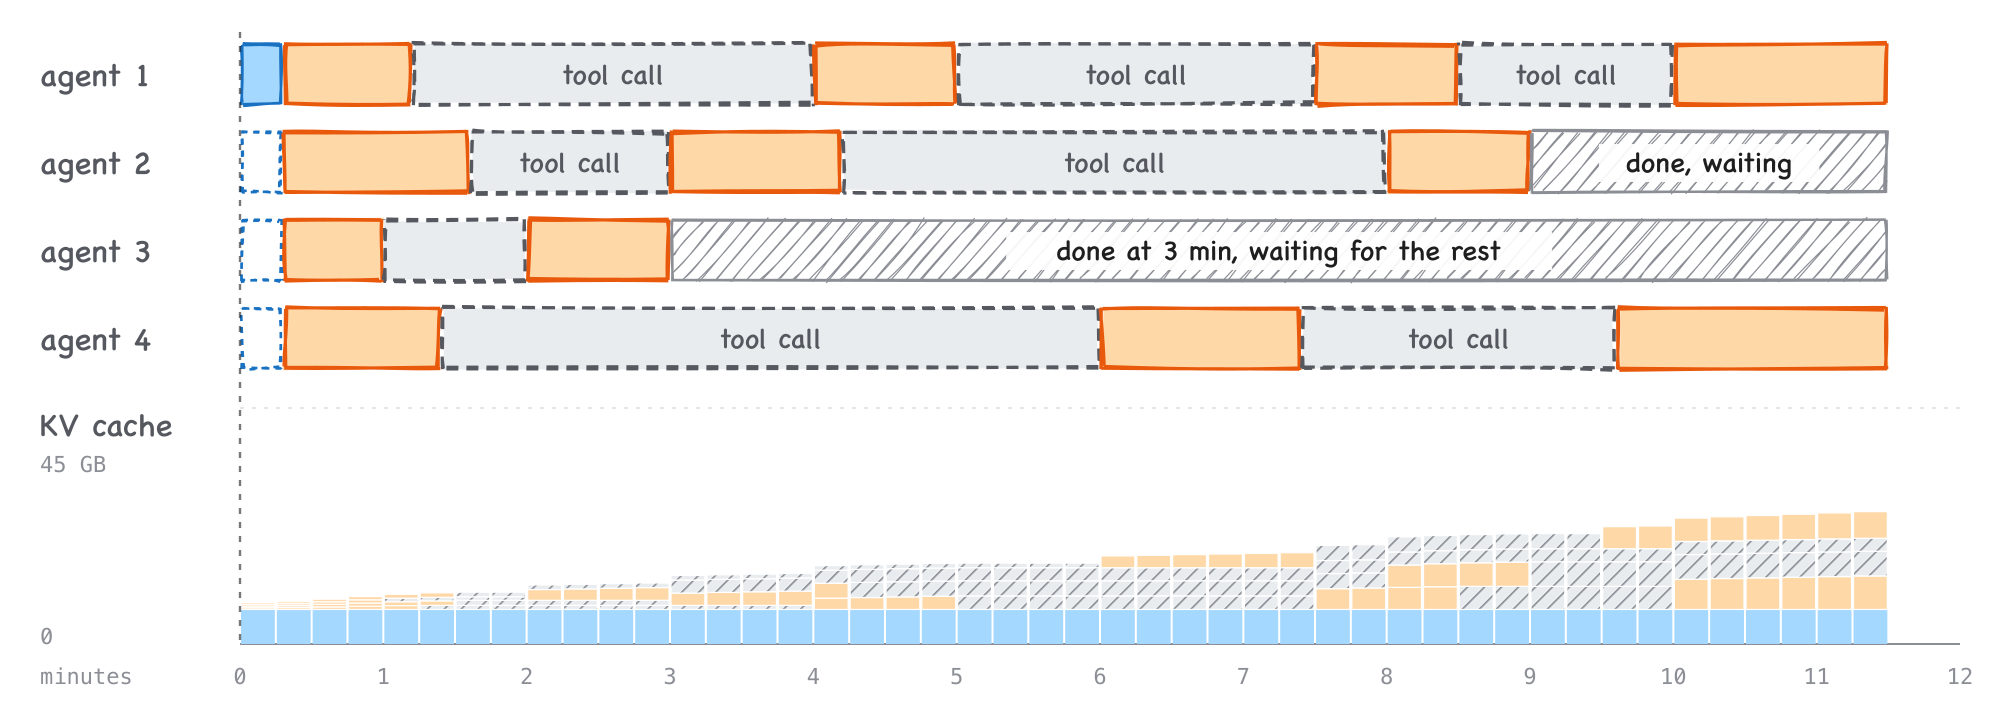
图 2:4 个 Agent 在同一引擎上处理同一个复杂任务的时序图。所有 Agent 均从相同的 20k-token 前缀开始。若引擎支持共享缓存,该前缀在显存中仅需存储一次,Agent 2 至 Agent 4 均可直接命中缓存(虚线 Prefill 框);其余部分则各自分配独立缓存。阴影网格部分的 KV Cache 属于处于空闲状态的 Agent(已完成或正在等待工具调用)。在显存具备剩余槽位的前提下,我们是否可以在此刻调度其他请求进入引擎?
这里的核心挑战在于:设计出能够向 Agent 提供完整且真实交互体验的环境与工作负载。你需要让 Agent 形成 监控 → 优化 → 部署 → 再次监控…… 的完整闭环。
虽然目前已有优秀的团队多 Agent 训练框架(如 Prime Intellect 的 PRIME-RL、清华的 MARTI、AgentJet)并能接入 MultiAgentBench 或 TextArena 等基准,但我尚未发现有哪个环境能够专门针对推理引擎全栈优化提供任务场景,针对多 Agent 推理服务环境的则更是一片空白。
虽然 SemiAnalysis 推出的 InferenceX AgentX 支持将 Agent 流量回放到各类推理引擎(如 vLLM、SGLang、TRT-LLM)中测试,但在我看来,它距离“能够让 Agent 主动调整代码、观测引擎集群效果并循环迭代”的真正 RL 环境,仍有不小的距离。
2. 奖励机制设计(Rewards)
一旦拥有了能够运行真实 Swarm 任务并捕获细粒度系统指标的环境,接下来的问题就是:如何设计强化学习的奖励回路? 首要问题是:应该依靠哪些信号来真实反映 Agent 引入的代码优化与架构变动的实际成效?
通常而言,任何针对引擎的有效优化都必须至少满足以下四大底线不变量:
- 对数概率漂移(Logprob Drift): 必须严格控制在阈值 之内,确保输出分布不失真;
- 任务成功率:Swarm 的端到端任务成功率不得下降(下降幅度不能超过极小值 );
- 请求非正常丢弃率:原本未超时的健康请求不得因为优化而发生丢弃;
- 长尾恢复延迟:p90 与 p99 的恢复延迟(Resume Latency)必须始终满足服务等级目标(SLO)。
在严守上述底线的前提下,我们可以考量一个极具代表性的优化维度:同一个 Swarm 中的各 Agent 请求,究竟应该聚集在同一个引擎实例上,还是打散调度到多个实例上?
Swarm 的 Agent 是集中部署在单副本上以充分利用前缀缓存命中(Prefix Hits),还是分散到不同副本并在节点间转移 KV Cache?这是整个推理调度策略必须权衡的关键指标之一。归根结底,我们需要在首字延迟(TTFT)、Token 间延迟(ITL)、显存占用量以及跨节点 KV 传输耗时之间寻找折中点,而奖励函数必须能够全面量化这些收益与开销。
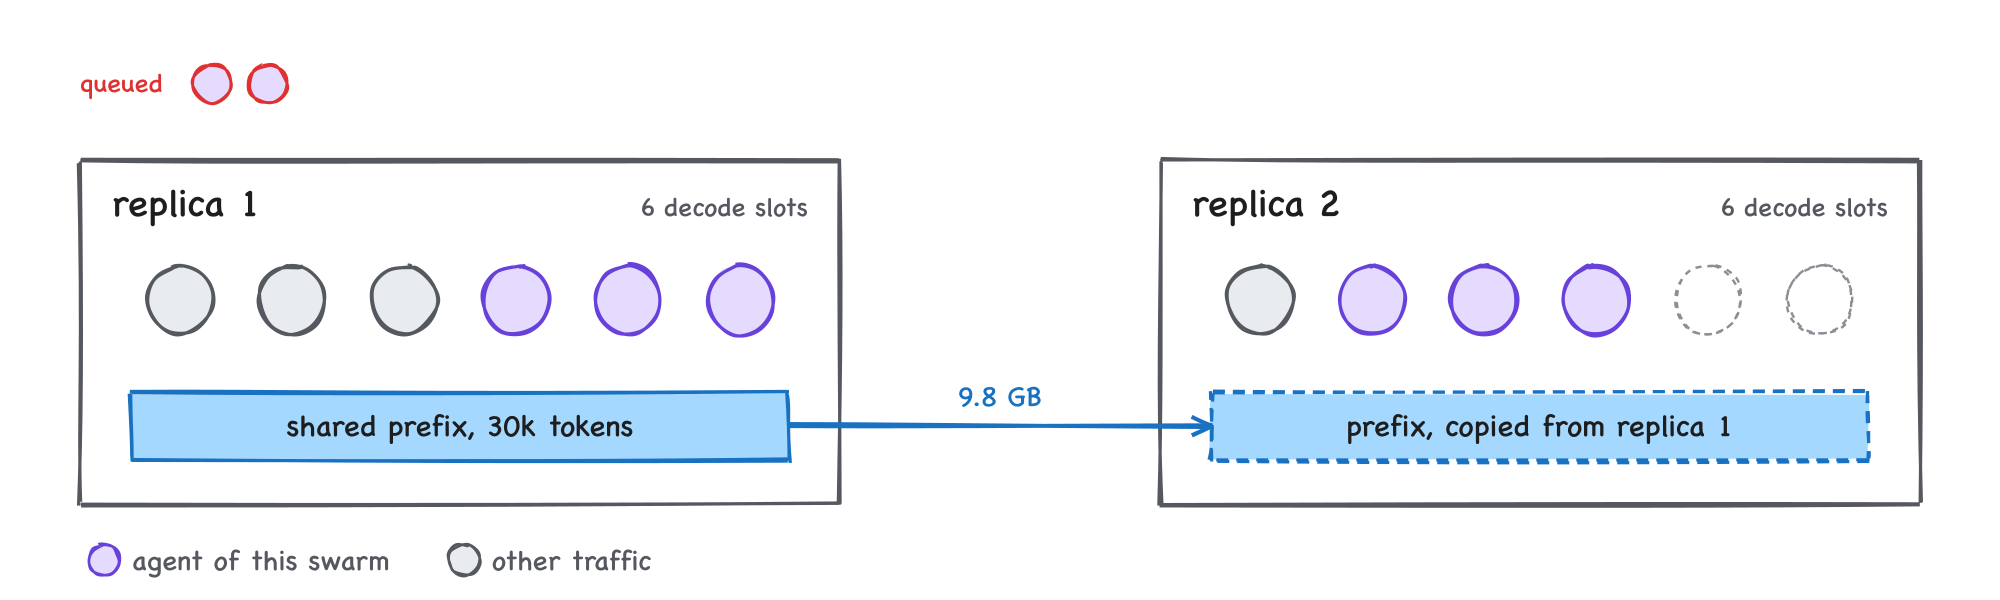
图 3:跨副本放置权衡。8 个共享 30k-token 前缀的 Agent 分配在各具 6 个解码槽位的两个副本上,而外部常规流量已分别占用了副本 1 的 3 个槽位和副本 2 的 1 个槽位。若将所有 Agent 挤在副本 1,无需重新 Prefill 也不产生跨副本传输,但可能引发严重的队列排队;若将部分 Agent 移至副本 2,虽然消除了排队,但副本 2 必须重新计算前缀,或者从副本 1 跨网络拉取 KV Cache。在此示例中,空闲槽位单轮耗时 20 秒,一旦副本过载,耗时将按比例恶化。
为了在多 Agent 协同优化系统中量化这些权衡,细分奖励可以设计如下:
针对负责 KV Cache 管理的 Agent:
- :处于工具调用等待状态的 Agent 所霸占的 KV Cache 显存积分(单位:);
- :重新 Prefill 的 Token 总数(包括工具调用期间 KV 被挤占驱逐导致的重算,以及前缀存在于集群其他节点但当前副本缺失导致的重算)。
针对负责请求路由(Router)的 Agent: 包含上述 ,并引入:
- :在副本之间跨网络搬运的 KV 字节总量;
- :请求在过载副本队列中所消耗的等待时间。
其中各项改进幅度定义为相对原始引擎的相对提升率:
这些模块级细分奖励可以叠加在整个补丁的端到端整体奖励 之上——例如整个 Swarm 完成任务的速度提升幅度,以及同一套集群所能额外承载的 Swarm 并发容量。因此,KV 管理 Agent 获得的最终回报为:
路由 Agent 获得的最终回报为:
这里的一个关键思考在于:权重系数 是否应该在训练过程中逐步退火至 0(Annealed to 0)?这样在训练后期,所有 Agent 将完全以端到端系统性能 为最终导向,而非局限于各自局部步骤的细分指标(这一策略仍有待实验定论)。每个 Agent 的策略 随后最大化其期望收益:
当然,奖励函数的具体数学形态在很大程度上取决于底层集群拓扑、具体应用负载以及引擎架构设计。理清奖励之后,下一步重心就是系统执行性能对策略采样的制约——即轨迹展开(Rollouts)。
3. 轨迹生成与展开(Trajectories and Rollouts)
在大规模场景下,轨迹展开的设计会变得异常棘手。在一条完整的优化轨迹中,Agent 需要经历以下循环:
执行并分析 Profile → 生成代码补丁 → 重新编译执行与分析 → 调整代码 → 再次执行与分析……
直至触发终止条件或耗尽轨迹步数预算。
在此过程中,奖励捕获通常有两种途径:
- 终局奖励:在整条轨迹结束时,依据上述宏观指标统一结算;
- 中间奖励(Intermediate Rewards):对每一个微迭代步即时给出反馈。
以 Cognition 开发的 Kevin(用于编写 CUDA Kernel 的多轮 RL 系统)为例,他们对每一个调优轮次单独打分,并将每个轮次的奖励定义为当前算子得分与后续各步得分的贴现总和:
在他们最终的训练运行中取 。若将此逻辑迁移至推理引擎优化,中间奖励 可来自于本机的轻量回放重放,而最终奖励则由裁判(Judge)在保留的独立评测任务集上给出。
然而,一旦将考察范围从单一算子拓展到整个引擎甚至引擎集群,单条轨迹所耗费的时间就会急剧膨胀。 Kernel 的编译与性能测试通常仅需数秒;而引擎代码的每次更新都需要完整的重启流程——重新加载模型权重、预热执行、捕获 CUDA Graphs 等等。按照这种节奏,一个 GRPO 组(包含 8 条并行展开轨迹)处理单个优化任务可能就需要数小时之久!
我目前仍在推敲这部分的架构细节,但从现有的探索来看,我们必须引入分层评估(Tiered Approach):
- 第一层信号可基于解析模型与光速模型(Speed-of-Light / Roofline),快速对算子级修改与轻量改动进行理论评估;
- 过滤筛选后,再将高潜补丁移入真实的完整执行环境中进行实机基准压测。
此外,实机执行环境必须保持在易于收敛的合理规模:试图在 RL 循环中直接进行整机柜(Rack-Scale)维度的全量调优不仅代价高昂,而且往往并不能提供多于数据并行组(Data Parallel Group)的额外洞察。因此,采用较小规模的模型与精简的分布式世界大小(World Size)更为切实可行,能够支持高频快速迭代。
由于单条轨迹的耗时过长,Trainer 显然无法采用同步等待所有 Rollout 完结的机制——这自然引出了下一块拼图:异步强化学习。
4. 引入异步强化学习(Async RL)
当单条轨迹耗时动辄数小时(在极端情况下可能更长)时,传统的同步 RL 循环已无法工作。除非 Trainer 能够在不必等待所有长尾轨迹(Stragglers)完成的前提下持续前推,否则整个训练流水线将被最慢的一条展开严重拖慢。
虽然此处不深入展开目标函数与底层数学细节,但简而言之,Trainer 参数与 Rollout 采样策略之间的这种**策略分歧(Policy Divergence / Off-policyness)可以通过重要性采样(Importance Sampling)**来进行数学修正。对于超长序列轨迹,PipelineRL 展现出了极佳的适用潜力——它支持在序列生成中途动态更新权重,从而允许生成任务不间断持续推进。
对于引擎优化任务而言,支持长程继续生成是唯一具备工程可行性的路径。至于如何组织这些序列、如何计算损失函数以及如何映射奖励,则属于策略设计的进阶范畴。
最后是轨迹截断(Truncation)与计算预算管理。每条轨迹都必须在预算约束下运行。DeepSWE 给出了一种极具启发性的做法:当轨迹触及最大上下文长度、最大迭代步数或 20 分钟超时阈值时,直接对其损失进行掩码(Mask the Loss)。其核心逻辑在于:系统应当仅在 Agent 主动提交正确方案时赋予奖励;如果对碰运气的偶发通过给予奖励,反而会强化不良策略行为。
因此,在这一量级的轨迹长度下,支持序列中途权重更新的异步架构是唯一可行的工程解法。而更为艰难的挑战并不在系统底层,而在于对探索数据的处理哲学:哪些 Token 应该计入梯度、策略陈旧到何种程度必须舍弃,以及一条被截断的未完成轨迹究竟具备多少学习价值。
5. 结语
归结起来,将推理引擎成功放入 RSI 闭环,关键不在于某一个孤立的技术突破,而在于让以下四大基础支柱严丝合缝地协同运转:
- 真实可执行的环境:能够驱动多 Agent 真实负载,并对正在被动态修改的引擎进行无损测试与度量;
- 端到端鲁棒奖励:既能准确衡量多 Agent 协同产出,又能彻底封堵指标投机(Reward Hacking);
- 低成本展开机制:确保探索轨迹足够轻量,能够以大样本量规模化运行;
- 异步学习流水线:能够包容长达数小时的长程轨迹,并在中途平滑吸收策略更新。
参考文献
- Kimi Team. Kimi K2.5: Visual Agentic Intelligence. arXiv:2602.02276, 2026.
- Prime Intellect. Multi-Agent Systems, 以及 GitHub 仓库 PRIME-RL.
- MARTI: A Framework for Multi-Agent LLM Systems Reinforced Training and Inference. ICLR 2026.
- AgentJet: A Distributed Swarm Training Framework for Agentic Reinforcement Learning. arXiv:2606.04484, 2026.
- MultiAgentBench: Evaluating the Collaboration and Competition of LLM agents. ACL 2025.
- TextArena. arXiv:2504.11442, 2025.
- SemiAnalysis. InferenceX AgentX: Agentic Benchmark for LLM Inference.
- Cognition. Kevin-32B: Multi-Turn RL for Writing CUDA Kernels.
- PipelineRL: Faster On-policy Reinforcement Learning for Long Sequence Generation. arXiv:2509.19128, 2025.
- AReaL: A Large-Scale Asynchronous Reinforcement Learning System for Language Reasoning. arXiv:2505.24298, 2025.